VeRL-Omni v0.2.0: Tăng tốc học tăng cường cho mô hình khuếch tán và ổn định huấn luyện đa phương thức
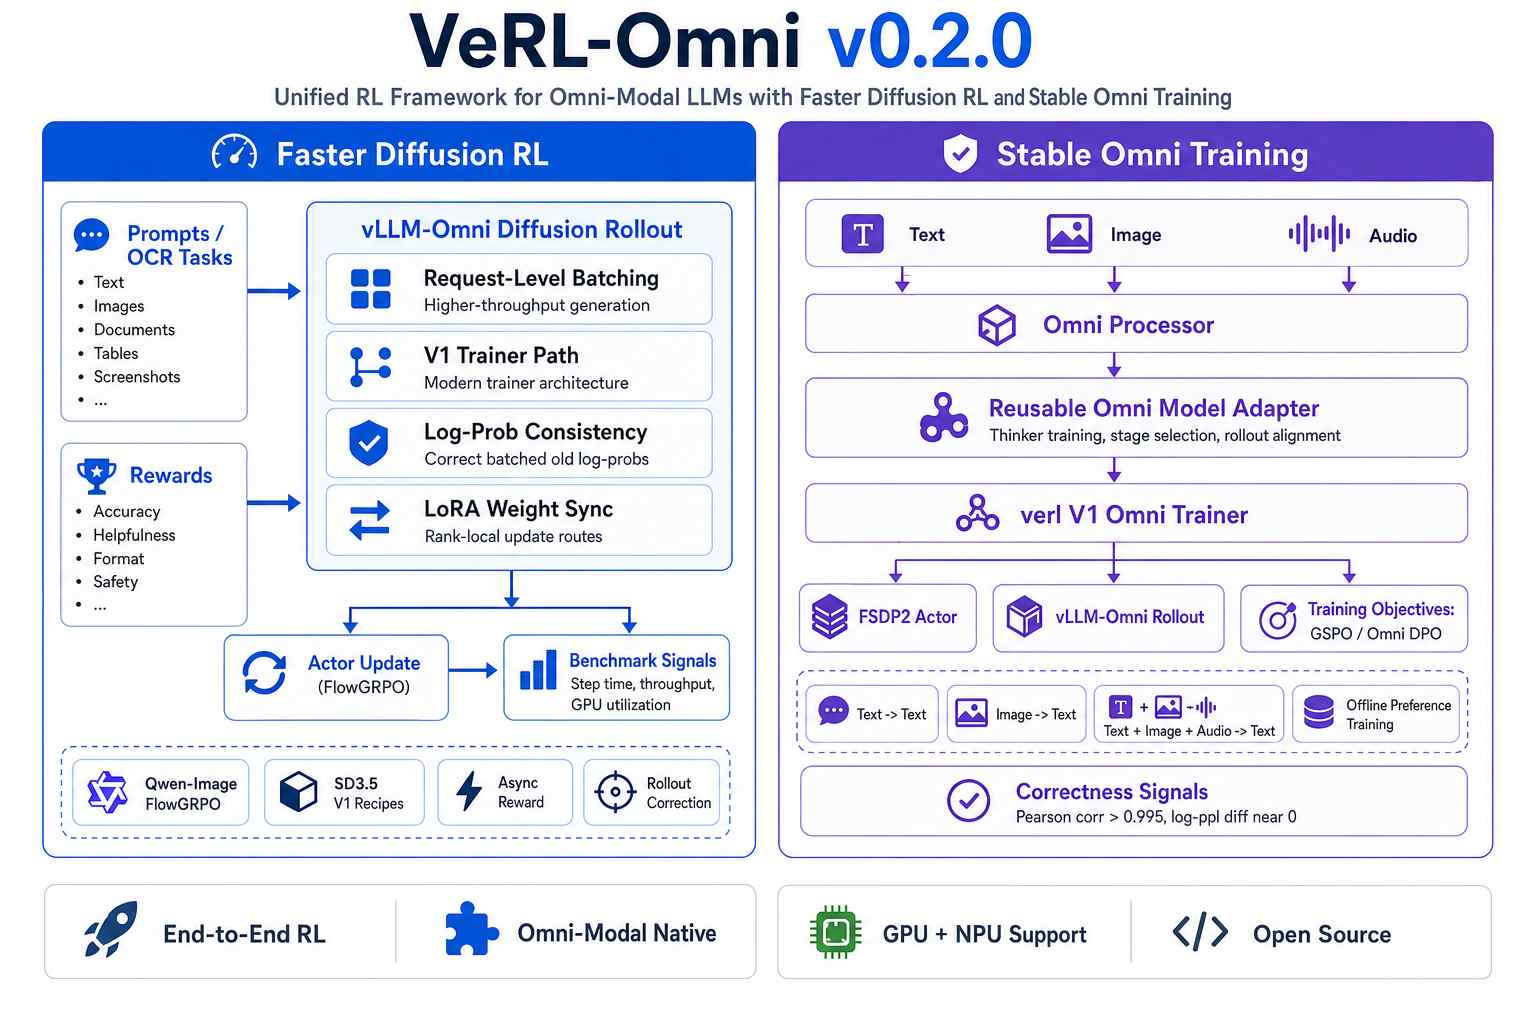
Tiếp nối thông báo hồi tháng 5 về VeRL-Omni, phiên bản v0.2.0 xây dựng nền tảng vững chắc hơn cho việc triển khai học tăng cường đa phương thức trong môi trường sản xuất. Bản phát hành này cải thiện toàn bộ hệ thống huấn luyện, từ tốc độ tạo dữ liệu trải nghiệm, khả năng tích hợp mô hình, hỗ trợ hàm thưởng đến khả năng tương thích phần cứng và tài liệu hướng dẫn.
Hai thay đổi có tác động lớn nhất là:
-
-
-
- Tăng tốc học tăng cường cho mô hình khuếch tán: Nâng cao tốc độ tạo dữ liệu trải nghiệm của Qwen-Image FlowGRPO thông qua vLLM-Omni, đồng thời bổ sung hỗ trợ bộ huấn luyện V1 của VeRL.
- Ổn định quá trình huấn luyện đa phương thức: Phát triển trên nền bộ huấn luyện V1, sử dụng các bộ chuyển đổi mô hình có thể tái sử dụng, FSDP2 và cơ chế tạo dữ liệu trải nghiệm của vLLM-Omni.
-
-
1. Tăng tốc học tăng cường cho mô hình khuếch tán
Học tăng cường cho mô hình khuếch tán đòi hỏi nhiều tài nguyên tính toán, nhưng nguyên nhân gây chậm không hoàn toàn giống với học tăng cường dành cho mô hình ngôn ngữ tự hồi quy. Mỗi lượt tạo dữ liệu trải nghiệm phải thực hiện nhiều bước khử nhiễu, xử lý các tensor biểu diễn tiềm ẩn có kích thước lớn, mã hóa nội dung nhắc lệnh, áp dụng hướng dẫn không cần bộ phân loại nếu được bật, chấm điểm bằng mô hình phần thưởng, tính lại log-xác suất của chính sách cũ và đồng bộ trọng số của chính sách.
Với Qwen-Image FlowGRPO, kết quả phân tích hiệu năng cho thấy không có một thành phần riêng lẻ nào là nguyên nhân duy nhất gây chậm. Thời gian thực hiện mỗi bước phụ thuộc vào nhiều công đoạn phối hợp với nhau, bao gồm tạo dữ liệu trải nghiệm, tính log-xác suất của chính sách cũ, chấm điểm phần thưởng, cập nhật mô hình tác tử và đồng bộ trọng số LoRA.
Các cải tiến chính
Những cải tiến giúp tăng tốc quá trình học tăng cường cho mô hình khuếch tán tập trung vào hai thành phần chính.
-
-
-
- Gom nhiều yêu cầu vào cùng một lượt xử lý: Đây là cải tiến quan trọng ở khâu tạo dữ liệu trải nghiệm. Với các bộ chuyển đổi khuếch tán được hỗ trợ, phương thức này trở thành cơ chế mặc định của vLLM-Omni. Thay vì xử lý từng yêu cầu tạo ảnh theo một vòng lặp tuần tự, hệ thống gom nhiều yêu cầu tương thích vào các lượt truyền xuôi của bộ biến đổi, giúp mỗi lượt xử lý được nhiều dữ liệu hơn. Hệ thống cũng cung cấp các tham số điều khiển mức độ xử lý đồng thời để quản lý lịch thực thi.
- Cải tiến quy trình huấn luyện: Mô hình khuếch tán hiện đã có quy trình huấn luyện V1, đưa phương pháp học tăng cường cho mô hình khuếch tán đến gần hơn với kiến trúc huấn luyện hiện đại được sử dụng trong các thành phần khác của VeRL-Omni. Đây cũng là nền tảng để tách biệt quá trình tạo dữ liệu trải nghiệm khỏi quá trình huấn luyện.
-
-
Tăng tốc khâu tạo dữ liệu trải nghiệm chỉ thực sự có ý nghĩa khi các quỹ đạo tương tác được tạo ra và log-xác suất vẫn phản ánh đúng cùng một chính sách. Trong phiên bản này, một số thành phần quan trọng đối với tính chính xác đã được cải thiện, bao gồm log-xác suất của mô hình khuếch tán khi gom nhiều yêu cầu, ngữ nghĩa của quá trình tạo dữ liệu trải nghiệm bất đồng bộ, cơ chế cập nhật trọng số LoRA theo từng hạng và các điểm móc phục vụ những phương pháp hiệu chỉnh tùy chọn.
Tài liệu hỗ trợ mới
Hướng dẫn gom yêu cầu khi tạo dữ liệu trải nghiệm trình bày hai chế độ gom yêu cầu dành cho mô hình khuếch tán, cách bật từng chế độ và trường hợp nên sử dụng chúng.
Để tìm hiểu thiết kế môi trường thực thi của vLLM-Omni đứng sau cơ chế này, hãy xem tài liệu về gom yêu cầu liên tục cho mô hình khuếch tán.
Hiện tại, các cấu hình học tăng cường cho mô hình khuếch tán được tăng tốc tập trung vào những công thức huấn luyện sau:
| Mô hình và thuật toán | Cơ chế tăng tốc hoặc hỗ trợ | Tệp chạy | Lần chạy W&B |
| Qwen-Image với FlowGRPO LoRA | Gom nhiều yêu cầu vào cùng một lượt xử lý | Tệp chạy | Kết quả W&B |
| Qwen-Image với FlowGRPO, toàn bộ mô hình | Gom yêu cầu liên tục theo từng bước | Tệp chạy | Kết quả W&B |
| SD3.5 Medium với FlowGRPO LoRA, bộ huấn luyện V1 | Gom yêu cầu, chế độ đồng bộ | Tệp chạy | Kết quả W&B |
| SD3.5 Medium với FlowGRPO LoRA, bộ huấn luyện V1 | Gom yêu cầu, chế độ separate_async | Tệp chạy | Kết quả W&B |
Bạn có thể xem bảng đầy đủ về khả năng hỗ trợ các mô hình và thuật toán hậu huấn luyện cho mô hình khuếch tán trong VeRL-Omni tại README.md.
Công thức huấn luyện và kết quả đo hiệu năng
Công thức huấn luyện Qwen-Image LoRA cho bài toán nhận dạng ký tự quang học (OCR) là ví dụ điển hình cho những cải tiến trong phiên bản này.
Ở phiên bản v0.1, khâu tạo dữ liệu trải nghiệm là nút thắt cổ chai chính. Mỗi yêu cầu gần như được xử lý tuần tự bằng các lượt truyền xuôi của DiT với B≈1. Với 10 bước khử nhiễu và True-CFG, mỗi bước cần hai lượt truyền xuôi.
Mức sử dụng GPU chỉ dao động quanh 80%. Nguyên nhân không phải do mô hình quá nhỏ, mà vì bộ máy thực thi chưa thể gom đủ tác vụ khuếch tán vào cùng một thời điểm để tận dụng GPU hiệu quả.
Trong v0.2.0, cơ chế gom yêu cầu của vLLM-Omni thay đổi cách thực thi này. Nhiều yêu cầu tạo ảnh được gom vào cùng một lượt truyền xuôi của bộ biến đổi, giúp mức sử dụng GPU tăng lên khoảng 100%. Thời gian tạo ảnh trong một lần chạy riêng lẻ giảm từ 226s xuống 108s, tương đương giảm 52%.
Thời gian tạo từng ảnh cũng cho thấy xu hướng tương tự khi chuyển sang quy trình tạo dữ liệu trải nghiệm của vLLM-Omni có hỗ trợ gom yêu cầu. Bạn có thể tham khảo các lần chạy tại Qwen-Image OCR LoRA v0.1 và Qwen-Image OCR LoRA v0.2.
Trong các biểu đồ bên dưới, đường màu xanh dương biểu thị v0.1, còn đường màu xanh lá biểu thị v0.2.
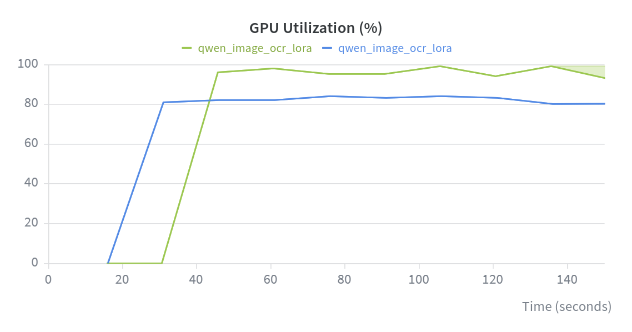
Mức sử dụng GPU tăng sau khi áp dụng cơ chế gom nhiều yêu cầu vào cùng một lượt xử lý. Đường màu xanh dương: v0.1; đường màu xanh lá: v0.2.
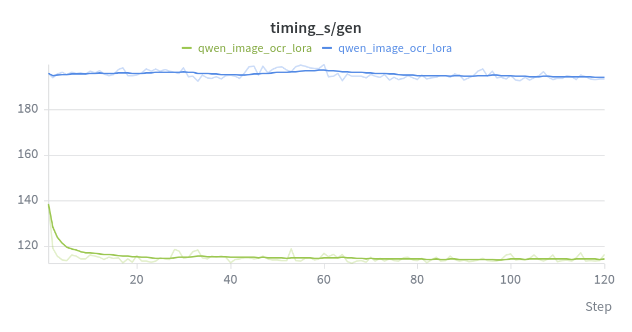
Thời gian tạo ảnh giảm khi chuyển từ quy trình của v0.1 sang quy trình của v0.2. Đường màu xanh dương: v0.1; đường màu xanh lá: v0.2.
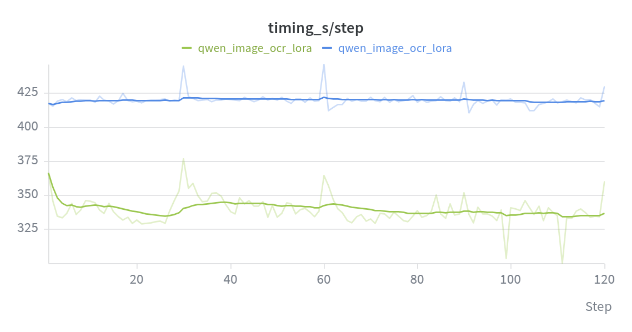
Thời gian thực hiện mỗi bước cũng cho thấy xu hướng cải thiện tương tự. Đường màu xanh dương: v0.1; đường màu xanh lá: v0.2.
Công thức huấn luyện Qwen-Image FlowGRPO LoRA hướng đến môi trường sản xuất, trong đó cơ chế gom yêu cầu của vLLM-Omni được bật theo mặc định. Tệp chạy chính là run_qwen_image_ocr_lora.sh, sử dụng cấu hình phần thưởng OCR cơ bản.
Tốc độ được cải thiện nhờ tắt cơ chế thực thi tuần tự theo từng bước và để bộ máy thực thi vLLM-Omni lên lịch xử lý nhiều yêu cầu tạo dữ liệu trải nghiệm cùng lúc. Số lượng yêu cầu được xử lý đồng thời tối đa được kiểm soát bằng tham số max_num_seqs.
actor_rollout_ref.rollout.step_execution=false
++actor_rollout_ref.rollout.engine_kwargs.vllm_omni.max_num_seqs=32
Với bài toán huấn luyện LoRA cho Qwen-Image có bật True-CFG ở độ phân giải 512 pixel, khoảng giá trị phù hợp để điều chỉnh tham số max_num_seqs= 8 đến 32. Nếu đặt giá trị cao hơn, bộ nhớ băng thông cao (HBM) có thể không đáp ứng đủ nhu cầu. Trong khi đó, SD3.5 cần ít bộ nhớ hơn cho mỗi yêu cầu, nên có thể sử dụng max_num_seqs=256.
Thời gian xử lý mỗi bước trong các cấu hình huấn luyện cũng phù hợp với nhận định này. Khi chạy FlowGRPO LoRA cho Qwen-Image với cấu hình cơ bản trên 4 GPU H800, mỗi bước mất khoảng 420s. Với biến thể sử dụng cơ chế tính phần thưởng bất đồng bộ, thời gian giảm còn khoảng 360s mỗi bước trên 5 GPU.
2. Ổn định quá trình huấn luyện đa phương thức
Phần còn lại của bản phát hành tập trung vào việc nâng cao độ ổn định khi huấn luyện các mô hình Omni. Đây không đơn thuần là những mô hình ngôn ngữ lớn hơn. Chúng là các hệ thống gồm nhiều thành phần phối hợp với nhau, như bộ xử lý dữ liệu, mô-đun chuyên biệt cho từng loại dữ liệu, các thành phần có thể huấn luyện và cơ chế tạo dữ liệu trải nghiệm. Tất cả phải hoạt động nhất quán với mô hình tác tử (actor).
Trong phiên bản v0.2.0, dự án từng bước chuyển từ cách tích hợp riêng cho từng mô hình sang một hệ thống huấn luyện Omni có thể tái sử dụng. Nhờ đó, quá trình huấn luyện mô hình tự hồi quy đa phương thức được tích hợp chặt chẽ hơn vào cấu trúc bộ huấn luyện, bộ chuyển đổi mô hình, quy trình tạo dữ liệu trải nghiệm và các cấu hình huấn luyện của VeRL-Omni.
Các cải tiến chính
Bản phát hành này tập trung cải thiện hai thành phần.
Thứ nhất là kiến trúc bộ huấn luyện V1 của verl. Các cấu hình huấn luyện Omni có cách điều phối các tiến trình thực thi rõ ràng hơn, hỗ trợ ghi đè cấu hình theo quy ước chung và phối hợp tốt hơn với cơ chế tạo dữ liệu trải nghiệm của vLLM-Omni.
Thứ hai là lớp bộ chuyển đổi mô hình Omni có thể tái sử dụng. Thay vì phải tích hợp riêng từng kiến trúc theo một quy trình độc lập, bộ huấn luyện có thể sử dụng chung một giao diện để thiết lập mô hình, cấu hình bộ xử lý, lựa chọn các thành phần cần huấn luyện, chuẩn bị FSDP và đồng bộ với quá trình tạo dữ liệu trải nghiệm.
Luồng gọi giữa các thành phần trong mã nguồn có thể khái quát như sau:
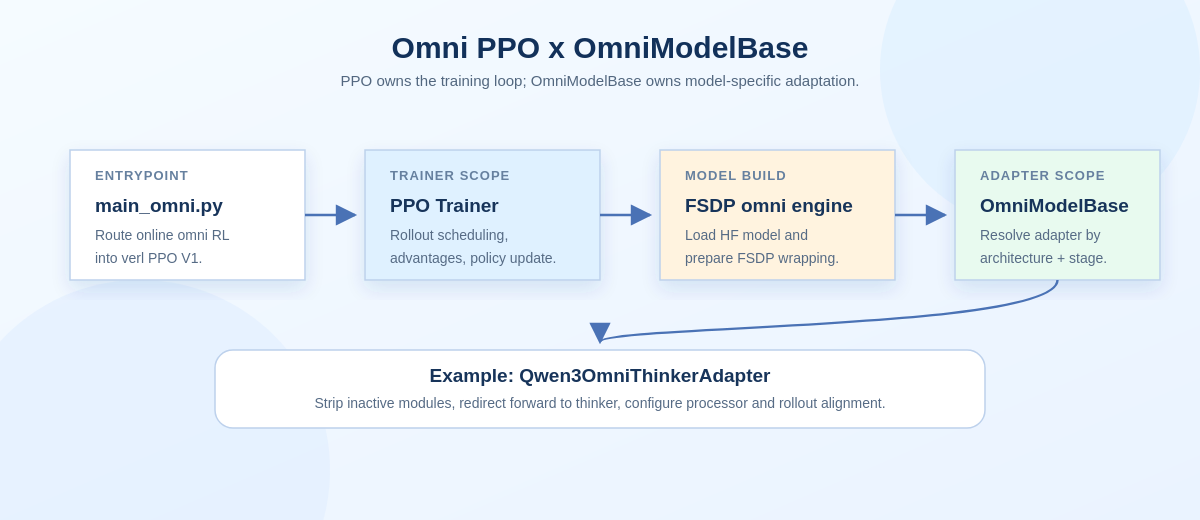
Ranh giới giữa các mô-đun được giữ ở mức gọn và rõ ràng. Tệp main_omni.py chỉ xác định rằng một tác vụ Omni trực tuyến cần sử dụng luồng huấn luyện PPO V1 của verl. Sau đó, bộ huấn luyện PPO đảm nhiệm vòng lặp học tăng cường dùng chung, bao gồm lập lịch tạo dữ liệu trải nghiệm, tính toán lợi thế (advantage) và cập nhật chính sách.
Khi khởi tạo mô hình tác tử, bộ máy Omni sử dụng FSDP sẽ tải mô hình từ Hugging Face, sau đó yêu cầu OmniModelBase xác định bộ chuyển đổi phù hợp với kiến trúc và giai đoạn huấn luyện đã cấu hình. Những xử lý riêng cho từng mô hình được đặt trong bộ chuyển đổi này.
Ví dụ, khi huấn luyện thành phần thinker của Qwen3-Omni, Qwen3OmniThinkerAdapter loại bỏ các mô-đun không hoạt động, chuyển lời gọi forward sang thành phần thinker và chuẩn bị bộ xử lý cùng các hàm móc để đồng bộ với quá trình tạo dữ liệu trải nghiệm. Sau đó, quyền điều khiển được trả về vòng lặp PPO để tiếp tục huấn luyện.
Các mô hình và cấu hình mới được hỗ trợ
Bộ chuyển đổi Qwen3-Omni hiện hỗ trợ huấn luyện riêng thành phần thinker bằng cách chuyển quá trình huấn luyện sang đúng thành phần mục tiêu, loại bỏ những mô-đun không cần thiết như Talker và các thành phần liên quan đến bộ mã hóa, giải mã âm thanh. Cơ chế này đồng thời tương thích với phương pháp đóng gói mô hình FSDP và FSDP2.
Các cấu hình huấn luyện Omni hiện tập trung vào những công thức huấn luyện sau:
| Mô hình và thuật toán | Loại dữ liệu và tập dữ liệu | Khả năng hỗ trợ | Tệp chạy | Kết quả W&B |
| Qwen3-Omni Thinker × GSPO | Văn bản → văn bản / GSM8K | Bộ huấn luyện V1, bộ chuyển đổi Omni có thể tái sử dụng, FSDP2, tạo dữ liệu trải nghiệm bằng vLLM-Omni | Tệp chạy | Kết quả W&B |
| Qwen3-Omni Thinker × GSPO | Hình ảnh → văn bản / MMK12 | Bộ huấn luyện V1, dữ liệu đa phương thức, kiểm tra tính nhất quán giữa mô hình tác tử và quá trình tạo dữ liệu trải nghiệm | Tệp chạy | Kết quả W&B |
| Qwen3-Omni Thinker × GSPO | Văn bản + hình ảnh + âm thanh → văn bản / AVQA-R1-6K | Bộ huấn luyện V1, cấu hình dành cho NPU, đầu vào đa phương thức | Tệp chạy | Chưa có |
| Qwen3-Omni Thinker × DPO | Đa phương thức → dữ liệu ưu tiên / Omni-Preference | OmniDPOLoss, gom nhóm lô dữ liệu theo loại phương thức |
Tệp chạy | Báo cáo W&B |
Bạn có thể xem bảng đầy đủ về các mô hình và thuật toán được hỗ trợ trong giai đoạn hậu huấn luyện Omni tại README.md.
Công thức huấn luyện và kết quả đánh giá
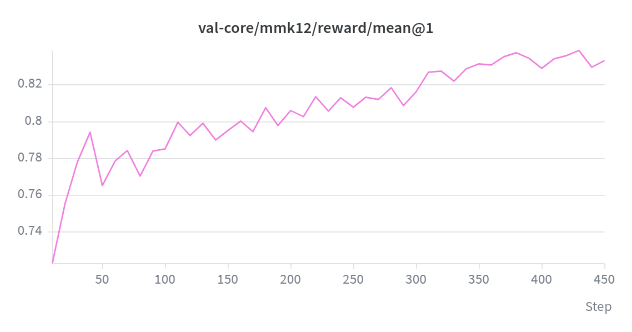
Trong số các cấu hình được giới thiệu, MMK12 là một ví dụ tiêu biểu. Cấu hình này kiểm chứng quy trình huấn luyện Qwen3-Omni mới bằng dữ liệu đa phương thức thực tế: đầu vào gồm hình ảnh và câu lệnh văn bản, đầu ra là câu trả lời bằng văn bản. Mô hình được tối ưu bằng GSPO, huấn luyện thành phần tác tử với FSDP và tạo dữ liệu trải nghiệm bằng vLLM-Omni.
Cấu hình huấn luyện MMK12 tiêu biểu
Tệp run_qwen3_omni_thinker_gspo_lora_mmk12_v1.sh dùng để huấn luyện Qwen3-Omni thực hiện suy luận toán học trực quan ở cấp tiểu học và trung học cơ sở trên tập dữ liệu MMK12 (image -> text). Cấu hình sử dụng GSPO, LoRA với hạng 32 và các tiến trình tạo dữ liệu trải nghiệm, huấn luyện tác tử chạy cùng máy trên 4 GPU H800 80 GB.
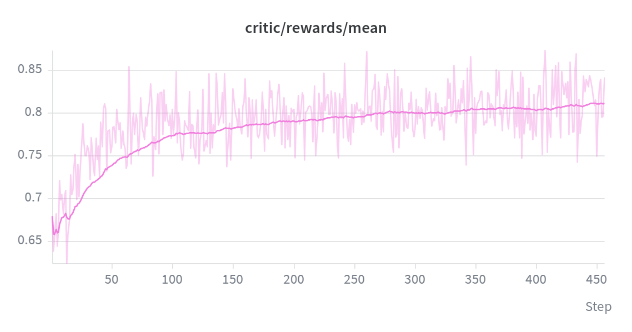
Mỗi đợt tạo dữ liệu trải nghiệm gồm 128 câu lệnh, mỗi câu lệnh tạo ra 16 câu trả lời, tương đương 2.048 mẫu trong một đợt. Sau huấn luyện, mô hình đạt điểm thưởng trên tập kiểm định là 0.833, hệ số tương quan Pearson giữa mô hình tác tử và quá trình tạo dữ liệu trải nghiệm là 0.998, đồng thời sử dụng khoảng 59 GB bộ nhớ GPU.
Bạn có thể xem kết quả huấn luyện tại lần chạy tham chiếu MMK12 trên W&B.
Quy trình xử lý dữ liệu MMK12 chuyển các phân mảnh Parquet thô thành định dạng Parquet phục vụ học tăng cường của verl. Mỗi dòng dữ liệu chứa trực tiếp dữ liệu hình ảnh dưới dạng byte và sử dụng định dạng câu lệnh yêu cầu mô hình tạo câu trả lời có cấu trúc.
Hàm tính điểm thưởng kết hợp độ chính xác được đánh giá bằng math_verify với điểm thưởng định dạng tăng dần, dựa trên mẫu <answer>...\boxed{}...</answer>.
Để chạy cấu hình huấn luyện này:
python examples/gspo_trainer/data_process/mmk12.py \
    --local_dataset_path /path/to/mmk12/ \
    --local_save_dir ~/data/mmk12

TRAIN_FILE=$HOME/data/mmk12/train.parquet \
VAL_FILE=$HOME/data/mmk12/test.parquet \
bash examples/gspo_trainer/qwen3_omni/run_qwen3_omni_thinker_gspo_lora_mmk12_v1.sh
Điều này cho thấy những cải tiến về độ ổn định trong phiên bản v0.2.0: quá trình huấn luyện Qwen3-Omni không còn phụ thuộc vào một quy trình khởi chạy riêng cho từng mô hình. Thay vào đó, dự án cung cấp cấu hình huấn luyện dựa trên bộ huấn luyện V1, bộ chuyển đổi Omni có thể tái sử dụng, khả năng xử lý dữ liệu đa phương thức, các chỉ số kiểm tra mức độ nhất quán giữa mô hình tác tử và quá trình tạo dữ liệu trải nghiệm, cùng kết quả đánh giá được ghi lại cho tác vụ chuyển hình ảnh thành văn bản.
Mở rộng hỗ trợ mô hình và thuật toán
Bản phát hành này cũng mở rộng phạm vi hỗ trợ mô hình và thuật toán của VeRL-Omni:
| Mô hình hoặc dòng mô hình | Phân loại | Dữ liệu đầu vào và đầu ra | Thuật toán hoặc cấu hình huấn luyện | Nội dung cập nhật |
| LTX2.3 | Mô hình tạo sinh khuếch tán | Văn bản → video và âm thanh | FlowGRPO | Bổ sung khả năng huấn luyện tạo video kèm âm thanh từ văn bản, sử dụng CLAP và ImageBind làm mô hình tính điểm thưởng. |
| Qwen-Image-Edit | Mô hình chỉnh sửa hình ảnh bằng khuếch tán | Văn bản và hình ảnh → hình ảnh | FlowGRPO | Bổ sung quy trình chuẩn bị dữ liệu chỉnh sửa hình ảnh và giao diện huấn luyện dùng chung. |
| BAGEL | Mô hình kết hợp khả năng hiểu và tạo sinh | Văn bản và hình ảnh | FlowGRPO | Bổ sung cấu hình huấn luyện toàn bộ tham số và LoRA, sử dụng điểm thưởng từ nhận dạng ký tự quang học (OCR) và PickScore. |
| SD3.5 + DiNa-LRM | Mô hình tạo sinh khuếch tán | Văn bản → hình ảnh | FlowGRPO với mô hình tính điểm thưởng trên không gian tiềm ẩn | Tính điểm trực tiếp trên các tensor tiềm ẩn đã khử nhiễu, không cần giải mã qua bộ tự mã hóa biến phân (VAE) khi tính điểm thưởng. |
| Flow-DPPO | Thuật toán dành cho mô hình khuếch tán | Văn bản hoặc hình ảnh → hình ảnh | Flow-DPPO | Bổ sung một phương pháp tối ưu hóa chính sách khác cho các tác vụ học tăng cường với mô hình khuếch tán, chẳng hạn như Qwen-Image. |
| Wan2.2 | Mô hình tạo video bằng khuếch tán | Văn bản → video | DanceGRPO | Bổ sung cấu hình học tăng cường cho tác vụ tạo video. |
Ngoài việc mở rộng danh mục mô hình và thuật toán, phiên bản v0.2.0 còn bổ sung tệp Dockerfile dành cho bộ xử lý thần kinh chuyên dụng Ascend (NPU), kèm hướng dẫn cài đặt.
Kế hoạch phát triển tiếp theo
-
-
-
- Tối ưu hóa các mô hình đa phương thức bằng quy trình huấn luyện hoàn toàn bất đồng bộ.
- Mở rộng hỗ trợ các mô hình và thuật toán mới, chẳng hạn như MiniMax-H3, các mô hình MiniCPM-o và bộ huấn luyện OPD/M-OPD.
- Nâng cao hiệu quả huấn luyện mô hình khuếch tán video thông qua cơ chế gom nhóm yêu cầu, TQ và bộ huấn luyện V1.
- Tăng độ ổn định của mã nguồn xử lý quá trình tạo dữ liệu trải nghiệm cho mô hình khuếch tán và mô hình đa phương thức, đáp ứng yêu cầu huấn luyện bất đồng bộ.
- Hỗ trợ học tăng cường cho tác tử AI có khả năng tạo nội dung qua nhiều giai đoạn và tương tác qua nhiều lượt.
-
-
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI tính phí theo từng phút sử dụng, minh bạch và không có phí ẩn. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.