Lần theo điểm nghẽn: Tối ưu MiniMax M3 trên AMD Instinct MI355X
Bài viết hỗ trợ MiniMax M3 ngay từ ngày đầu đã giới thiệu bản triển khai vLLM đầu tiên hoạt động được: MiniMax Sparse Attention (MSA), đầu vào đa phương thức, đầu ra suy luận và công cụ, trọng số MXFP8 và EAGLE3 trên AMD Instinct MI355X.
Bài viết tiếp theo này tập trung vào những gì xảy ra sau khi mô hình đã chạy được. Kết quả đáng chú ý không chỉ là một con số thông lượng cao hơn, mà còn là một cách xác định nên tối ưu phần nào tiếp theo khi điểm nghẽn liên tục thay đổi vị trí.
Kết quả trong một phút
Các kết quả công khai từ phép đo InferenceX của SemiAnalysis cho thấy MiniMax-M3 hiện đạt được những mức sau trên AMD Instinct MI355X:
-
-
-
- Ở mức đồng thời 32, cấu hình phục vụ tiêu chuẩn MXFP8 với cấu trúc cố định tăng từ 109,1 lên 342,4 token đầu ra/giây/GPU, tức gấp 3,14 lần kết quả ngày đầu. TTFT trung vị giảm từ 1,46 xuống 0,67 giây, còn TPOT trung bình giảm từ 69,1 xuống 22,1 mili giây.
- Ở mức đồng thời 128, cùng đường xử lý TP4/EP1 trên bốn GPU tăng từ 297,8 lên 623,7 token đầu ra/giây/GPU, tức gấp 2,09 lần. TTFT trung vị giảm từ 3,53 xuống 1,54 giây, còn TPOT trung bình giảm từ 100,7 xuống 48,8 mili giây.
- MXFP4 ban đầu tăng từ 212,1 lên 716,8 token đầu ra/giây/GPU ở mức đồng thời 128, với cùng cấu hình TP4/EP1 trên bốn GPU. Sau đó, kết quả với TP2/EP1 đạt 943,5 token đầu ra/giây/GPU, cao hơn 31,6% so với mốc TP4 trước đó và gấp 4,45 lần kết quả ban đầu tính trên mỗi GPU.
- Khi bổ sung giải mã suy đoán EAGLE3, đạt 682,4 token đầu ra/giây/GPU ở mức đồng thời 128 với TP4/EP1.
- Khi bổ sung tách rời P/D và điều chỉnh lại cấu trúc phục vụ nạp đầu vào/giải mã, đạt 6.370,5 token/giây/GPU tổng cộng ở mức đồng thời 512, với TTFT trung vị 1,32 giây.
-
-
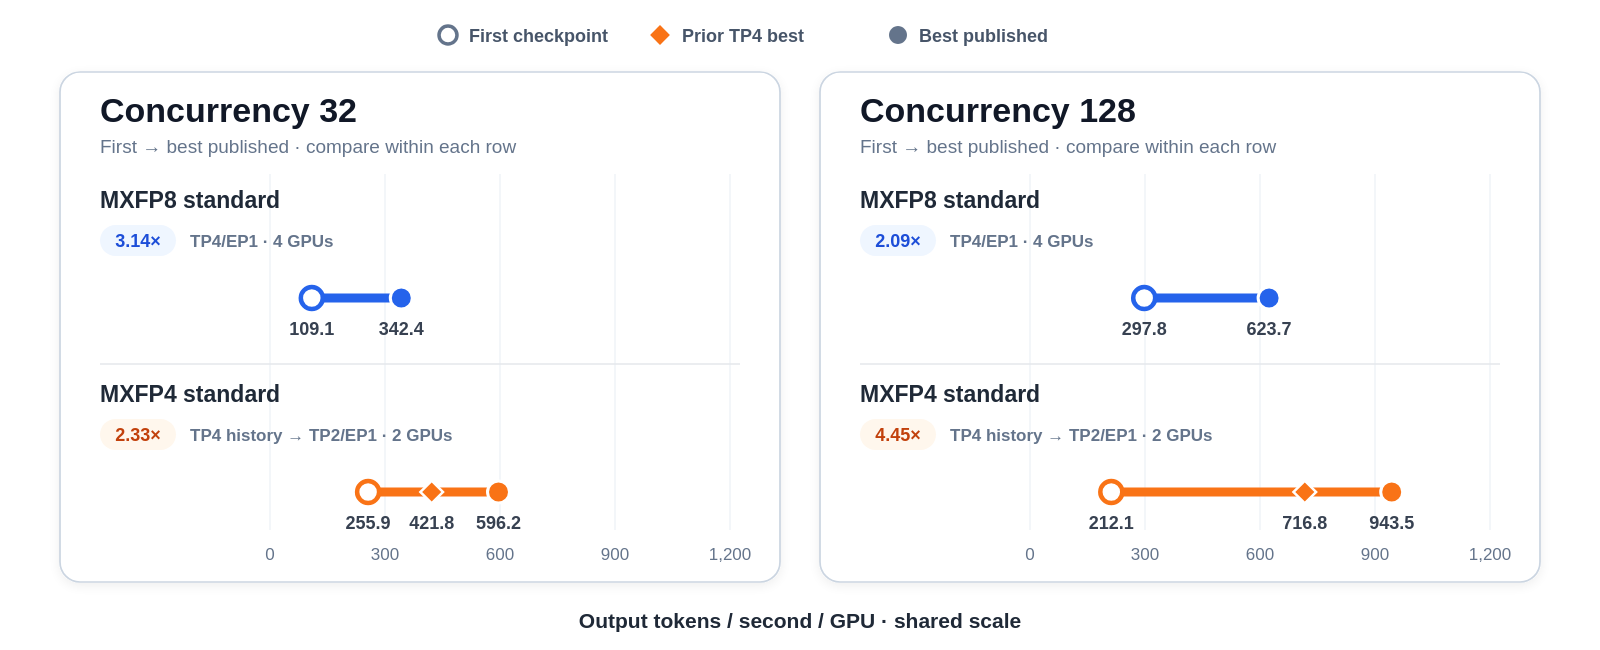
Hình 1. Giải mã tiêu chuẩn với 8K token đầu vào và 1K token đầu ra. So sánh các điểm trong cùng một hàng. MXFP8 luôn sử dụng TP4/EP1; điểm MXFP4 cuối cùng chuyển từ TP4 sang TP2, vì vậy nó thể hiện mật độ triển khai cao hơn chứ không phải mức tăng tốc khi giữ nguyên cấu trúc.
Mỗi mốc kết quả là kết quả tích lũy và có thể bao gồm nhiều thay đổi cùng lúc. Các phần dưới đây sử dụng số liệu đo từ từng PR riêng lẻ để giải thích từng tối ưu cụ thể.
Một bước giải mã, năm câu hỏi
Công việc tối ưu tuân theo một quy trình quen thuộc: ước tính những chi phí chiếm phần lớn thời gian, đo thực tế, gom những phần việc lặp lại, tính trước những giá trị không thay đổi, rồi chuyển lên tầng cao hơn khi các phép đo ở tầng thấp không còn cho thấy điểm nghẽn rõ ràng.
MiniMax M3 có 60 lớp giải mã; 57 lớp sử dụng MoE thưa và cơ chế chú ý thưa. Với một phản hồi dài 1K token, một chi phí nhỏ ở mỗi lớp có thể xuất hiện hàng chục nghìn lần trong một yêu cầu. Vì vậy, năm câu hỏi sau đặc biệt hữu ích:
-
-
-
- Hình dạng dữ liệu cục bộ nào thực sự được đưa đến hạng này?
- Phần việc nào lặp lại ở mỗi lớp hoặc mỗi token?
- Có bao nhiêu byte phải di chuyển, và liệu có thể chỉ di chuyển thông tin mô tả thay thế hay không?
- Đường xử lý nhanh có thực sự được sử dụng, với đúng phép tính dự kiến hay không?
- Khi các hạt nhân không còn là điểm nghẽn chính, hàng đợi nào đang dài lên?
-
-
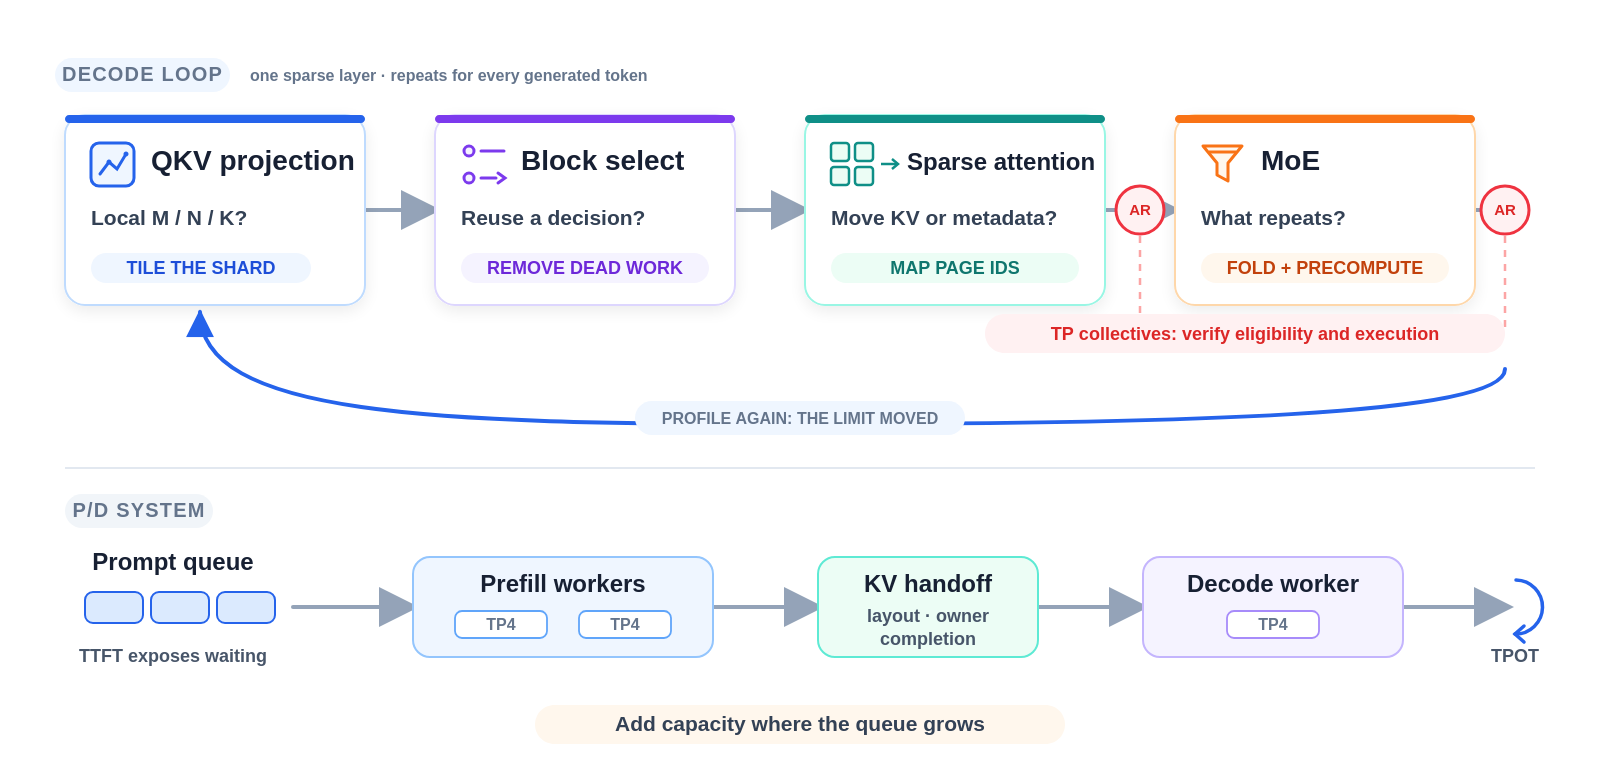
Hình 2. Dải phía trên theo dõi một lớp giải mã thưa theo đúng thứ tự thực thi; AR đánh dấu các phép tập hợp TP sau cơ chế chú ý và MoE. Dải phía dưới áp dụng cùng cách suy luận cho P/D: trước tiên kiểm tra việc chuyển giao KV, sau đó bổ sung năng lực xử lý tại nơi các yêu cầu đang phải chờ.
Phần còn lại của bài viết trả lời năm câu hỏi này bằng mã nguồn và số liệu đo hiệu năng.
1. Hình dạng dữ liệu nào thực sự được đưa đến hạng này?
Sơ đồ mô hình thường thể hiện các kích thước tổng thể, nhưng các hạt nhân lại chạy trên M, N và K cục bộ sau khi áp dụng song song tensor, sao chép đầu, đệm và phân phối token. Với TP8, 64 đầu truy vấn của MiniMax M3 được chia thành tám đầu cho mỗi hạng, trong khi bốn đầu KV và bốn đầu chỉ mục được sao chép để mỗi hạng có một đầu. Vì vậy, phép chiếu QKV hợp nhất nhìn thấy N=1536 ở mỗi hạng, chứ không phải kích thước N toàn cục chia cho tám.
Nạp đầu vào và giải mã cũng tạo ra các giá trị M khác nhau. Nạp đầu vào xử lý nhiều token cùng lúc, trong khi giải mã thường chỉ có vài hàng. vLLM #45725 chia bộ khởi chạy thành hai trường hợp có M lớn và M nhỏ, giúp thông lượng đầu ra TP8 với khối lượng công việc 8K/1K tăng 7,8%–9,4%. Sau đó, vLLM #46117 chọn các ô tính toán dựa trên toàn bộ hình dạng cục bộ: các ô N hẹp hơn giúp lộ ra nhiều phần việc độc lập hơn trong quá trình giải mã, trong khi bước K lớn hơn làm giảm số vòng lặp. Khi nạp đầu vào, hệ thống sử dụng các ô rộng hơn vì M vốn đã cung cấp đủ mức song song.
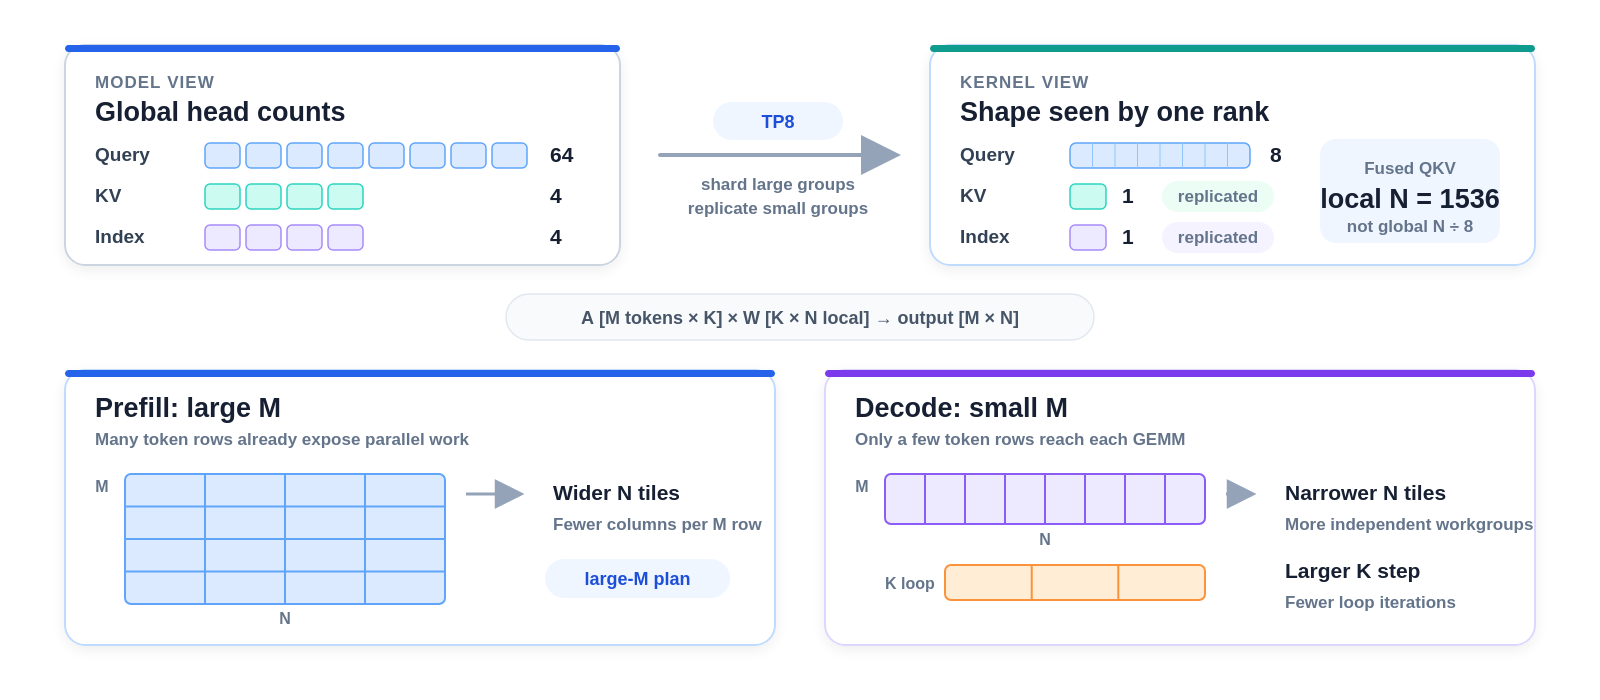
Hình 3. Việc chia nhỏ TP và sao chép đầu quyết định N cục bộ; giai đoạn phục vụ quyết định M. Bộ khởi chạy chọn các ô tính toán dựa trên hình dạng thực tế mà từng hạng phải xử lý.
PR này đồng thời sắp xếp lại các chương trình MoE theo nhóm để những chương trình nằm gần nhau có thể tái sử dụng các hàng kích hoạt và các ô trọng số chuyên gia đã có trong bộ nhớ đệm GPU, thay vì phải lấy lại chúng từ HBM. Trong các phép thử từ đầu đến cuối với TP4, những thay đổi kết hợp này mang lại mức tăng 1,08–1,46 lần. Lợi ích lớn nhất xuất hiện ở mức đồng thời thấp, khi cách khởi chạy ban đầu có ít phần việc song song nhất.
Hình dạng cục bộ cũng quyết định bộ phụ trợ nào có thể sử dụng. Đường xử lý chú ý thưa AITER được dùng trong cấu hình MXFP8 cuối cùng yêu cầu mỗi hạng TP có một đầu KV. TP4 đáp ứng điều kiện này. TP2 sử dụng đường dự phòng Triton của vLLM. Vì vậy, thay đổi TP không chỉ làm thay đổi kích thước phép tập hợp dữ liệu; nó còn có thể làm thay đổi cả chuỗi toán tử được thực thi.
Cũng không có bộ phụ trợ nào luôn nhanh nhất. InferenceX #2003 ban đầu chọn bộ phụ trợ tuyến tính mô phỏng cho toàn bộ loạt phép thử. Các phép đo sau đó trong InferenceX #2187 cho thấy bộ phụ trợ tuyến tính MXFP8 nguyên bản nhanh hơn ở mức đồng thời thấp và trung bình, trong khi cách mô phỏng chỉ nhanh hơn ở các lần chạy có đầu vào dài và mức đồng thời cao. Cơ chế chú ý thưa theo trang cũng có điểm chuyển tương tự. Cấu hình cuối cùng chỉ bật cả hai ở đầu vào 8K khi mức đồng thời từ 64 trở lên.
Đó là bài học có thể áp dụng đầu tiên: hãy tối ưu và chọn đường xử lý dựa trên phân bố hình dạng thực tế mà hệ thống đang chạy. “Nạp đầu vào”, “giải mã” hay “TP4” chỉ là những nhãn mô tả, không phải bản thân hình dạng dữ liệu.
2. Phần việc nào lặp lại?
Chi phí lặp lại đầu tiên rất dễ bị bỏ qua là chi phí khởi chạy. Cấu hình ngày đầu thực hiện các phép tính một cách trực tiếp. InferenceX #1754 và #1755 bật thực thi theo đồ thị cho việc phục vụ tiêu chuẩn và EAGLE3. Thay đổi này là một phần trong lịch sử tối ưu tích lũy, dù các kết quả đã công bố không tách riêng mức cải thiện của nó.
Cải thiện lớn hơn về mặt cấu trúc đến từ chuyên gia dùng chung. Ban đầu, mỗi lớp MoE thưa chạy chuyên gia dùng chung như một MLP đặc riêng: phép chiếu gate/up, hàm kích hoạt, phép chiếu down, lưu trữ kết quả trung gian và phép cộng. Các phép tính này là cần thiết. Nhưng việc tách riêng đường xử lý thì không.
vLLM #46545 đưa chuyên gia dùng chung vào cùng bảng với các chuyên gia được định tuyến và chọn chuyên gia này cho mọi token. Các phép GEMM theo nhóm sau đó xử lý cả chuyên gia được định tuyến lẫn chuyên gia dùng chung trong cùng một lượt. Cách này loại bỏ các lần khởi chạy và lượng dữ liệu trung gian phải di chuyển mà không làm giảm số phép tính dấu phẩy động của mô hình. Thông lượng đầu ra tăng 30,2% ở mức đồng thời 1 và 5,6% ở mức đồng thời 128. Mức cải thiện giảm dần là một bằng chứng hữu ích: đó chính là biểu hiện của việc chi phí khởi chạy được phân bổ dần cho nhiều phần việc hơn.
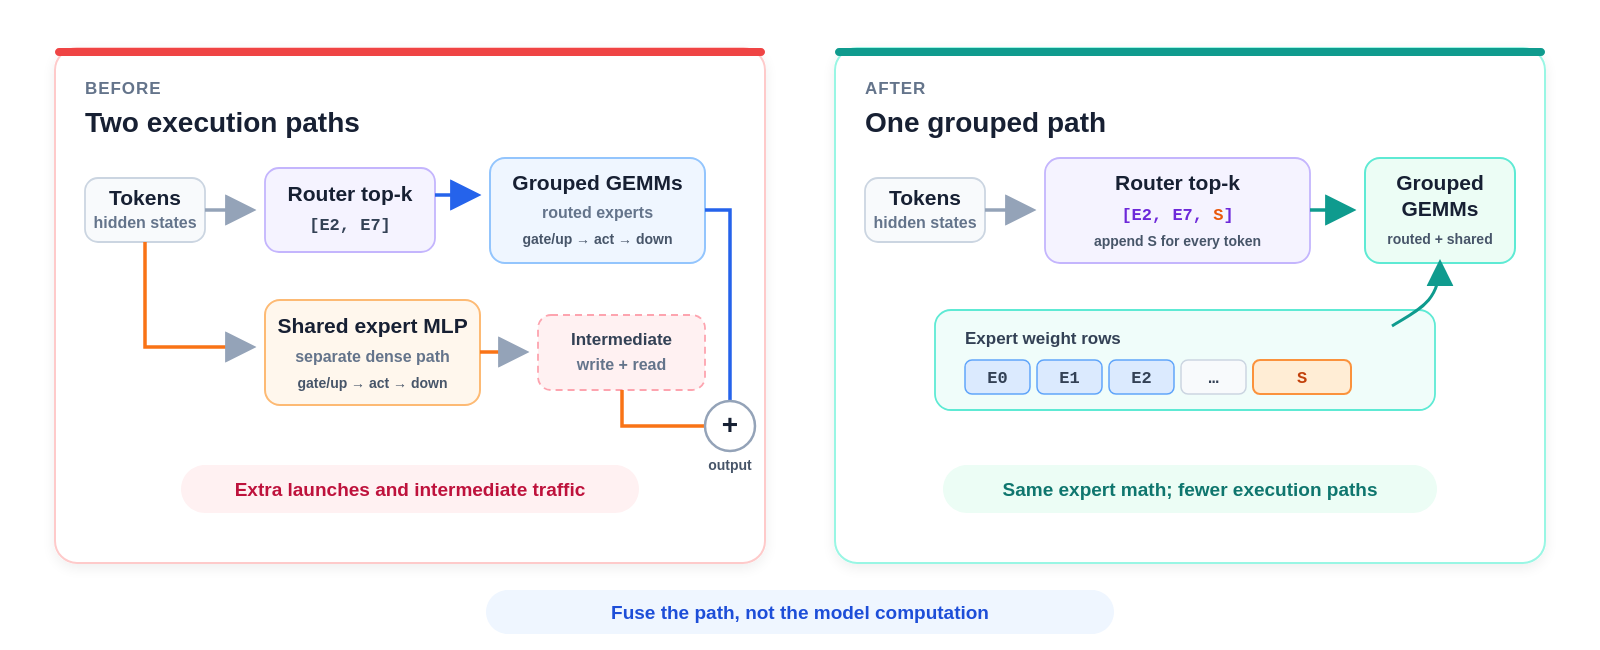
Hình 4. Việc hợp nhất đưa chuyên gia dùng chung vào cùng bảng với một vị trí mà mọi token đều chọn. Các chuyên gia được định tuyến và chuyên gia dùng chung sau đó sử dụng chung các phép GEMM theo nhóm, giữ nguyên phép tính của mô hình nhưng loại bỏ một đường MLP riêng cùng lượng dữ liệu trung gian phải di chuyển.
Đường xử lý AITER áp dụng cùng ý tưởng trong vLLM #46474. vLLM #46184, với sự hỗ trợ từ AITER #3811, cũng chuyển việc sắp xếp lại trọng số MXFP8 và hệ số tỉ lệ sang giai đoạn nạp mô hình. AITER mang theo các cấu hình MoE đã được tinh chỉnh cho quy mô từ 1 đến 32.768 token, cũng như cho các độ rộng trung gian cục bộ do TP4 và TP8 tạo ra. Việc chuyển đổi cách bố trí chỉ diễn ra một lần; vòng phục vụ sau đó sử dụng trực tiếp dạng dữ liệu đã được chuẩn bị.
Giải mã suy đoán cho thấy rõ lợi ích của việc gom các phần việc lặp lại. Bộ lập chỉ mục MSA ban đầu khởi chạy một nhóm công việc cho mỗi token dự đoán. vLLM #45743 chuyển sang khởi chạy một nhóm công việc cho mỗi yêu cầu và xử lý tất cả vị trí dự đoán cùng lúc, nhờ đó tái sử dụng các lần đọc khóa. Thay đổi này cũng loại bỏ hệ số tỉ lệ dương của điểm số, vì ở đây chỉ thứ tự top-k mới quan trọng; nhân mọi điểm với cùng một hằng số dương không thể làm thay đổi thứ tự đó.
Hạt nhân lập chỉ mục nhanh hơn tới 48,9%, trong khi hiệu năng phục vụ từ đầu đến cuối tăng khoảng 3,3% trong các phép thử của PR. Khoảng cách này chính là hệ quả của định luật Amdahl: một hạt nhân có thể tăng tốc rất nhiều mà vẫn không phải là toàn bộ đường xử lý quyết định thời gian của ứng dụng.
3. Những byte nào phải di chuyển?
Cơ chế chú ý thưa làm giảm lượng phép tính của cơ chế chú ý, nhưng đồng thời bổ sung một lớp điều khiển: xác định các khối điểm số, chọn top-k, ánh xạ các khối logic sang các trang vật lý và truyền thông tin mô tả này cho hạt nhân chú ý.
vLLM #47269 nhận thấy các lớp thưa nằm cạnh nhau thường chọn gần như cùng một tập khối. Khi bật dùng chung chỉ mục, một lớp thực hiện quyết định top-k rồi các lớp phía sau tái sử dụng kết quả đó. TPOT trung bình giảm khoảng 10% ở mức đồng thời 1 và khoảng 4% ở mức đồng thời cao.
Bỏ qua bước chọn khối mới chỉ giải quyết một nửa vấn đề. Phép chiếu hợp nhất vẫn tạo ra các giá trị Q/K của bộ lập chỉ mục, chuẩn hóa chúng, áp dụng RoPE rồi ghi vào bộ nhớ đệm chỉ mục. vLLM #47287 đưa thông tin về việc có thể tái sử dụng kết quả vào hạt nhân hợp nhất này, nhờ đó nhánh tạo dữ liệu không còn được sử dụng sẽ bị loại bỏ ngay khi biên dịch.
PR này cũng tích hợp cơ chế chú ý thưa theo trang của AITER dù hai bên sử dụng cách bố trí khác nhau. MiniMax M3 chọn các khối logic dài 128 token, trong khi AITER sử dụng các trang dài 16 token. Thay vì sao chép dữ liệu KV, vLLM chuyển mỗi mã khối được chọn thành tám mã trang rồi tạo một bảng trang gọn. Bộ nhớ đệm KV vẫn nằm nguyên tại vị trí cũ. Đây chính là cách phục vụ tương đương với việc truyền một khung nhìn vào dữ liệu thay vì sao chép cả vùng chứa.
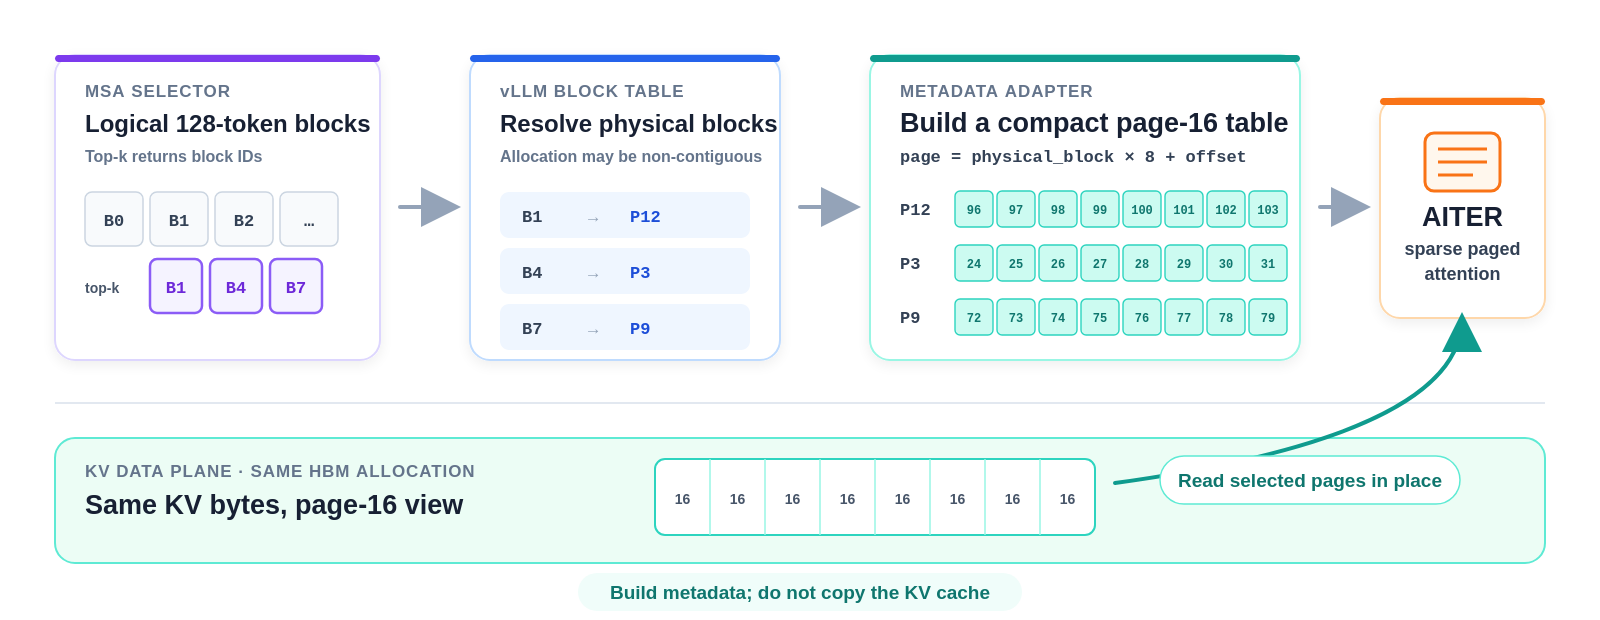
Hình 5. Mỗi khối 128 token được chọn sẽ ánh xạ tới một khối vật lý, sau đó được mở rộng thành tám mục trang, mỗi mục 16 token. AITER đọc dữ liệu thông qua một khung nhìn vào vùng KV hiện có; chỉ bảng ánh xạ được tạo lại.
Ở TP4 và mức đồng thời 256, phép thử A/B riêng của PR cho thấy thông lượng đầu ra tăng 6,93% với MXFP4 và 5,56% với MXFP8.
Tại đây có một ranh giới quan trọng về cách đo hiệu năng. Quy tắc đánh giá cố định 8K/1K của InferenceX không tính việc dùng chung chỉ mục giữa các lớp, vì thay đổi này làm giảm lượng công việc mà kiến trúc phải thực hiện. Cấu hình hình dạng cố định có sử dụng bộ chuyển đổi trang nhưng không dùng lại kết quả top-k. AgentX cho phép dùng lại kết quả theo các quy tắc riêng của khối lượng công việc. Vì vậy, đội nhóm không tính vào đường biểu diễn theo hợp đồng cố định những phần việc mà cấu hình đó thực tế không chạy.
Lượng tử hóa khiến câu hỏi “những byte nào phải di chuyển?” càng trở nên quan trọng. Có thể chia thành ba lớp dữ liệu:
| Lớp dữ liệu | Ví dụ trên MiniMax M3 | Điều cần xác minh |
| Trọng số và giá trị kích hoạt | GEMM/MoE MXFP8 hoặc MXFP4 | Cách đóng gói, hệ số tỉ lệ, phép tính trên giá trị kích hoạt, cách bố trí dữ liệu của bộ phụ trợ |
| Trạng thái lưu lâu dài | KV FP8 và bộ nhớ đệm chỉ mục thưa | Kiểu dữ liệu trên nền tảng, cách bố trí trang, cách đọc/ghi |
| Dữ liệu trao đổi | All-reduce hoặc truyền KV đã lượng tử hóa | Điều kiện được phép sử dụng, bộ mã hóa được chọn, quyền sở hữu và thời điểm hoàn tất |
Ba lớp dữ liệu này có các quy tắc chọn đường xử lý và yêu cầu về tính đúng đắn riêng. Việc “mô hình là MXFP4” không cho biết kiểu dữ liệu của KV hay đường xử lý phép tập hợp được sử dụng.
4. Đường xử lý nhanh có thực sự chạy - và có chạy đúng không?
Phần kiểm tra này đã khiến đội nhóm phải sửa lại một nhận định trong bài viết. Ban đầu, đội nhóm cho rằng một phép tập hợp khi giải mã có kích thước khoảng 1,5 MB sử dụng QuickReduce INT4. Tuy nhiên, bằng chứng hiện có không đủ để khẳng định điều đó.
InferenceX #2104 cấu hình INT4 và ngưỡng bộ mã hóa 256 KB, nhưng không cấu hình ngưỡng điều kiện sử dụng riêng của QuickReduce. Với BF16 và TP4, bảng cấu hình dựng sẵn được cố định yêu cầu 16 MB để sử dụng INT4. Vì vậy, phép tập hợp 1,5 MB không đạt ngưỡng để chọn QuickReduce; ngưỡng 256 KB chỉ được kiểm tra sau khi QuickReduce đã đủ điều kiện sử dụng.
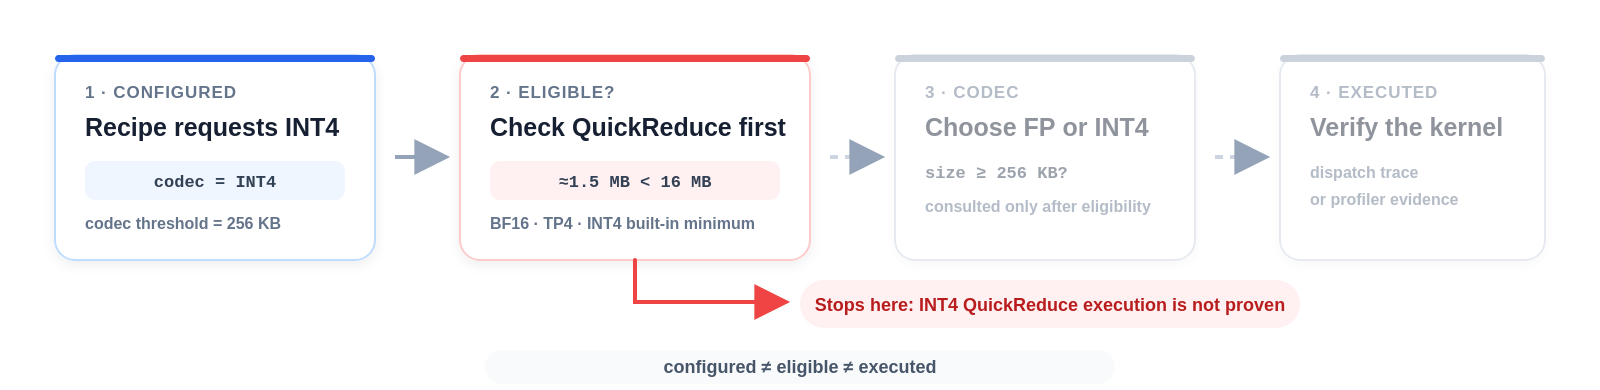
Hình 6. QuickReduce kiểm tra điều kiện sử dụng trước khi chọn FP hoặc INT4. Trong trường hợp này, phép tập hợp nhỏ hơn ngưỡng điều kiện được tích hợp sẵn, vì vậy chỉ cấu hình thôi không đủ để khẳng định đường xử lý này đã được thực thi.
Các nhật ký hiện có chỉ chứng minh rằng INT4 đã được cấu hình, chứ không chứng minh hạt nhân QuickReduce thực sự được chạy. Vì vậy, đội nhóm xem #2104 là một mốc cấu hình và kết quả tích lũy, đồng thời không quy kết đường biểu diễn của nó cho phép all-reduce INT4.
Sự phân biệt này có thể áp dụng rộng hơn:
configured ≠ eligible ≠ executedHãy dùng dấu vết chọn đường xử lý hoặc công cụ phân tích hiệu năng trước khi quy một mức cải thiện cho một bộ phụ trợ cụ thể.
Tính đúng đắn cũng cần được kiểm tra với cùng mức chặt chẽ. Ba ví dụ dưới đây đã phát hiện ba hợp đồng bị phá vỡ khác nhau:
-
-
-
- vLLM #45794 ánh xạ các tensor Q/K/V MXFP4 được đóng gói và các tensor điểm kiểm tra gate/up vào đúng các lát tham số hợp nhất, đồng thời truyền các tham số SwiGLU-OAI của MiniMax M3 vào MoE.
- vLLM #45720 sửa khung nhìn KV FP8 trên các thiết bị ROCm FNUZ. Trên MI300X, đường xử lý chưa sửa chỉ đạt mức khớp nghiêm ngặt 0,0099 trên GSM8K; sau khi sửa đạt 0,9575. Đây là bản sửa tính đúng đắn, không phải một tuyên bố về mức tăng tốc trên MI355X.
- vLLM #47158 sửa mặt nạ song song chuyên gia được truyền vào AITER. Đường xử lý có lỗi chỉ đạt độ tương đồng cosine 0,527; đường xử lý đã sửa đạt 1,0 và khôi phục độ chính xác trên GSM8K.
-
-
Hai ví dụ cuối không giải thích đường biểu diễn chính TP4/EP1; chúng cho thấy những hợp đồng mà các cấu hình khác cũng phải đáp ứng. Trong công việc tối ưu hiệu năng, “đạt” nên có nghĩa là đồng thời thỏa mãn ba điều: đầu ra đúng, đường xử lý dự kiến thực sự được thực thi và chỉ số từ đầu đến cuối được cải thiện trong cùng một điều kiện.
EAGLE3 bổ sung một vòng giải mã thứ hai
EAGLE3 bổ sung một mô hình dự đoán, cơ chế kiểm tra nhiều token, quy tắc chấp nhận token và một bộ siêu dữ liệu chú ý thứ hai. Vì vậy, không thể xem EAGLE3 đơn giản là một cờ bật trên đường biểu diễn tiêu chuẩn.
vLLM #45546 kết nối mô hình AMD với giao diện EAGLE3. Sau đó, vLLM #45564 sửa một lỗi tinh vi trong khóa bộ nhớ đệm: mô hình đích và mô hình dự đoán sử dụng số đầu truy vấn khác nhau, vì vậy không được dùng chung bộ tạo nhóm chú ý chỉ vì chúng có cùng bộ phụ trợ và cùng kiểu KV.
Đây là một quy tắc chung khi xây dựng khóa bộ nhớ đệm: khóa phải chứa mọi thuộc tính bất biến có thể làm thay đổi đối tượng được lưu trong bộ nhớ đệm.
Sau khi bổ sung việc gom chỉ mục theo từng yêu cầu như mô tả ở trên, InferenceX #2107 phát hiện rằng thiết lập bộ phụ trợ chú ý của mô hình đích không được áp dụng cho mô hình dự đoán. Việc cố định TRITON_ATTN trong cấu hình suy đoán đã tránh được đường dự phòng chậm hơn của mô hình dự đoán.
Cuối cùng, vLLM #47984 mở rộng cơ chế chú ý thưa theo trang của AITER từ giải mã một token sang kiểm tra nhiều token. Cơ chế này ánh xạ mỗi hàng truy vấn sau khi trải phẳng trở lại yêu cầu và vị trí dự đoán cục bộ tương ứng, tái sử dụng bộ tạo bảng trang hiện có và vẫn giữ nguyên đường xử lý nhanh cho trường hợp một token. Các phép thử TP4 cho thấy thông lượng đầu ra tăng 8,32% với MXFP4 và 7,90% với MXFP8 mà không làm thay đổi đáng kể tỷ lệ chấp nhận.
Kết hợp lại, các thay đổi này tạo ra kết quả EAGLE3 riêng biệt đạt 682,4 token đầu ra/giây/GPU ở mức đồng thời 128.
5. Hàng đợi nào đang dài lên?
Việc tách rời nạp đầu vào và giải mã đã đẩy điểm nghẽn lên cao hơn phạm vi của một tiến trình. Tuy nhiên, trước khi tinh chỉnh số lượng tiến trình xử lý, ranh giới truyền KV phải được bảo đảm là đúng.
Đường xử lý MoRIIO ban đầu giả định rằng cách bố trí KV của lớp đầu tiên đại diện cho tất cả các lớp. MiniMax M3 có tensor K/V tách riêng, tensor K/V xen kẽ và bộ nhớ đệm chỉ mục chỉ chứa khóa. Dữ liệu vẫn được truyền xong và thông lượng trông có vẻ tốt, nhưng điểm GSM8K giảm xuống khoảng 0,0008 – thực chất chỉ còn một mớ token vô nghĩa.
Việc sửa lỗi được thực hiện qua ba bước:
-
-
-
- vLLM #46039 xác định hình học truyền dữ liệu và độ lệch byte riêng cho từng lớp.
- vLLM #46290 đếm số lần ghi thực sự được lập lịch cho từng yêu cầu, cố định số lượng này sau lượt lan truyền thuận và chỉ giải phóng bộ đệm sau khi các lần ghi đó hoàn tất.
- vLLM #46332 bổ sung ánh xạ hạng cho TP không đồng nhất và cơ chế tập hợp xác nhận. Với nạp đầu vào TP4 và giải mã TP8, hai hạng giải mã có thể cùng sử dụng dữ liệu từ một hạng phát, vì vậy cả hai đều phải xác nhận trước khi các khối của hạng phát được tái sử dụng.
-
-
Chỉ sau khi hoàn tất các bước này, việc phân bổ tiến trình xử lý mới đáng để tối ưu.
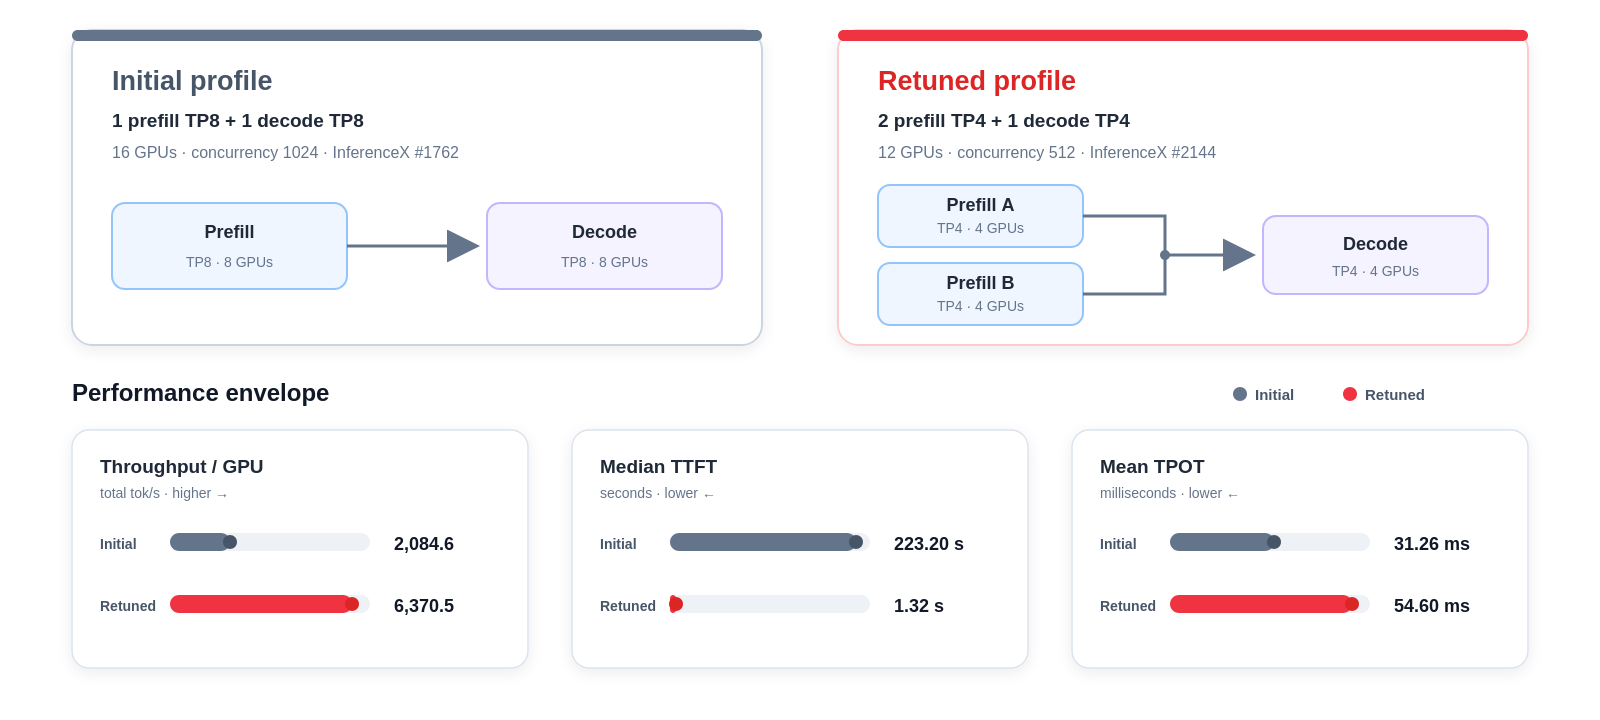
Hình 7. Hai điểm vận hành P/D với đầu vào 8K và đầu ra 1K. Hai điểm cuối sử dụng số lượng GPU và mức đồng thời khác nhau, vì vậy đây là sự tiến hóa của hệ thống chứ không phải một phép so sánh tăng tốc có kiểm soát.
Cấu hình công khai đầu tiên sử dụng một tiến trình nạp đầu vào TP8 và một tiến trình giải mã TP8. Ở mức đồng thời 1024, hệ thống đạt 2.084,6 token/giây/GPU tổng cộng, nhưng TTFT trung vị lên tới 223,20 giây (InferenceX #1762). Con số thông lượng không khiến hệ thống trở nên hữu dụng; tín hiệu cần chú ý nằm ở hàng đợi câu lệnh.
InferenceX #2144 chuyển mọi tiến trình sang TP4, đồng bộ chúng với cấu hình nhanh hơn trên một máy, rồi tìm tỷ lệ giữa nạp đầu vào và giải mã. Với 8K/1K, hai tiến trình nạp đầu vào TP4 cung cấp dữ liệu cho một tiến trình giải mã TP4. Ở mức đồng thời 512, kết quả đạt 6.370,5 token/giây/GPU tổng cộng và TTFT trung vị 1,32 giây.
TPOT trung bình tăng từ 31,26 lên 54,60 mili giây. Điều này không mâu thuẫn. Việc bổ sung năng lực nạp đầu vào đã giải phóng hàng đợi tiếp nhận, trong khi điểm vận hành giải mã được chọn khiến mỗi chuỗi đang hoạt động được tạo ra chậm hơn. Hệ thống P/D có ít nhất hai mục tiêu về độ trễ. Hãy công bố cả hai.
Một lần chạy với mức đồng thời cao cũng chạm giới hạn số bộ mô tả tệp của vùng chứa. Tăng nofile đã khắc phục các lỗi TCP. Khi phép đo hiệu năng đã được đẩy lên các tầng cao hơn, một giới hạn của hệ điều hành có thể thực tế không kém gì cách chia ô của một phép GEMM.
AgentX cho thấy điểm nghẽn tiếp theo
Khối lượng công việc cố định 8K/1K rất phù hợp để so sánh có kiểm soát. Nhưng mã hóa theo kiểu tác nhân không phải là lưu lượng có hình dạng cố định: nó có các chuỗi dài qua nhiều lượt, tiền tố có thể tái sử dụng, đầu ra không đều và một ngưỡng giới hạn về dung lượng KV.
InferenceX #2487 là kết quả AgentX đầu tiên của MiniMax M3 trên MI355X sử dụng MXFP4, EAGLE3-GQA, bộ nhớ đệm tiền tố, LMCache tùy chọn được chia theo TP và dùng lại chỉ mục giữa các lớp. Phép phát lại thông lượng sử dụng độ dài chấp nhận tổng hợp đã được cố định để bảo đảm các hệ thống được so sánh thực hiện cùng lượng công việc suy đoán; phép đánh giá sử dụng việc kiểm tra thực tế của mô hình đích.
Trong lần chạy thành công, TP4 ở mức đồng thời 28 đạt 127,4 token đầu ra/giây/GPU, 509,5 token đầu ra/giây tổng cộng, 0,582 yêu cầu/giây, TTFT p50 645 mili giây và TPOT p50 41,3 mili giây.
Các chỉ số của hệ thống phục vụ cho thấy đây không chỉ là một con số điểm khác:
-
-
-
- Tỷ lệ trúng bộ nhớ đệm tiền tố theo lý thuyết: 96,7%
- Tỷ lệ trúng bộ nhớ đệm GPU thực tế: 92,1%
- Mức sử dụng bộ nhớ đệm KV trên GPU: 88,5%
- Dung lượng KV trên GPU: 6.264.960 token
-
-
Ở thời điểm này, tối ưu thêm một phép GEMM chưa chắc đã là dự án tiếp theo đáng làm nhất. Khoảng cách 4,6 điểm giữa tỷ lệ trúng bộ nhớ đệm theo lý thuyết và thực tế, cùng mức vận hành gần chạm giới hạn dung lượng, hướng sự chú ý sang việc căn chỉnh tiền tố, chính sách tiếp nhận và loại bỏ yêu cầu, lập lịch và chuyển dữ liệu sang nơi khác. Đây là những quan sát từ một lần chạy, chưa phải kết luận về một phép tối ưu. Đội nhóm sẽ dùng mốc này làm đường cơ sở cho vòng tối ưu tiếp theo dành cho các khối lượng công việc tác nhân.
Danh sách kiểm tra cho mô hình tiếp theo
Khi một đường phục vụ mới đã chạy được nhưng vẫn chưa đủ nhanh:
-
-
-
- Ghi lại phân bố hình dạng cục bộ sau khi chia nhỏ. Bao gồm cả các đầu được sao chép và số token được định tuyến.
- Ước tính phần việc lặp lại. Nhân phần việc ở mỗi lớp với số lớp, số token đầu ra và số yêu cầu đang hoạt động.
- Tách ba lớp dữ liệu: tensor tính toán, trạng thái lưu lâu dài và dữ liệu trao đổi.
- Với mọi đường xử lý nhanh, ghi lại điều kiện được phép sử dụng và xác minh rằng đường xử lý đó thực sự được chạy.
- Đặt một bước kiểm tra tính đúng đắn song song với mỗi bước kiểm tra hiệu năng.
- Sau mỗi lần đạt cải thiện, hãy đo và phân tích hiệu năng lại. Nếu các hạt nhân ở tầng thấp đã không còn chênh lệch đáng kể, hãy kiểm tra hàng đợi, quyền sở hữu dữ liệu, dung lượng bộ nhớ đệm và các giới hạn của hệ điều hành.
-
-
Đó là kết quả quan trọng nhất của toàn bộ công việc này. MiniMax M3 nhanh hơn vì nhóm phát triển liên tục thay đổi cấp độ của câu hỏi – từ cách chia ô, sang các đường xử lý lặp lại, rồi đến siêu dữ liệu thưa, trạng thái phân tán và cuối cùng là các hàng đợi của khối lượng công việc.
Tái hiện kết quả với hình dạng cố định
Các lần chạy công khai của InferenceX ghi lại ảnh vùng chứa, tham số và các tệp kết quả. Mốc MXFP8 TP4 cuối cùng sử dụng:
vllm/vllm-openai-rocm:nightly-9e57de7197f234f9d9187715d96e07e007048c0fexport VLLM_ENGINE_READY_TIMEOUT_S=3600
export VLLM_USE_BREAKABLE_CUDAGRAPH=0
export VLLM_ROCM_USE_AITER=1
export VLLM_ROCM_USE_AITER_FUSION_SHARED_EXPERTS=1
vllm serve MiniMaxAI/MiniMax-M3-MXFP8 \
--tensor-parallel-size 4 \
--block-size 128 \
--no-enable-prefix-caching \
--language-model-only \
--moe-backend aiter \
--max-model-len 10240 \
--max-num-batched-tokens 32768 \
--kv-cache-dtype fp8 \
--attention-backend TRITON_ATTN \
--tool-call-parser minimax_m3 \
--reasoning-parser minimax_m3 \
--enable-auto-tool-choiceĐể tái hiện chính xác cách chọn đường xử lý ở mức đồng thời cao được sử dụng trong Hình 1, hãy dùng cấu hình có điều kiện trong InferenceX #2187. Với MXFP4 TP2, sử dụng #2446; với P/D, sử dụng #2144. Chỉ sao chép các cờ ở trên sẽ không tái tạo được ảnh vùng chứa, cấu trúc triển khai hoặc khối lượng công việc khác.
Lệnh đo hiệu năng ở mức đồng thời 128 là:
vllm bench serve \
  --backend vllm \
  --model MiniMaxAI/MiniMax-M3-MXFP8 \
  --dataset-name random \
  --random-input-len 8192 \
  --random-output-len 1024 \
  --random-range-ratio 0.8 \
  --num-prompts 1280 \
  --max-concurrency 128 \
  --request-rate inf \
  --ignore-eos \
  --num-warmups 256 \
  --percentile-metrics ttft,tpot,itl,e2el \
  --save-result
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.