Giới thiệu vllm-metal: Phục vụ đồng thời trên Apple Silicon
Suy luận cục bộ trên máy Mac khá đơn giản cho đến khi nhiều yêu cầu đến cùng lúc. Khi đó, thời gian nhận token đầu tiên (time to first token – TTFT), mức sử dụng bộ nhớ tăng dần và việc kiểm soát tiếp nhận yêu cầu trở thành những bài toán về phục vụ mô hình, thay vì chỉ là bài toán thực thi mô hình. vllm-metal đưa bộ lập lịch, bộ nhớ đệm KV theo trang và máy chủ tương thích với OpenAI API của vLLM lên Apple Silicon, trong khi MLX và Metal đảm nhiệm việc thực thi mô hình.
Bản phát hành chính thức đầu tiên v0.28.0, đã đồng bộ cách đánh số phiên bản của vllm-metal với vLLM. Bản này bổ sung khả năng dự đoán nhiều token theo lô (multi-token prediction – MTP), hỗ trợ GGUF và các mô hình kết hợp, đồng thời tăng tốc khâu nạp dữ liệu đầu vào trên M5. Bạn có thể cài đặt v0.29.0 bằng Homebrew.
vllm-metal nằm ở đâu trong vLLM?
vllm-metal tích hợp trực tiếp vào vLLM. vLLM cung cấp bộ lập lịch V1, cơ chế quản lý các khối KV theo trang, nạp đầu vào theo từng đoạn, lấy mẫu và giao diện phía trước tương thích với OpenAI API, bao gồm truyền dữ liệu theo luồng và phân tích lời gọi công cụ. mlx_lm cung cấp phần cài đặt các mô hình, còn MLX đảm nhiệm việc thực thi chúng.
Ở cấp độ mô hình, vllm-metal sử dụng lại nguyên trạng các thành phần của mlx_lm để nạp trọng số, RMSNorm, lớp tuyến tính, MoE và MLP. Các lớp này xử lý từng token độc lập, nên có thể chạy trên trục token được đóng gói mà không cần biết ranh giới giữa các yêu cầu. Cơ chế chú ý lại cần biết những ranh giới này, vì vậy vllm-metal thay thế cơ chế chú ý mặc định bằng một hạt nhân Metal có độ dài biến đổi theo trang. Do đó, phần mã riêng cho từng mô hình của plugin phần lớn chỉ tập trung ở một lớp.
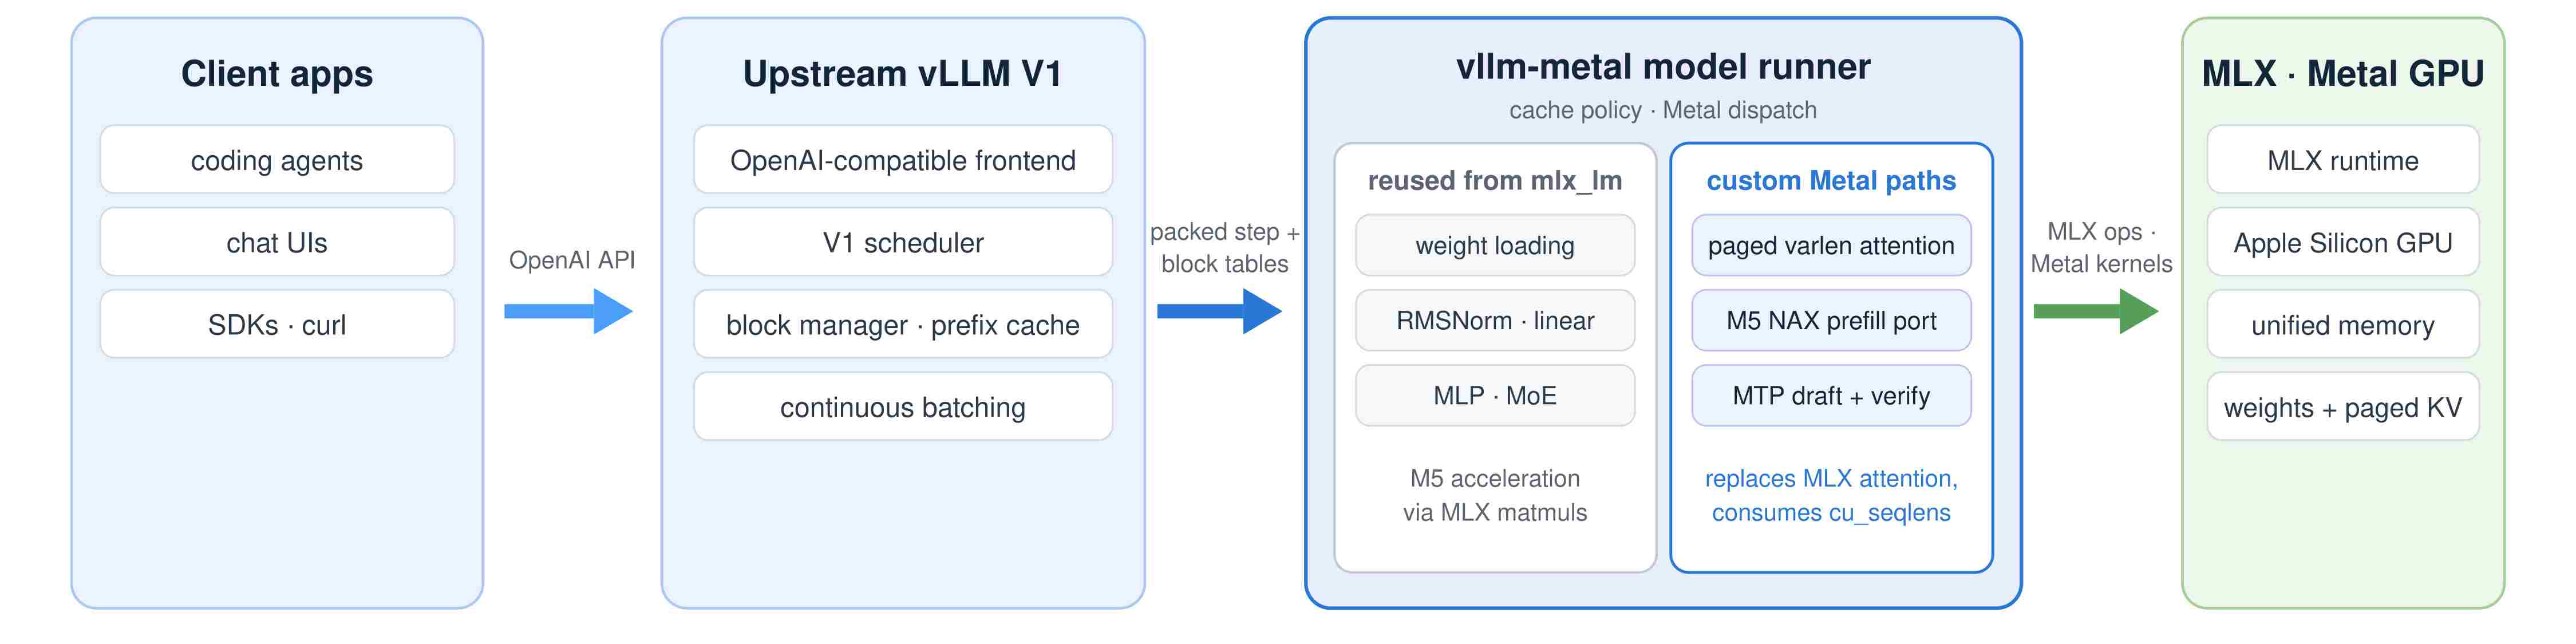
Tổng quan kiến trúc: máy khách sử dụng OpenAI API để gửi yêu cầu đến giao diện phía trước và bộ lập lịch V1 của vLLM. Hai thành phần này chuyển cho bộ thực thi mô hình của vllm-metal một bước tính toán chứa các token đã được đóng gói cùng các bảng khối. Bộ thực thi tiếp tục sử dụng các lớp xử lý theo từng token của mlx_lm, đồng thời bổ sung các đường thực thi Metal riêng cho cơ chế chú ý độ dài biến đổi theo trang, MTP và khâu nạp dữ liệu đầu vào NAX trên M5. Toàn bộ quá trình được thực thi thông qua MLX và Metal trên vùng bộ nhớ thống nhất của Apple Silicon.
Khởi chạy máy chủ tương thích với OpenAI API
Trên Apple Silicon chạy macOS 15 trở lên, hãy cài đặt bản ổn định bằng Homebrew:
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal
Homebrew sẽ quản lý Python và các phần phụ thuộc. Chạy trực tiếp lệnh vllm để khởi chạy một mô hình:
# --gpu-memory-utilization sets the serving memory budget; see below.
vllm serve Qwen/Qwen3.5-0.8B --gpu-memory-utilization 0.5

# 64 GB Macs: the 27B hybrid
# vllm serve mlx-community/Qwen3.8-27B-4bit --gpu-memory-utilization 0.7

# Speculative decoding: Gemma 4 with its MTP assistant
# vllm serve google/gemma-4-E4B-it --gpu-memory-utilization 0.5 \
#   --max-model-len 16384 --no-async-scheduling \
#   --speculative-config '{"method":"mtp","model":"mlx-community/gemma-4-E4B-it-assistant-bf16","num_speculative_tokens":1}'
Xem bảng các mô hình để biết thêm các mô hình được hỗ trợ, hoặc xem hướng dẫn cài đặt để biết các phương thức cài đặt khác.
Máy chủ sử dụng OpenAI API:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3.5-0.8B",
       "messages": [{"role": "user", "content": "Say hi"}]}'
Bất kỳ ứng dụng nào nhận địa chỉ cơ sở tương thích với OpenAI API đều có thể trỏ tới http://localhost:8000/v1, bao gồm cả các tác nhân lập trình. Tài liệu vLLM có hướng dẫn thiết lập cho Claude Code và Codex.
Thiết lập giới hạn bộ nhớ có thể dự đoán
Bộ kiểm soát bộ nhớ của vllm-metal cho phép bạn đặt ngân sách suy luận bằng –gpu-memory-utilization, đồng thời chừa lại một phần bộ nhớ cho macOS và các ứng dụng đang chạy.
Tương tự vLLM, khi khởi động, hệ thống thực hiện một lượt chạy làm nóng để tính đến bộ nhớ dành cho trọng số mô hình, các giá trị trung gian và các vùng đệm tạm thời, trước khi phân bổ phần ngân sách còn lại cho bộ nhớ đệm KV có kích thước cố định. Hệ thống cũng giới hạn bộ nhớ đệm vùng đệm có thể tái sử dụng của MLX, nhằm ngăn bộ nhớ tích lũy dần trong quá trình phục vụ.
Những yêu cầu không đủ chỗ trong vùng nhớ KV sẽ phải chờ cho đến khi các trang bộ nhớ được giải phóng.
Đóng gói truy vấn và KV theo trang
Trong các lô dữ liệu có đệm của mlx_lm, các truy vấn chú ý có dạng [B, H, T_max, D]: mọi yêu cầu trong cùng một lô đều phải sử dụng độ dài truy vấn lớn nhất của lô. scaled_dot_product_attention của MLX không có giao diện hỗ trợ độ dài biến đổi.
vllm-metal giữ nguyên bước tính toán mô hình thống nhất của vLLM V1 cho cả nạp dữ liệu đầu vào theo từng đoạn và giải mã. Mọi token truy vấn được bộ lập lịch chọn sẽ được đóng gói thành [total_q, H, D], trong đó cu_seqlens đánh dấu ranh giới giữa các yêu cầu, rồi toàn bộ bước hỗn hợp được thực hiện trong một lượt lan truyền thuận của mô hình.
KV được quản lý riêng: mlx_lm duy trì một bộ nhớ đệm liên tục có dạng [B, H, T, D], trong khi vllm-metal lưu KV thành các trang có kích thước cố định và truy cập chúng thông qua các bảng khối riêng cho từng yêu cầu. Nhờ đó, những yêu cầu đã được tiếp nhận có thể tiếp tục tăng độ dài mà không cần định hình lại bộ nhớ đệm có đệm.
Khâu nạp dữ liệu đầu vào và khâu giải mã sử dụng hai chiến lược đóng gói theo lô khác nhau:
| Bộ máy | Cơ chế chú ý khi nạp đầu vào | Gom lô khi giải mã | KV |
| Lily | theo từng yêu cầu | một yêu cầu | liên tục |
| Uzu | theo từng yêu cầu | một yêu cầu | liên tục |
| oMLX | theo từng yêu cầu | theo lô | liên tục |
| Splash | theo từng yêu cầu | theo lô, tối đa 4 | theo trang |
| mlx_lm | có đệm | theo lô | liên tục |
| llama.cpp | dùng mặt nạ trên các ô | theo lô + nạp đầu vào | các ô cố định |
| vllm-metal | đóng gói, cu_seqlens | theo lô + nạp đầu vào | theo trang |
Cơ chế chú ý khi nạp đầu vào mô tả cách các truy vấn từ câu lệnh đi vào hạt nhân chú ý: xử lý riêng từng truy vấn, thêm đệm để đưa về cùng độ dài, hoặc nối các truy vấn lại với nhau. Việc gom lô khi giải mã cho phép xử lý nhiều yêu cầu trong cùng một bước của mô hình; “+ nạp đầu vào” nghĩa là các token của câu lệnh cũng được đưa vào cùng lô đó. KV mô tả cách dữ liệu được lưu trữ về mặt logic: trong các vùng đệm liên tục, các ô token riêng lẻ hoặc các khối token.
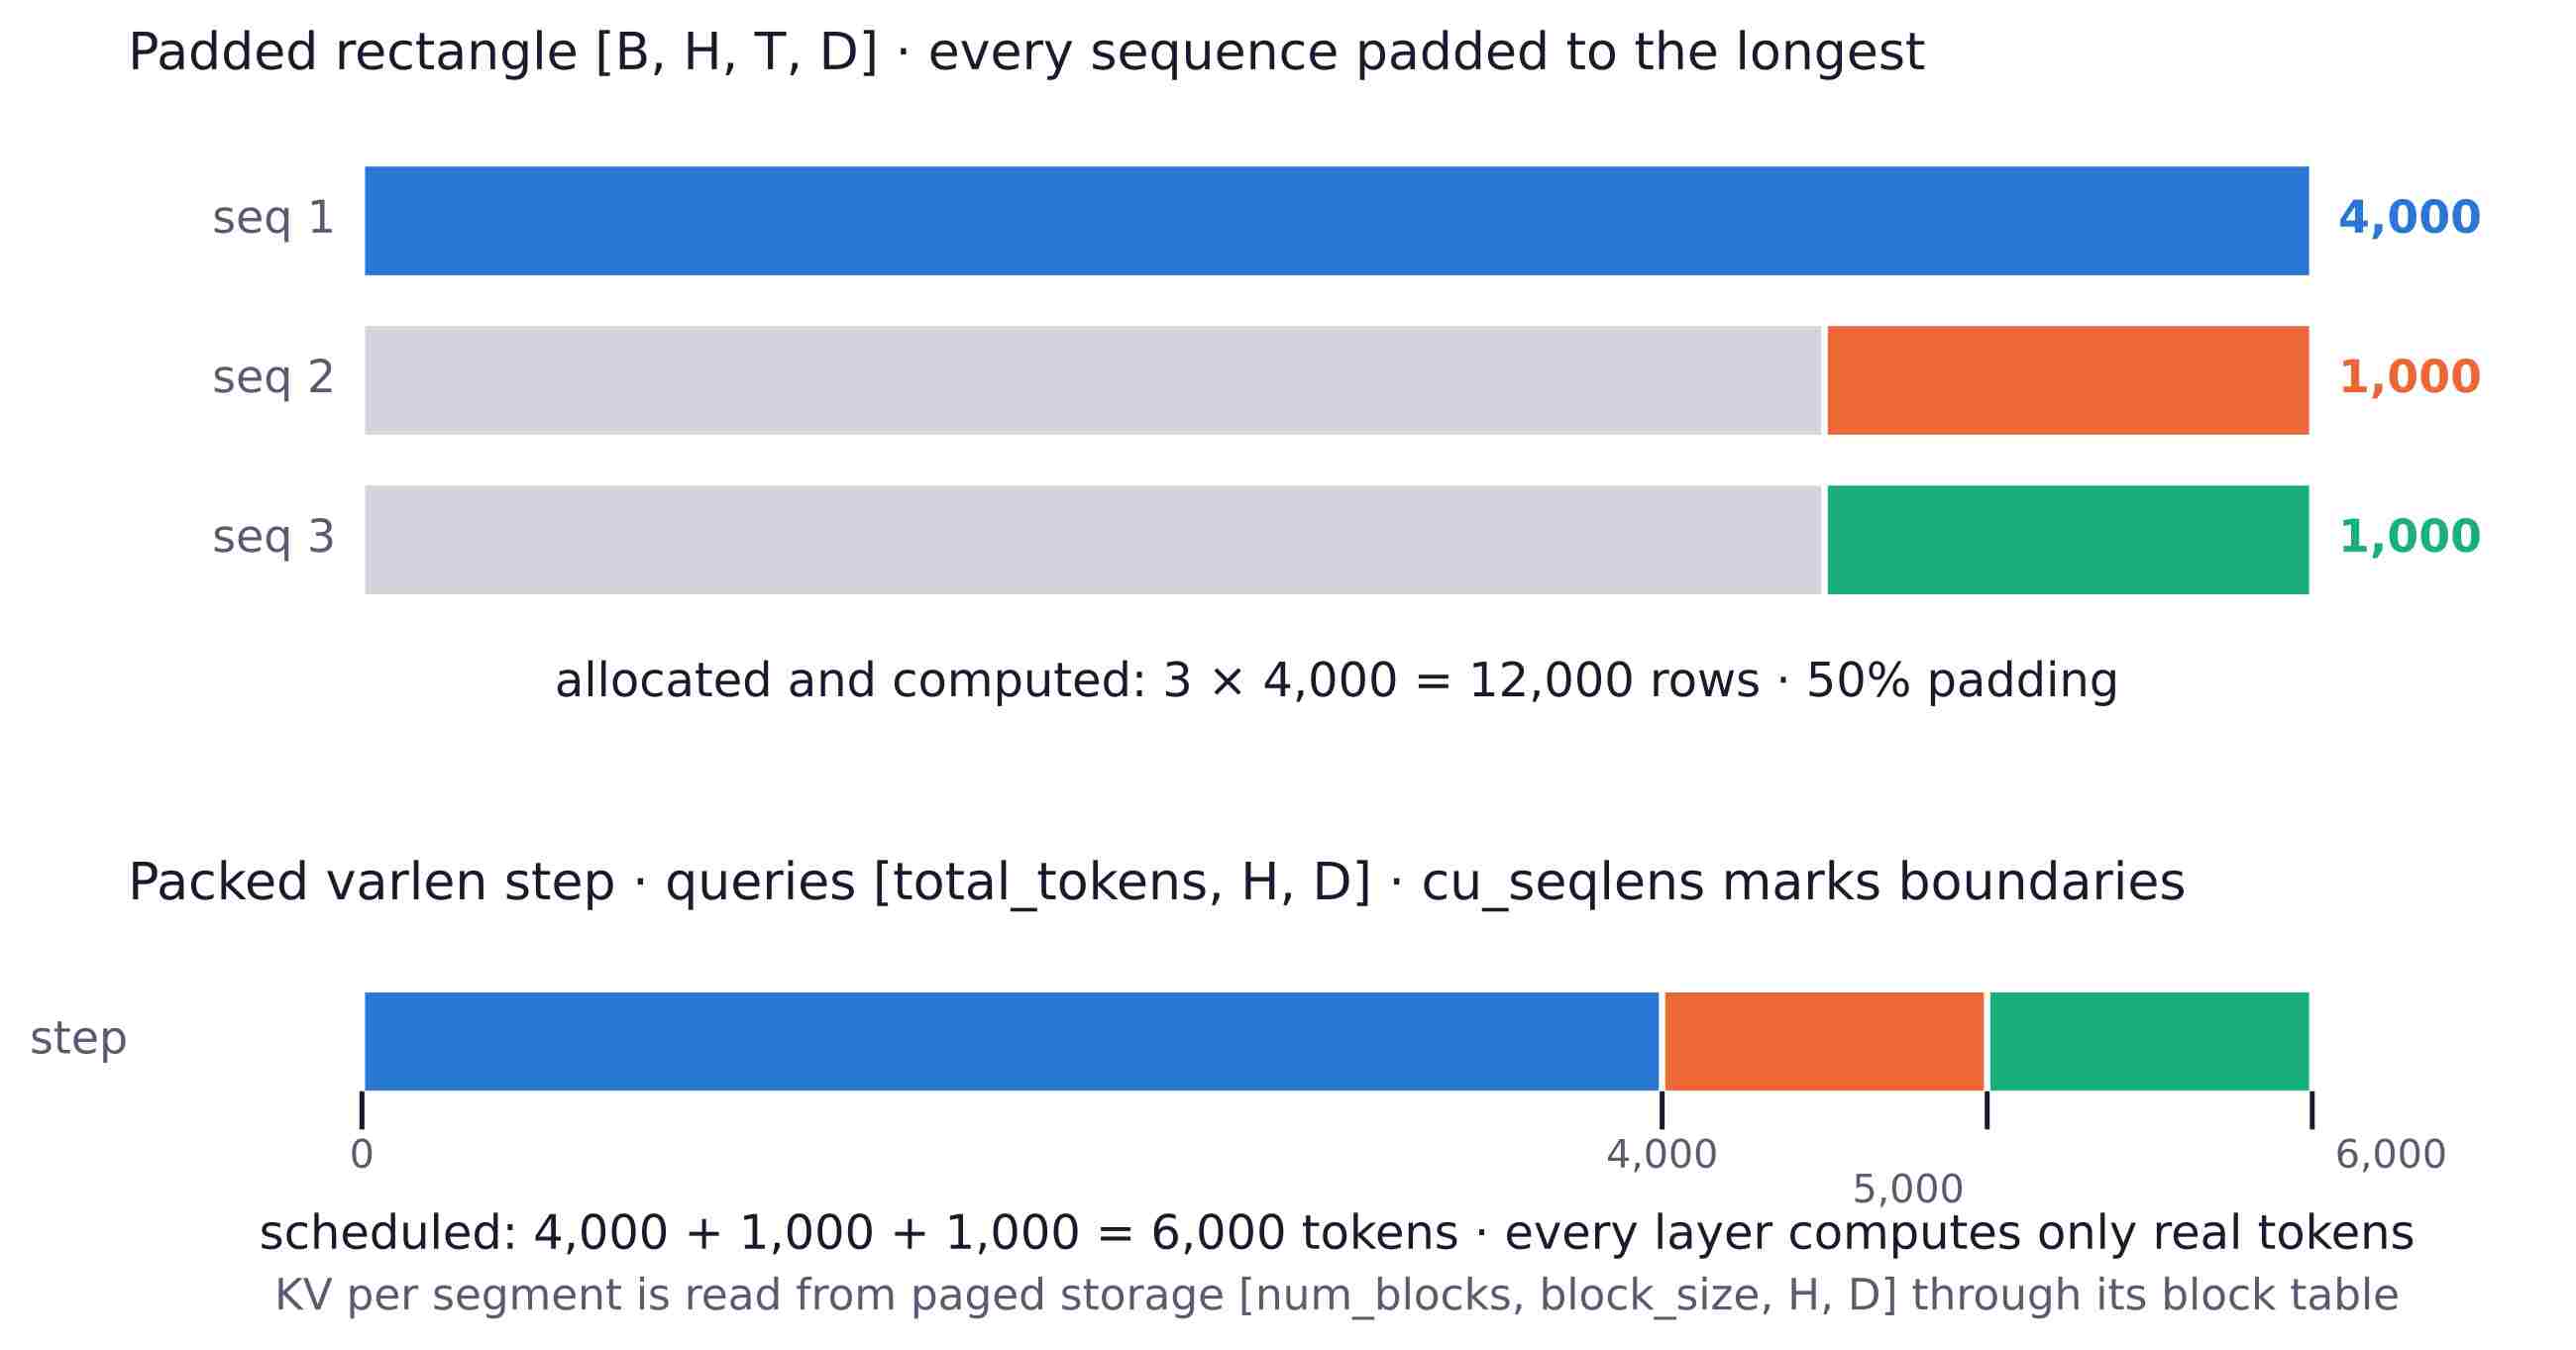
So sánh ma trận có đệm với bước xử lý độ dài biến đổi được đóng gói của vllm-metal trên một lô gồm 4.000 + 1.000 + 1.000 token, trong đó KV được đọc từ vùng lưu trữ theo trang
Trên Qwen3.6-35B-A3B với lượng tử hóa 4 bit, đã có các phép so sánh các lô gồm tám yêu cầu, tổng cộng khoảng 6.000 token đầu vào và 20 token đầu ra cho mỗi yêu cầu. Lô A có độ dài đầu vào tương đối đồng đều; lô B có một câu lệnh dài hơn đáng kể. Bảng dưới đây ghi thời gian xử lý toàn bộ lô, tính bằng giây; độ dài câu lệnh đã được làm tròn.
| Lô | Token đầu vào | mlx_lm | oMLX | llama.cpp | vllm-metal |
| A | 750 × 8 | 4,52 | 7,32 | 5,29 | 3,87 |
| B | 3.000 + 430 × 7 | 10,99 | 7,22 | 5,33 | 3,64 |
| Thay đổi | +143% | −1% | +1% | −6% |
Cách đóng gói này cũng cho phép xử lý các phần việc có độ dài không đồng đều trong cùng một lô. Trong một bước giải mã suy đoán, một yêu cầu có thể chỉ đóng góp một token cần giải mã, yêu cầu khác đóng góp token cuối cùng cùng với một số lượng token dự đoán riêng, còn một yêu cầu khác lại đóng góp một đoạn đầu vào cần nạp. Tensor truy vấn dạng [B, H, T_max, D] phải thêm đệm cho các hàng để đưa về cùng độ rộng, hoặc phải chia chúng thành nhiều lượt lan truyền thuận. Thay vào đó, vllm-metal nối các đoạn này thành [total_q, H, D] và kiểm tra tất cả trong một lượt lan truyền thuận duy nhất của mô hình đích.
Hạt nhân Metal chuyển hạt nhân Triton thống nhất của vLLM sang GPU Apple, được mô tả trong bài viết The Anatomy of a Triton Attention Kernel, kể cả thao tác tìm kiếm nhị phân mà mỗi nhóm luồng thực hiện trên cu_seqlens để xác định token truy vấn của mình thuộc về yêu cầu nào.
Phục vụ đồng thời dưới tải từ các tác nhân
Nhiều tác nhân lập trình hoặc nhiều phiên làm việc có thể đồng thời gửi yêu cầu đến mô hình. Trường hợp này đã được đo bằng phần kiểm thử tác nhân của SiliconBench: 100 câu lệnh nhiều lượt, mỗi câu có khoảng 4.600 token đầu vào, chạy trên M5 Pro với 64 GB bộ nhớ. Cả ba mô hình được so sánh đều sử dụng trọng số 4 bit.
Bài báo SiliconBench đưa ra đánh giá rộng hơn đối với chín bộ máy phục vụ trên Apple Silicon, xét về tốc độ, mức sử dụng bộ nhớ và độ trung thực của đầu ra.
Mỗi mức độ đồng thời đều bắt đầu với một máy chủ mới khởi động. Kết quả của oMLX được trình bày ở cả cấu hình bộ nhớ đệm mặc định trên SSD và bộ nhớ đệm chỉ dùng RAM; cả hai đều bắt đầu với bộ nhớ đệm trống. Phụ lục trình bày các cấu hình phục vụ, còn chú thích hình cho biết số yêu cầu đã hoàn tất.
Qwen3.8-27B
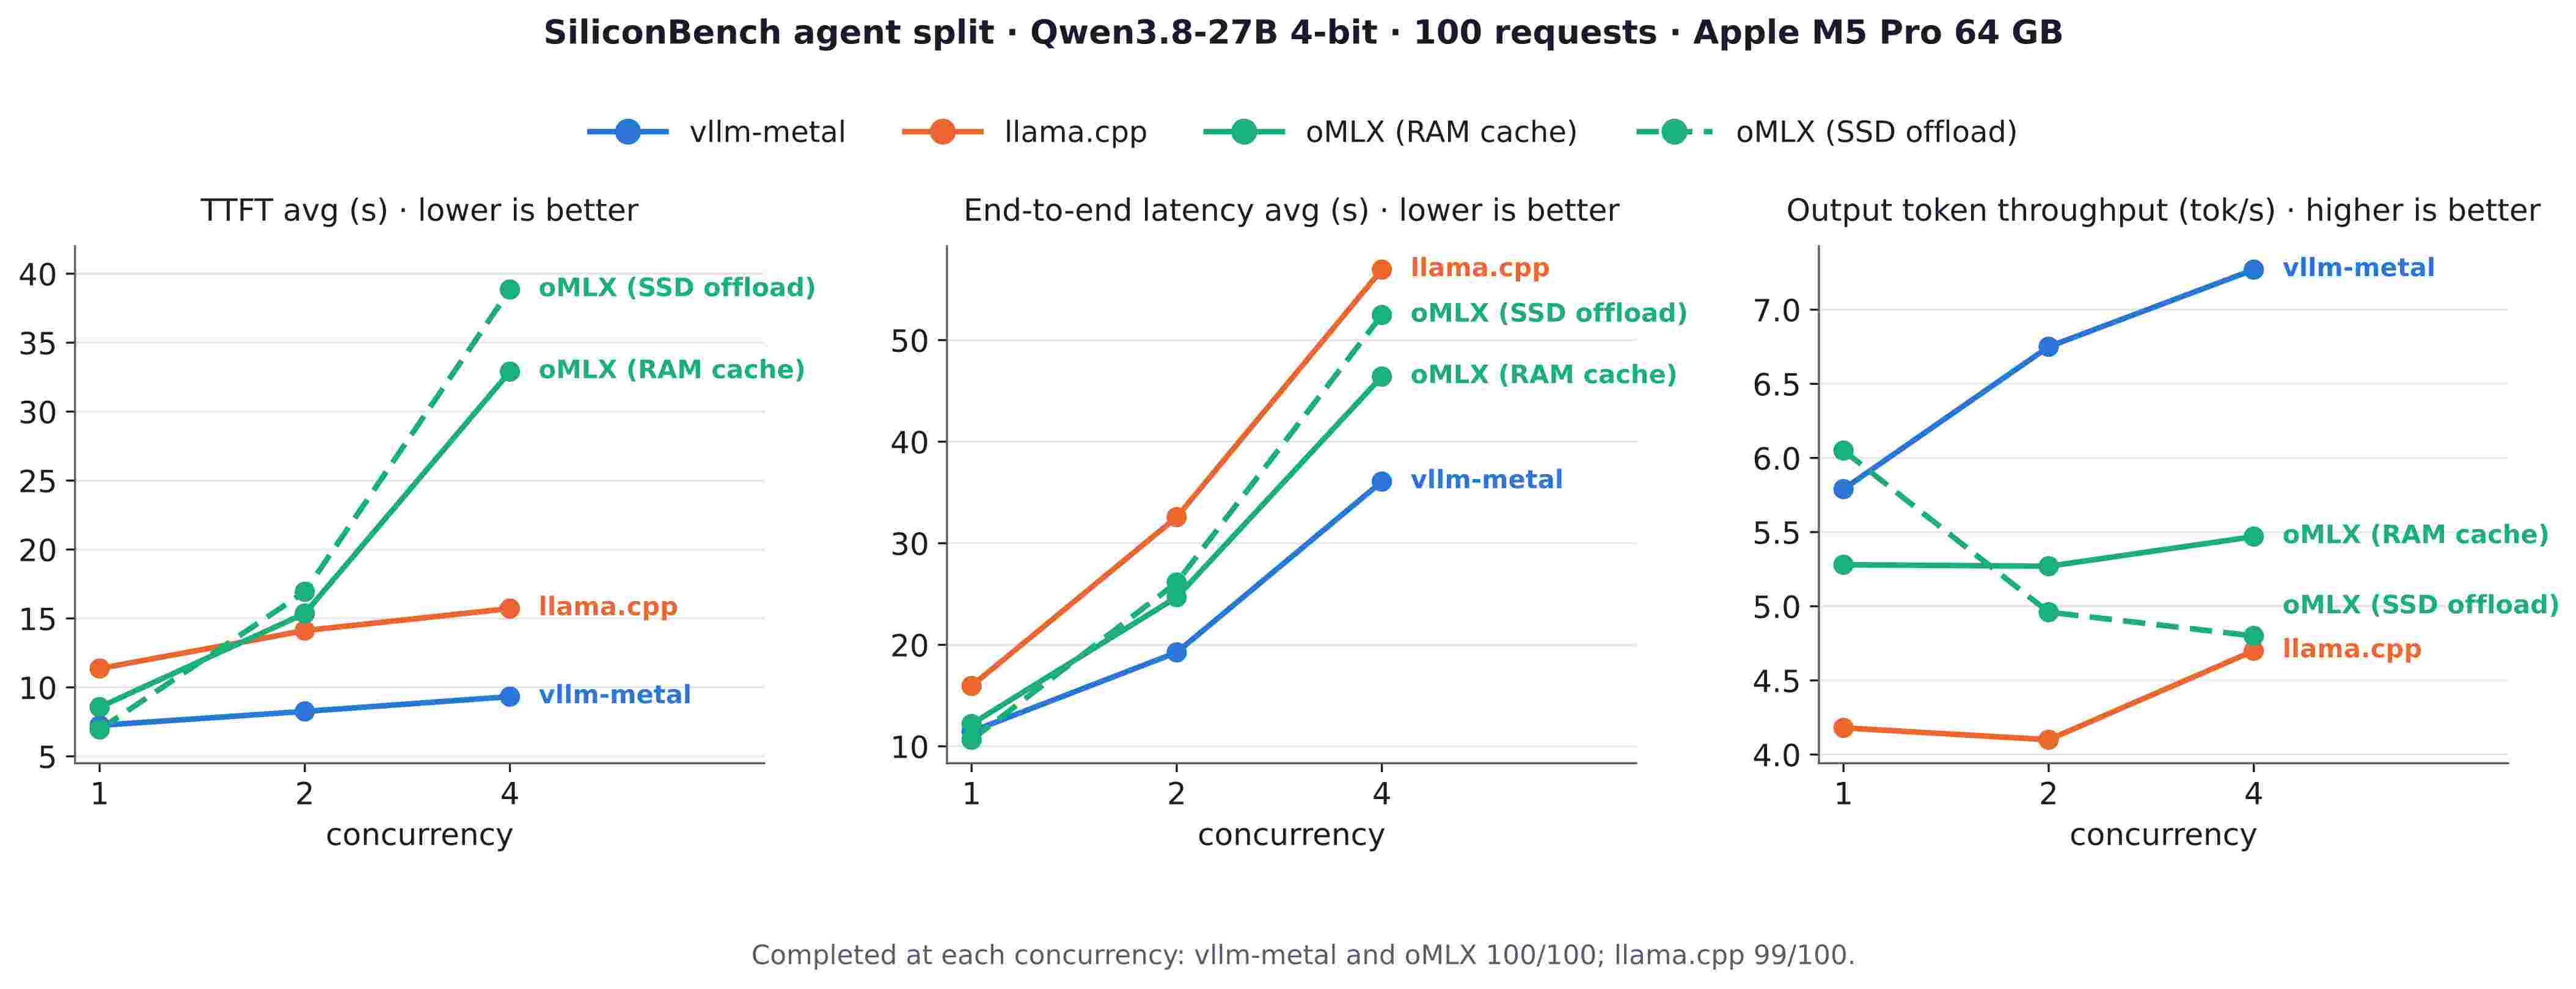
Kiểm thử tác nhân của SiliconBench trên Qwen3.8-27B: thời gian nhận token đầu tiên (TTFT), độ trễ từ đầu đến cuối của yêu cầu và thông lượng token đầu ra theo mức độ đồng thời, với llama.cpp, vllm-metal và oMLX sử dụng bộ nhớ đệm tiền tố trong RAM hoặc trên SSD.
vllm-metal có TTFT và độ trễ từ đầu đến cuối thấp nhất ở mức đồng thời 2 và 4. Ở mức đồng thời 1, oMLX với bộ nhớ đệm được chuyển sang SSD có kết quả dẫn đầu.
Gemma 4 E4B
Đối với Gemma 4 E4B đã được mở rộng phép thử lên mức đồng thời 16 và bổ sung vllm-metal với mô hình dự đoán MTP.
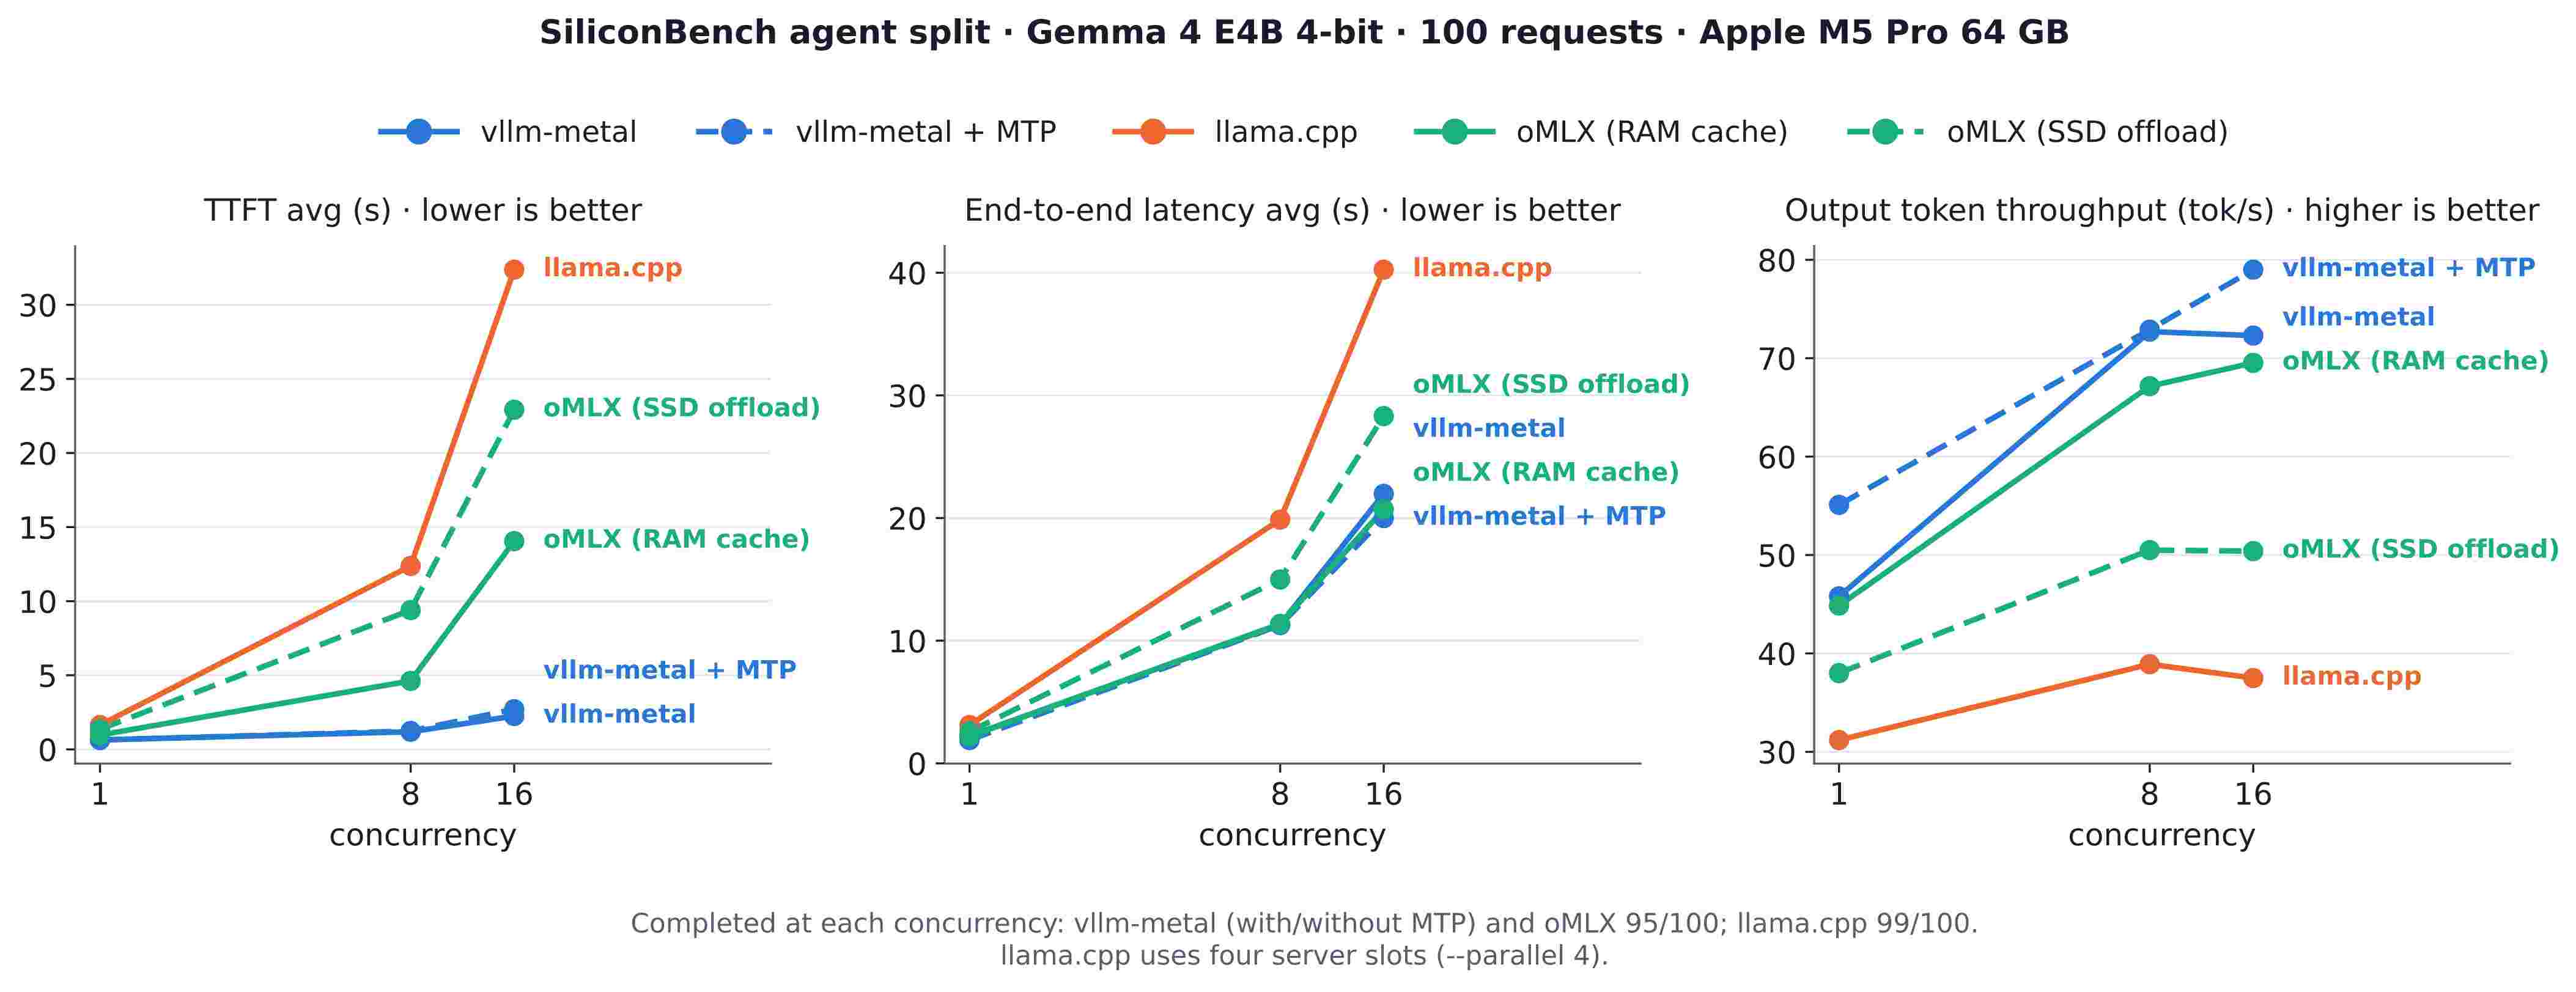
Kiểm thử tác nhân của SiliconBench trên Gemma 4 E4B: thời gian nhận token đầu tiên (TTFT), độ trễ từ đầu đến cuối của yêu cầu và thông lượng token đầu ra theo mức độ đồng thời, với llama.cpp, vllm-metal có và không có mô hình dự đoán MTP, cùng oMLX sử dụng bộ nhớ đệm tiền tố trong RAM hoặc trên SSD.
vllm-metal duy trì TTFT thấp trong toàn bộ phép thử này. llama.cpp sử dụng bốn ô máy chủ theo cấu hình mặc định.
Qwen3.6-35B-A3B
Qwen3.6-35B-A3B có tổng cộng 35 tỷ tham số, trong đó 3 tỷ tham số được kích hoạt cho mỗi token. Mô hình kết hợp các lớp hỗn hợp chuyên gia (MoE) với cơ chế chú ý tiêu chuẩn và cơ chế chú ý tuyến tính gated-delta-net (GDN).
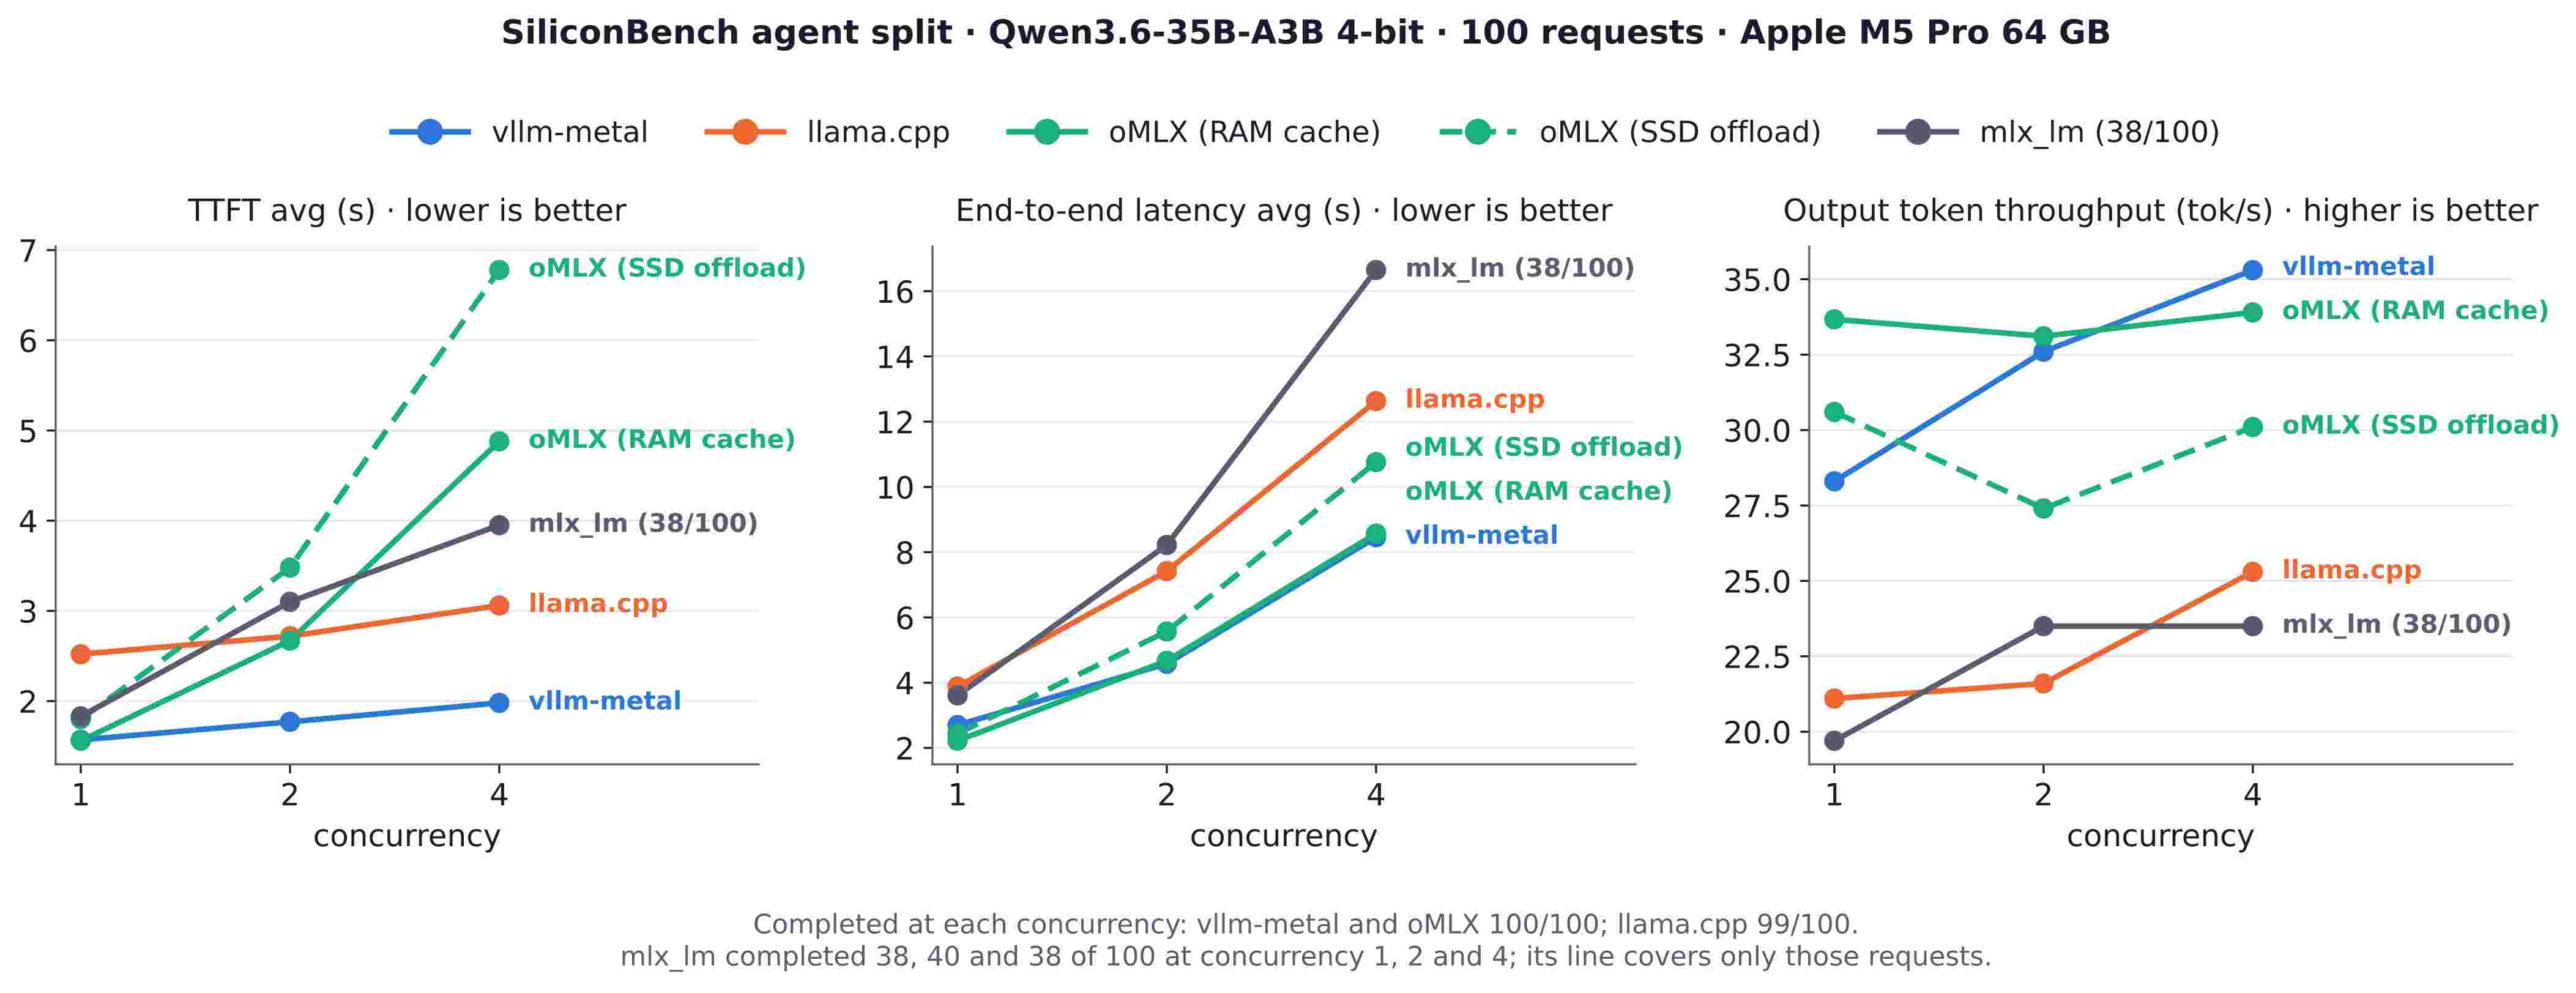
Kiểm thử tác nhân của SiliconBench trên Qwen3.6-35B-A3B: thời gian nhận token đầu tiên (TTFT), độ trễ đầu-cuối của yêu cầu và thông lượng token đầu ra theo mức độ đồng thời, với llama.cpp, vllm-metal, oMLX sử dụng bộ nhớ đệm tiền tố trong RAM hoặc trên SSD, cùng mlx_lm.
Ở mức đồng thời 4, vllm-metal và oMLX với bộ nhớ đệm RAM có thông lượng và độ trễ đầu-cuối khá tương đương nhau, nhưng chênh lệch về TTFT lớn hơn. Đường biểu diễn của mlx_lm chỉ bao phủ phần nhỏ các yêu cầu mà nó hoàn tất.
MTP theo lô dưới tải đồng thời
MTP sử dụng một mô hình dự đoán để dự đoán trước các token, sau đó mô hình đích kiểm tra các token này trong cùng một lô liên tục. Bảng dưới đây so sánh trường hợp dự đoán một token cho mỗi bước với trường hợp không sử dụng MTP trên Gemma 4 E4B:
| Mức đồng thời | Thời gian toàn bộ so với không MTP | Thông lượng token đầu ra so với không MTP | TTFT trung bình so với không MTP |
| 1 | −15% | +20% | −1% |
| 8 | −1% | +0% | +4% |
| 16 | −8% | +9% | +20% |
MTP được bật tùy chọn thông qua –speculative-config. Hiện tại, đường thực thi Metal hỗ trợ Gemma 4 với lấy mẫu tham lam thuần túy (temperature=0) và lập lịch đồng bộ (–no-async-scheduling).
Các tính năng khác trong v0.28.0
Tăng tốc nạp đầu vào trên M5
Trên các máy Mac dùng M5, vllm-metal tự động sử dụng hạt nhân chú ý NAX cho những lô nạp đầu vào tương thích. Hạt nhân này tận dụng phần cứng tensor của GPU. Các máy Mac đời trước vẫn sử dụng đường thực thi hiện có. Phép so sánh này sử dụng Qwen3-0.6B:
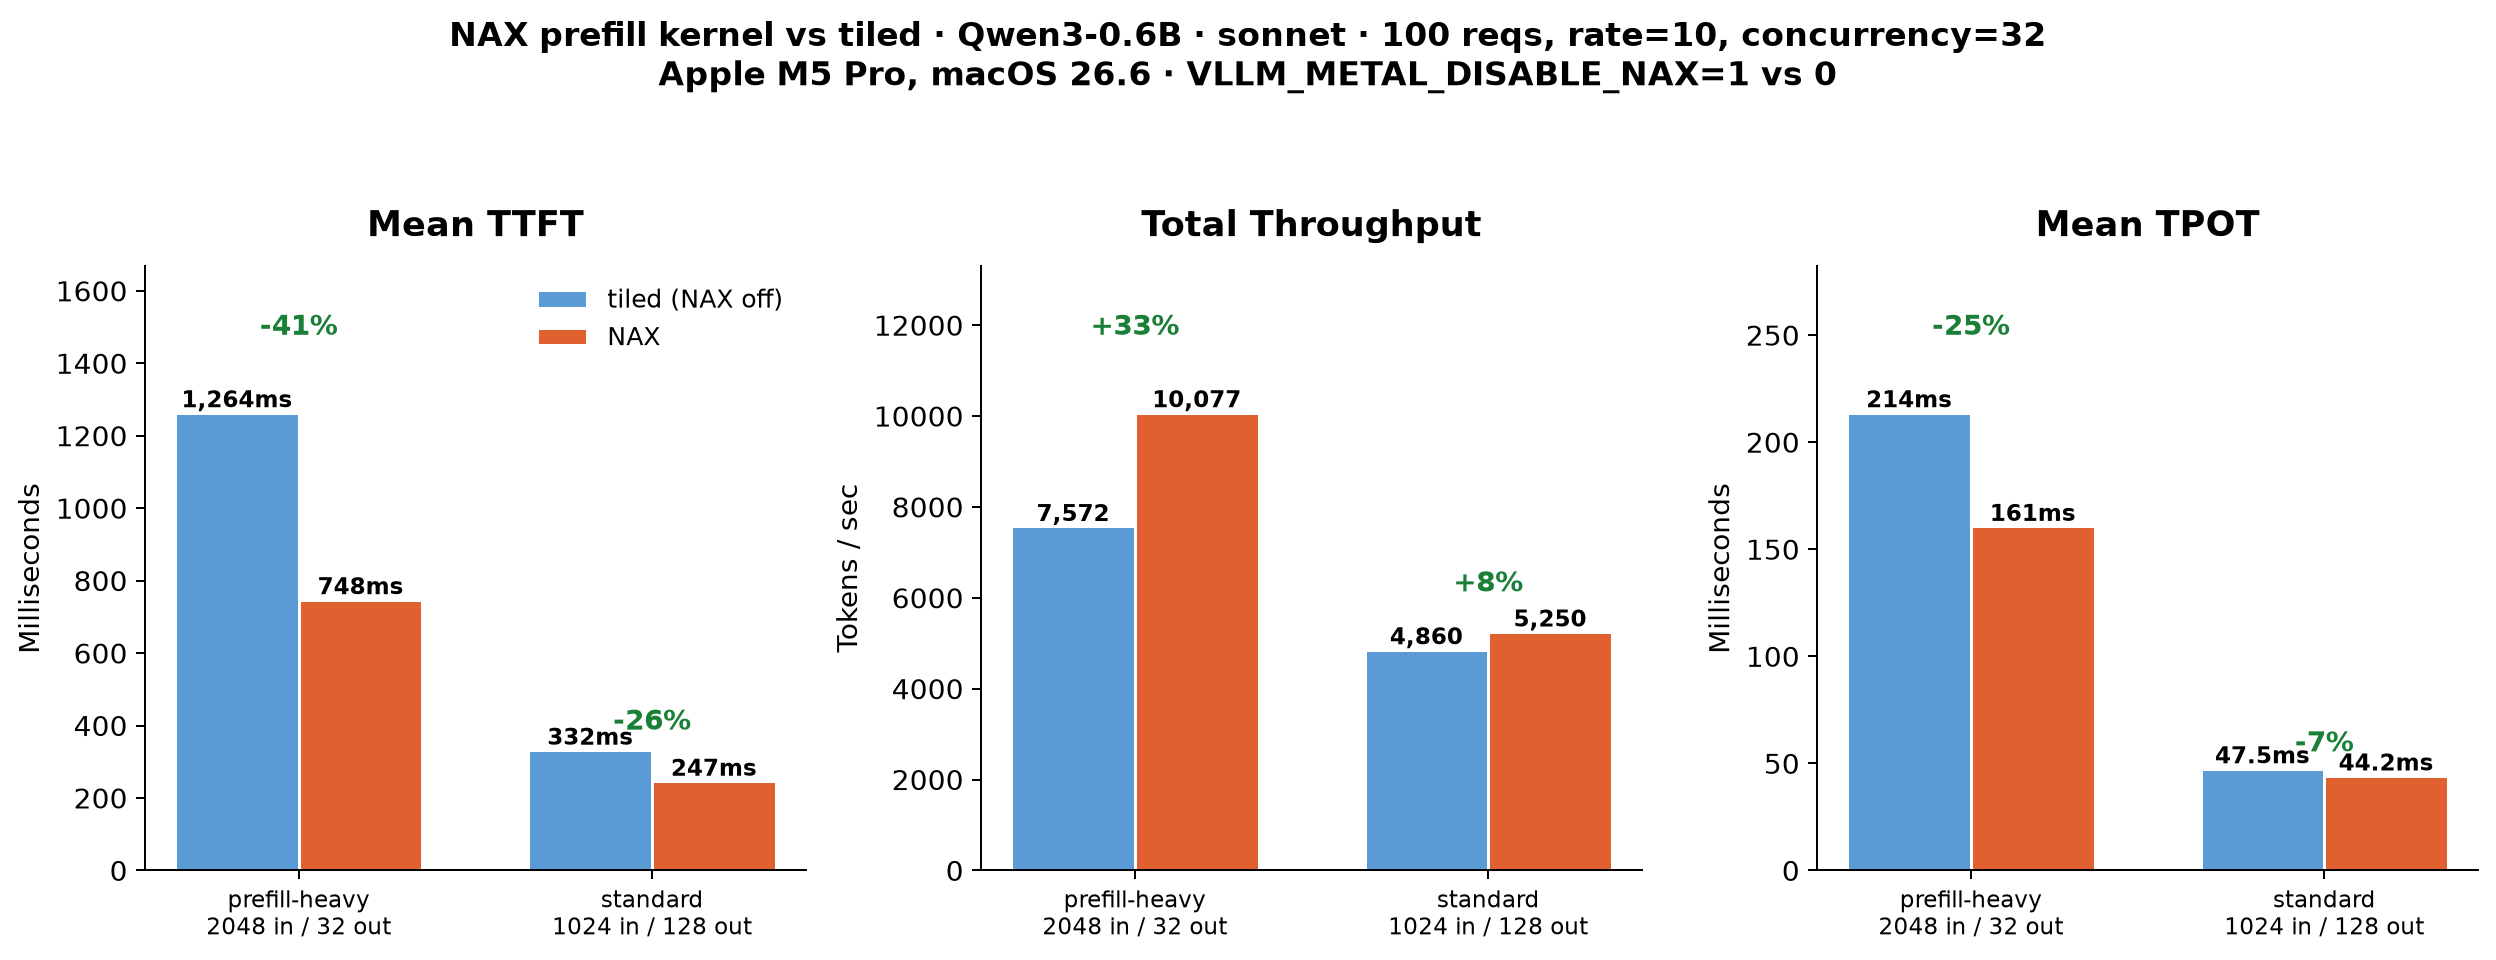
NAX so với chú ý chia ô trên Qwen3-0.6B: thời gian nhận token đầu tiên, tổng thông lượng token và thời gian cho mỗi token đầu ra.
Tái sử dụng lịch sử hội thoại trên các mô hình kết hợp
Các tác nhân nhiều lượt phải gửi lại phần lớn lịch sử hội thoại ngày càng dài ở mỗi lượt. Bộ nhớ đệm tiền tố cho phép lượt tiếp theo sử dụng lại các khối đã được tính toán ở những lượt trước, thay vì phải nạp lại toàn bộ lịch sử từ đầu.
Đối với các mô hình kết hợp kiểu Qwen3.5, vllm-metal hỗ trợ chế độ align của vLLM. Chế độ này lưu trạng thái hồi quy GDN tại cùng ranh giới khối với KV của cơ chế chú ý, cho phép cả hai tiếp tục xử lý từ một tiền tố đã được lưu trong bộ nhớ đệm (PR #634). Đường thực thi này vẫn đang trong giai đoạn thử nghiệm và hiện chưa thể sử dụng cùng giải mã suy đoán.
Mô hình và tính năng phục vụ
v0.28.0 cũng bổ sung:
-
-
-
- Bộ điều hợp LoRA, đầu ra có cấu trúc và ba phương pháp giải mã suy đoán: MTP cho Gemma 4, mô hình dự đoán riêng và n-gram tra cứu từ câu lệnh.
- Các điểm kiểm tra GGUF, bao gồm cả nguồn cấu hình từ Hugging Face cho trọng số GGUF cục bộ.
- Các mô hình có cơ chế chú ý kết hợp thuộc các dòng Qwen3.5, Qwen3.6, Qwen3.8 và Qwen3-Next.
- Xử lý song song theo đường ống trên nhiều máy Mac thông qua hệ thống vòng của MLX.
- Các mô hình ngôn ngữ-thị giác thử nghiệm, mô hình nhúng văn bản, mô hình xếp hạng lại và chuyển giọng nói thành văn bản.
-
-
Ma trận các mô hình được hỗ trợ và hướng dẫn về từng tính năng có trong tài liệu vllm-metal.
Cùng một nền tảng từ M1 Pro đến M5 Pro
Cùng một khối lượng công việc Gemma 4 E4B 4 bit đã được chạy ở mức đồng thời 1 và 8 trên bốn máy Mac.
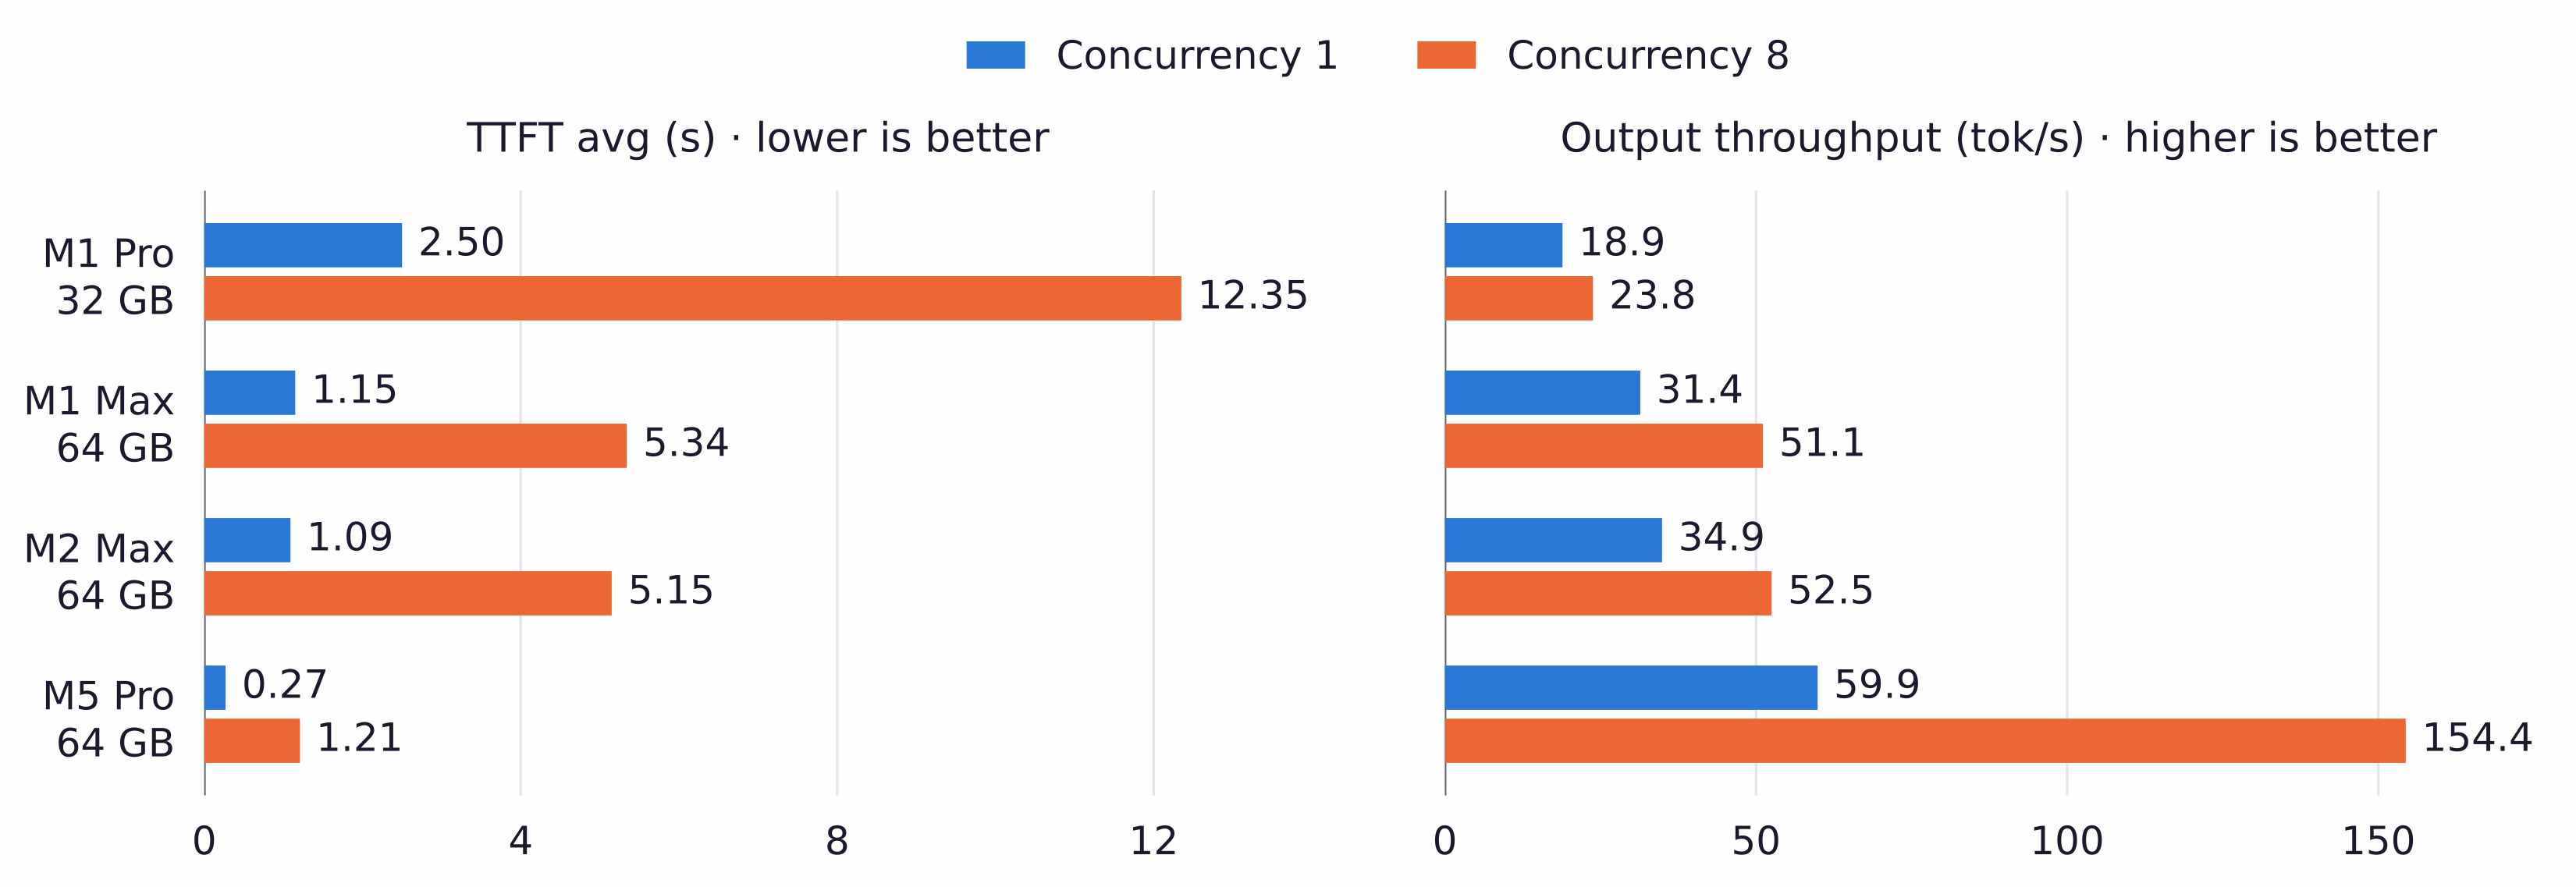
Hai biểu đồ cột đặt cạnh nhau, so sánh M1 Pro 32 GB, M1 Max 64 GB, M2 Max 64 GB và M5 Pro 64 GB ở mức đồng thời 1 và 8: bên trái là TTFT trung bình tính bằng giây (thấp hơn là tốt hơn), bên phải là thông lượng token đầu ra tính bằng token mỗi giây (cao hơn là tốt hơn).
Chạy phép đo hiệu năng giữa các máy
Mỗi lần chạy sử dụng vllm bench serve với 100 câu lệnh Sonnet, mỗi câu có khoảng 1.024 token đầu vào và 128 token đầu ra, –gpu-memory-utilization 0.5, tắt bộ nhớ đệm tiền tố và khởi động một máy chủ mới cho mỗi mức đồng thời.
Sử dụng vllm-metal v0.29.0 cùng vLLM 0.29.0 trên mọi máy. Cài đặt bản ổn định bằng Homebrew:
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal
Khởi động máy chủ trong một cửa sổ dòng lệnh:
vllm serve mlx-community/gemma-4-e4b-it-4bit \
  --gpu-memory-utilization 0.5 \
  --max-model-len 2048 \
  --no-enable-prefix-caching \
  --host 127.0.0.1 --port 8000
Trong một cửa sổ dòng lệnh khác, tải văn bản Sonnet xuống và chạy chương trình máy khách:
curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm/main/benchmarks/sonnet.txt \
  -o sonnet.txt

BENCH_MACHINE=m1pro-32gb
BENCH_CONCURRENCY=1

vllm bench serve \
  --backend vllm \
  --model mlx-community/gemma-4-e4b-it-4bit \
  --base-url http://127.0.0.1:8000 \
  --dataset-name sonnet --dataset-path sonnet.txt \
  --sonnet-input-len 1024 --sonnet-output-len 128 \
  --num-prompts 100 --num-warmups 3 \
  --request-rate 10 --max-concurrency "$BENCH_CONCURRENCY" \
  --temperature 0 --ignore-eos --seed 0 \
  --save-result --result-dir benchmark-results \
  --result-filename "${BENCH_MACHINE}-c${BENCH_CONCURRENCY}.json"
Đối với mức đồng thời 8, dừng máy chủ bằng Ctrl+C, khởi động lại bằng cùng lệnh rồi chạy lại phần lệnh của máy khách với BENCH_CONCURRENCY=8. Trên M5 Pro, đặt BENCH_MACHINE=m5pro-64gb; với mỗi máy bổ sung, hãy sử dụng một tên riêng.
Kết quả được lưu trong benchmark-results/. Các biểu đồ sử dụng TTFT trung bình (chia số mili giây cho 1.000 để đổi sang giây) và thông lượng token đầu ra. Hãy lưu lại số lượng yêu cầu hoàn tất cùng với từng kết quả.
Phụ lục: Tái hiện phép đo hiệu năng
Các tập lệnh và kết quả đo hiệu năng giữa các bộ máy nằm trong SiliconBench. Các lần chạy sử dụng vllm-metal 0.28.0.dev20260901062632 với vLLM 0.28.0, llama.cpp 0eadefeb và oMLX dc312e6e.
Các lần chạy sử dụng lấy mẫu tham lam trong một vòng lặp khép kín với mức đồng thời cố định. Kết quả chỉ bao gồm các yêu cầu đã hoàn tất; phản hồi rỗng được tính là thất bại. Mỗi bộ máy sử dụng cách chuyển đổi sang 4 bit riêng. Cấu hình bộ nhớ lần lượt là giá trị mặc định –gpu-memory-utilization 0.92 của vllm-metal, cơ chế kiểm soát bộ nhớ ở mức cân bằng của oMLX và không đặt giới hạn cụ thể cho llama.cpp.
Cấu hình phục vụ và chi tiết đo lường
Khởi động một máy chủ mới cho mỗi mức đồng thời và tạo một thư mục bộ nhớ đệm oMLX trống, kể cả khi sử dụng chế độ chỉ lưu trong RAM.
# llama.cpp
llama-server -m <model>.gguf --host 0.0.0.0 --port 8001 \
  -ngl 99 --parallel 4 -c 65536

# vllm-metal
vllm serve <model> --host 0.0.0.0 --port 8004 \
  --enable-prefix-caching --max-model-len 16384

# vllm-metal + MTP (Gemma only)
vllm serve <model> --host 0.0.0.0 --port 8004 \
  --enable-prefix-caching --max-model-len 16384 --no-async-scheduling \
  --speculative-config '{"method":"mtp","model":"mlx-community/gemma-4-E4B-it-assistant-bf16","num_speculative_tokens":1}'

# oMLX, SSD offload
omlx serve --model-dir <dir> --host 0.0.0.0 --port 8005 \
  --paged-ssd-cache-dir <fresh-empty-dir> --paged-ssd-cache-max-size 100GB \
  --hot-cache-max-size 0

# oMLX, RAM-only cache
OMLX_HOT_CACHE_ONLY=true omlx serve --model-dir <dir> --host 0.0.0.0 --port 8005 \
  --paged-ssd-cache-dir <fresh-empty-dir> --paged-ssd-cache-max-size 100GB \
  --hot-cache-max-size 8GB
Phép so sánh cách thêm đệm báo cáo trung vị của hai lần chạy với máy chủ mới cho mỗi ô trong bảng, mỗi lần gồm tám yêu cầu và 20 token đầu ra cho mỗi yêu cầu.
Phép thử A/B của NAX sử dụng Qwen3-0.6B với hai cấu hình: 2.048 token đầu vào / 32 token đầu ra và 1.024 token đầu vào / 128 token đầu ra. Với mỗi cấu hình, hệ thống chạy 100 câu lệnh Sonnet, tốc độ tiếp nhận 10 yêu cầu và mức đồng thời 32.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.