Mở rộng xử lý chú thích video trên nhiều GPU với PyNvVideoCodec và vLLM
Đội ngũ NVIDIA Computer Vision rất vui mừng thông báo rằng vLLM đã hỗ trợ giải mã video bằng phần cứng tích hợp trên GPU NVIDIA, cho phép mở rộng quy mô xử lý các tác vụ chú thích và gán nhãn video vốn trước đây bị giới hạn bởi CPU, tận dụng tối đa thông lượng trên các máy chủ trung tâm dữ liệu được trang bị nhiều GPU.
Chú thích video (video captioning) là một tác vụ phổ biến trong nhiều ngành, dùng để mô tả những gì đang diễn ra trong video. Khả năng này cho phép các hệ thống huấn luyện xe tự hành (AV) mô tả và phân loại những tình huống nguy hiểm, tạo ra siêu dữ liệu dễ đọc và có thể tìm kiếm, cùng nhiều ứng dụng khác.
Trước đây, khi vLLM xử lý các tập dữ liệu này, video phải được gửi đến bộ xử lý và chỉ có thể được giải mã thông qua OpenCV + FFMPEG, tức bộ giải mã chạy trên CPU.
Khi chạy các mô hình ngôn ngữ thị giác (VLM) trên các máy chủ có nhiều GPU – với mỗi GPU chạy một máy chủ vLLM riêng – CPU phải đảm nhận nhiều công việc hơn để giải mã các khung hình video trước khi VLM có thể bắt đầu suy luận.
Điều này đặc biệt đáng chú ý đối với tác vụ chú thích video, vì đầu ra tương đối ngắn, thường chỉ khoảng 100–200 token. Do đó, thời gian dành cho việc giải mã video chiếm tỷ trọng lớn hơn nhiều trong tổng thời gian xử lý. Việc giải mã video bằng CPU nhanh chóng trở thành nút thắt cổ chai, thậm chí có thể sử dụng hết các lõi CPU khi hệ thống mới chỉ có 2 hoặc 4 GPU.
Bằng cách tích hợp PyNvVideoCodec – một giao diện Python dành cho bộ giải mã video phần cứng của NVIDIA, còn được gọi là NVDEC – vLLM có thể chuyển phần công việc giải mã video từ CPU sang phần cứng chuyên dụng trên GPU, loại bỏ nút thắt nói trên và cho phép hệ thống mở rộng hiệu quả, lên tới 8 GPU.
Dưới đây là một ví dụ minh họa về prompt đầu vào và đầu ra cho tác vụ này. Trong thực tế, prompt thường chi tiết và có cấu trúc hơn.
Ví dụ về prompt đầu vào
Phân tích video từ camera hành trình phía trước này. Hãy mô tả ngắn gọn môi trường giao thông, những người tham gia giao thông có liên quan, các tín hiệu và biển báo giao thông, cũng như hành động của xe đang được quan sát. Chỉ nêu những chi tiết có thể nhìn thấy rõ và không suy đoán.
Ví dụ về đầu ra
Xe đang di chuyển trên một tuyến đường đô thị nhiều làn vào ban ngày, tầm nhìn rõ. Có một số phương tiện đang di chuyển phía trước, cả trong cùng làn và các làn bên cạnh, đồng thời phía trước có một nút giao thông có đèn tín hiệu. Xe vẫn giữ nguyên làn đường, giảm tốc khi đến gần dòng phương tiện phía trước và tiếp tục di chuyển, đồng thời duy trì khoảng cách với xe phía trước.
Sử dụng giải mã video bằng phần cứng NVIDIA trong vLLM
Cài đặt các thành phần cần thiết
Chức năng do PyNvVideoCodec cung cấp đã được tích hợp sẵn trong các bản phát hành vLLM tiêu chuẩn dành cho CUDA. Nếu bạn đang sử dụng bản vLLM tự cài đặt hoặc tùy chỉnh, hãy đảm bảo dự án của bạn có phần phụ thuộc PyPI sau: PyNvVideoCodec==2.0.4
Khởi chạy vLLM với bộ giải mã video PyNvVideoCodec
# First launch CUDA MPS Daemon
nvidia-cuda-mps-control -d

# Launch vLLM with pynvvideocodec video backend
vllm serve Qwen/Qwen3-VL-8B-Instruct \
  --dtype bfloat16 \
  --max-model-len 32768 \
  --max-num-seqs 1024 \
  --max-num-batched-tokens 32768 \
  --api-server-count 4 \
  --renderer-num-workers 4 \
  --async-scheduling \
  --mm-ipc-gpu-memory-gb 2 \
  --media-io-kwargs \    '{"video":{"backend":"pynvvideocodec","min_frames":16,"max_frames":16,"hw_decoders":2}}' \
  --mm-processor-kwargs \
    '{"size":{"shortest_edge":65536,"longest_edge":9437184}}'
CUDA MPS là thành phần rất quan trọng để đạt hiệu năng tốt khi chạy nhiều tiến trình với mức độ đồng thời cao, chẳng hạn như khi xử lý hàng loạt yêu cầu suy luận VLM. Trước khi chạy vllm serve, đội ngũ NVIDIA Computer Vision khuyến nghị kiểm tra và đảm bảo MPS Daemon đã được khởi động.
Tham số –mm-ipc-gpu-memory-gb được dùng để dành riêng một phần VRAM cho việc giải mã video. Bạn có thể thử nghiệm thông lượng với nhiều mức giá trị khác nhau và chỉ dành riêng lượng bộ nhớ nhỏ nhất mà không làm ảnh hưởng đến thông lượng. Để biết thêm thông tin về các tham số liên quan đến bộ giải mã PyNvVideoCodec, hãy xem tài liệu vLLM tương ứng.
Khi mở rộng xử lý lên nhiều GPU, thông thường đội ngũ NVIDIA Computer Vision khuyến nghị chạy mỗi bản sao máy chủ vLLM trong một container riêng và chỉ cấp một GPU cho mỗi container. Một cách khác là sử dụng CUDA_VISIBLE_DEVICES để chỉ định một GPU cho từng bản sao vLLM. Đội ngũ NVIDIA Computer Vision sử dụng reverse proxy để phân phối các yêu cầu đến các bản sao vLLM.
Mở rộng trên nhiều GPU cho tác vụ chú thích video
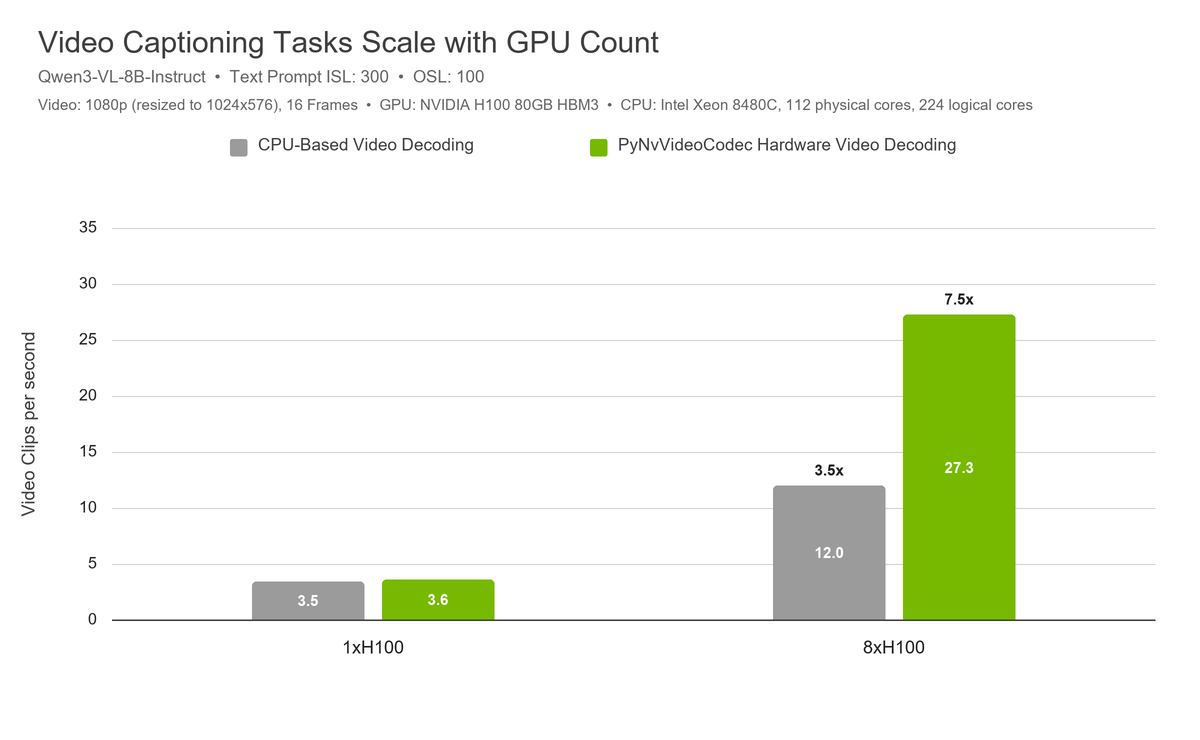
Hình 1: Khả năng mở rộng trên nhiều GPU được cải thiện với GPU H100. Khi sử dụng 8 GPU H100, giải mã video bằng GPU cho thông lượng cao hơn gấp đôi so với bộ giải mã video chạy trên CPU. Có 8 bản sao vLLM, mỗi bản sao sử dụng một GPU.
Để minh họa lợi ích của phương pháp này, hãy xem xét tác vụ chú thích video được sử dụng trong các hệ thống xe tự hành của NVIDIA. Các hệ thống này có nhiệm vụ chú thích hàng trăm nghìn giờ video, tương ứng với hàng trăm triệu yêu cầu chú thích video.
Những tác vụ này thường sử dụng các mô hình tương đối nhẹ, chẳng hạn như Qwen/Qwen3-VL-8B-Instruct. Mỗi yêu cầu có một prompt đầu vào xác định loại mô tả mong muốn và đầu ra thường có độ dài khoảng 100–200 token.
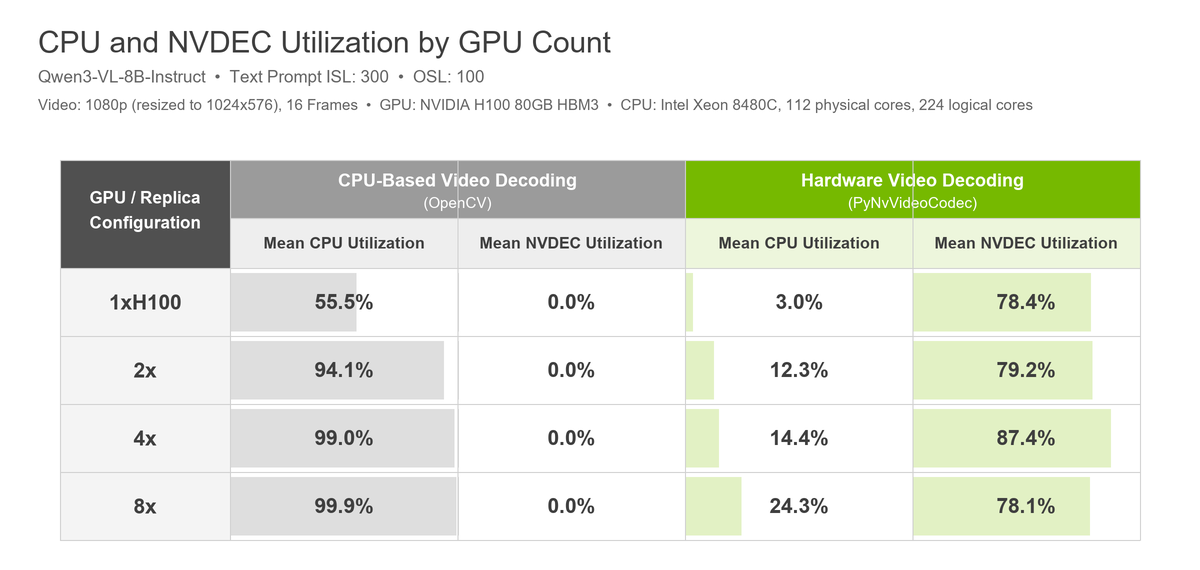
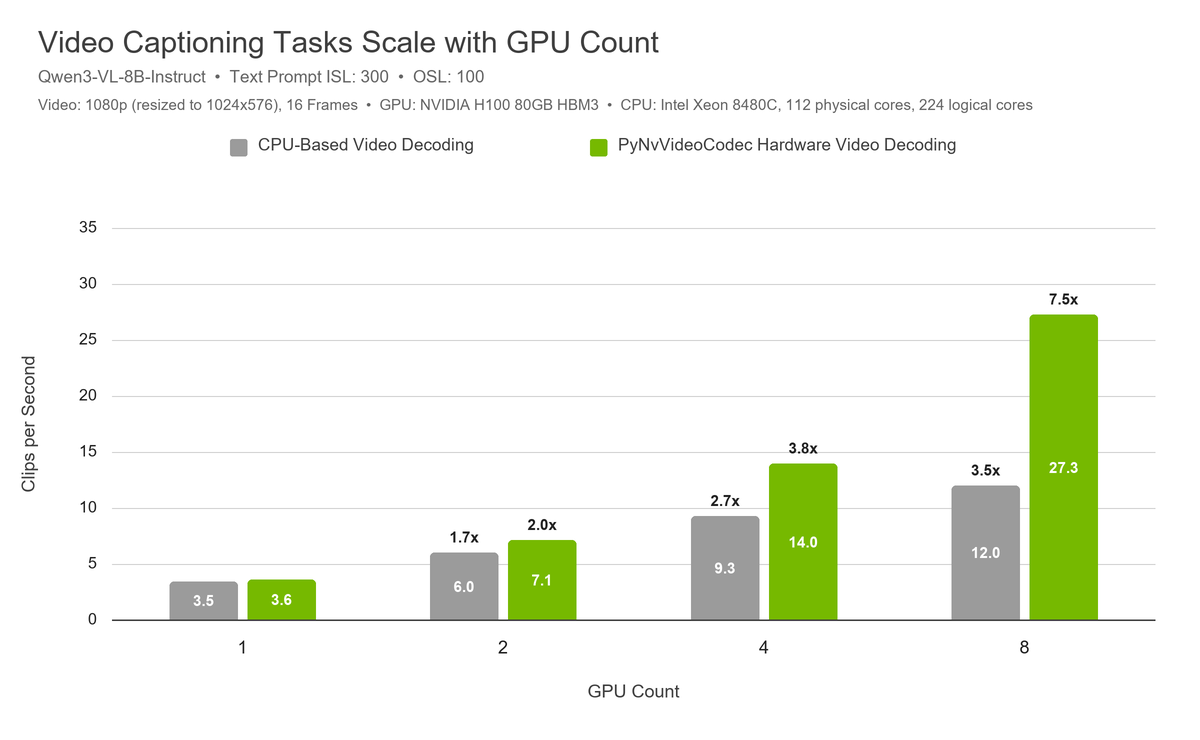
Hình 2: Trước đây, các tác vụ có quy mô lớn sử dụng tới 8 GPU thường bị giới hạn bởi khả năng xử lý của CPU ngay từ khi sử dụng 4 GPU. Với khả năng giải mã video bằng phần cứng, nút thắt ở CPU nay đã được loại bỏ. Dữ liệu được thu thập trong trạng thái hệ thống đã hoạt động ổn định khi đo hiệu năng.
Một số lưu ý
Cần lưu ý rằng việc giải mã video yêu cầu dành riêng một phần VRAM. Nếu hệ thống của bạn đã sử dụng toàn bộ VRAM cho KV cache, bạn có thể thấy hiệu năng bị ảnh hưởng ở một mức độ nào đó.
Tuy nhiên, trong các thử nghiệm thực tế, đội ngũ NVIDIA Computer Vision chưa ghi nhận trường hợp nào mà việc sử dụng PyNvVideoCodec làm giảm hiệu năng.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.