OCR hiện đại: Từ Nhận Diện Chữ Đến Document Understanding
OCR (Optical Character Recognition) từng được hiểu khá đơn giản: đưa một tấm ảnh hoặc file scan vào hệ thống, nhận diện các ký tự trên đó và chuyển chúng thành văn bản có thể tìm kiếm, sao chép hoặc chỉnh sửa.
Nhưng với tài liệu thực tế, đọc được chữ mới chỉ là bước đầu.
Một hóa đơn có số tiền nằm ở đâu? Tên khách hàng thuộc trường nào? Bảng có bao nhiêu cột? Tiêu đề nào liên quan đến đoạn nội dung bên dưới? Một biểu mẫu có những ô nào đã được điền? Đây là những câu hỏi mà OCR truyền thống khó trả lời nếu chỉ tập trung vào việc nhận diện ký tự.
Vì vậy, OCR hiện đại đang dần chuyển từ Text Recognition sang một bài toán rộng hơn: Document Understanding – giúp AI không chỉ đọc tài liệu mà còn hiểu cấu trúc và ngữ nghĩa bên trong đó.
1. OCR truyền thống đang làm gì?
Về cơ bản, một hệ thống OCR có nhiệm vụ phát hiện vùng chứa văn bản, nhận diện ký tự và trả về kết quả dạng text.
Ví dụ, từ một ảnh chụp:
“Invoice No: 2026-00125
Total: $1,250”
OCR có thể biến nội dung trên thành chuỗi văn bản tương ứng.
Điều này rất hữu ích cho việc số hóa tài liệu, tìm kiếm trong kho lưu trữ hoặc trích xuất thông tin cơ bản. Tuy nhiên, kết quả text thuần túy thường làm mất một phần thông tin quan trọng: vị trí, bố cục và mối quan hệ giữa các thành phần trên trang.
Với tài liệu đơn giản, điều này không quá nghiêm trọng. Nhưng với invoice, hợp đồng, báo cáo tài chính hay biểu mẫu nhiều cột, bố cục chính là một phần của ý nghĩa.
2. Từ OCR sang Layout Understanding
Bước tiến tiếp theo của OCR hiện đại là khả năng nhận biết layout của tài liệu.
Thay vì chỉ trả về:
Customer: Nguyen Van A | Total: 15,000,000
hệ thống có thể xác định:
- “Customer” là một label.
- “Nguyen Van A” là giá trị tương ứng.
- “Total” là trường tiền.
- “15,000,000” là giá trị của trường Total.
- Các thành phần nằm ở vị trí nào trên trang.
Đây là lúc Computer Vision và Document AI bắt đầu giao nhau.
Có thể hình dung quá trình phát triển này qua ba cấp độ:
Sự khác biệt nằm ở mức độ “hiểu” tài liệu. Ở cấp độ đầu tiên, AI chủ yếu trả lời “có những chữ gì?”. Sang cấp độ thứ hai, câu hỏi trở thành “chữ nằm ở đâu và thuộc phần nào?”. Đến cấp độ thứ ba, hệ thống phải xác định “thông tin này có ý nghĩa gì và cần được sử dụng như thế nào?”.
Model không chỉ nhìn từng ký tự riêng lẻ mà còn phân tích bounding box, vị trí tương đối, vùng nội dung, bảng, heading, paragraph, hình ảnh và các thành phần khác.
Với một tài liệu nhiều trang, hệ thống còn cần duy trì được cấu trúc giữa các trang thay vì xử lý mỗi trang như một hình ảnh độc lập.
3. Document Understanding là gì?
Document Understanding có thể xem là bước tiếp theo sau OCR.
Nếu OCR trả lời câu hỏi:“Tài liệu này viết gì?”
thì Document Understanding cố gắng trả lời:“Thông tin này có ý nghĩa gì và nằm trong cấu trúc nào?”
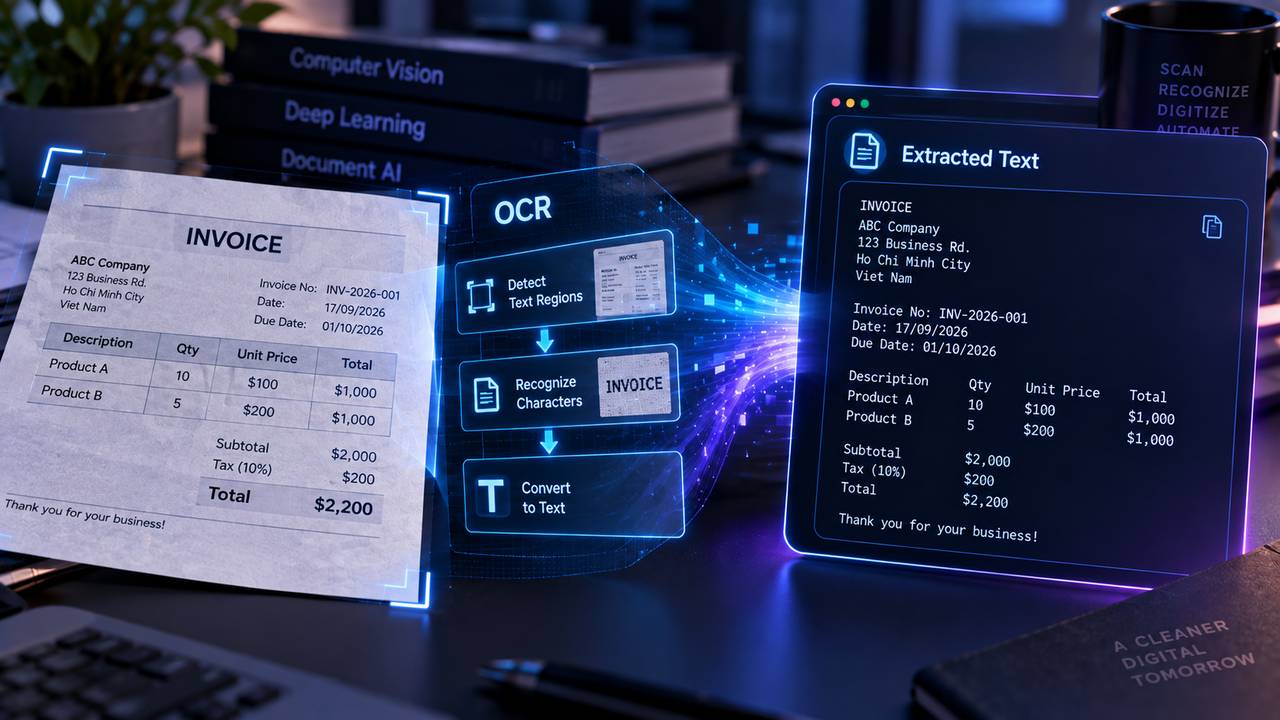
Ví dụ với một hóa đơn, hệ thống có thể nhận diện:
Document type: Invoice
Invoice number: INV-2026-001
Customer: ABC Company
Date: 17/09/2026
Items:
– Product A — 10 — $100
– Product B — 5 — $200
Subtotal: $2,000
Tax: $200
Total: $2,200
Đây là khác biệt rất lớn. Kết quả cuối cùng không còn là một đoạn text dài mà trở thành dữ liệu có cấu trúc, có thể đưa tiếp vào ERP, CRM, database hoặc workflow tự động.
4. Những thành phần chính của OCR hiện đại
Một pipeline Document AI thường không chỉ có một model duy nhất.
1. Document Image Preprocessing
Ảnh scan hoặc ảnh chụp thực tế có thể bị nghiêng, mờ, thiếu sáng, nhiễu hoặc biến dạng phối cảnh.
Preprocessing có thể bao gồm deskew, denoise, perspective correction, resize và image enhancement.
Chất lượng đầu vào ảnh hưởng trực tiếp đến những bước phía sau.
2. Text Detection
Model xác định vùng nào trên trang chứa chữ.
Đây là bài toán Computer Vision, thường sử dụng object detection hoặc text detection để tạo bounding box hoặc polygon quanh các vùng văn bản.
3. Text Recognition
Sau khi biết vùng chứa chữ, OCR engine thực hiện nhận diện nội dung bên trong.
Các hệ thống hiện đại có thể xử lý nhiều font, kích thước chữ, ngôn ngữ và chất lượng ảnh khác nhau tốt hơn đáng kể so với OCR dựa trên rule-based pipeline truyền thống.
4. Layout Analysis
Đây là bước rất quan trọng đối với Document Understanding.
Model phân biệt heading, paragraph, table, list, image, footer, header… và xác định mối quan hệ không gian giữa chúng.
5. Information Extraction
Cuối cùng, hệ thống chuyển nội dung thành thông tin có cấu trúc.
Ví dụ:
{
“invoice_number”: “INV-2026-001”,
“customer”: “ABC Company”,
“total”: 2200
}
Từ đây, dữ liệu có thể đi thẳng vào các hệ thống downstream mà không cần nhân viên nhập lại thủ công.
5. Vì sao AI đang thay đổi OCR?
Điểm khác biệt lớn nhất nằm ở khả năng hiểu ngữ cảnh.
Một từ “Total” trong tài liệu có thể xuất hiện ở nhiều vị trí khác nhau. OCR truyền thống chỉ cần đọc đúng chữ. Nhưng một hệ thống Document Understanding phải xác định “Total” nào là tổng tiền cuối cùng, giá trị nào đi kèm và nó thuộc phần nào của tài liệu.
Các mô hình Transformer và Vision-Language Model đang mở rộng khả năng này hơn nữa. Thay vì xử lý text và hình ảnh như hai phần hoàn toàn tách biệt, model có thể kết hợp thông tin thị giác, văn bản và vị trí để suy luận về nội dung tài liệu.
Đó cũng là lý do Document AI đang được ứng dụng trong nhiều bài toán như xử lý invoice, hợp đồng, hồ sơ bảo hiểm, chứng từ logistics, báo cáo tài chính và các biểu mẫu doanh nghiệp.
6.OCR không còn chỉ là “đọc chữ”
Điều thú vị nhất của OCR hiện đại là ranh giới giữa OCR và Computer Vision ngày càng mờ đi.
Một hệ thống tốt không chỉ cần nhận diện đúng từng ký tự mà còn phải hiểu:
chữ nằm ở đâu → thuộc thành phần nào → liên quan đến thông tin nào → và cuối cùng cần chuyển thành dữ liệu gì.
Đó chính là bước chuyển từ OCR → Layout Understanding → Document Understanding.
Trong tương lai, thay vì yêu cầu con người đọc và nhập lại dữ liệu từ hàng nghìn tài liệu, hệ thống AI có thể tự động đọc, phân loại, trích xuất và đưa thông tin vào đúng workflow.
Và khi khối lượng tài liệu tăng lên, bài toán không còn đơn thuần là chọn một OCR engine tốt. Nó trở thành bài toán tổng thể về model, pipeline, inference và GPU infrastructure.
OCR vì thế đang đi từ một công cụ nhận dạng ký tự trở thành một thành phần quan trọng trong hệ thống Document AI hiện đại.
7. GPU đóng vai trò gì trong OCR hiện đại?
Với một vài tài liệu mỗi ngày, CPU hoàn toàn có thể đáp ứng.
Nhưng khi hệ thống phải xử lý hàng nghìn hoặc hàng triệu trang, bài toán trở thành inference throughput.
Một pipeline thực tế có thể phải chạy nhiều model liên tiếp:
Image Preprocessing → Detection → OCR → Layout Analysis → Information Extraction
Nếu tài liệu có nhiều trang hoặc cần xử lý gần real-time, thời gian inference của từng stage bắt đầu cộng dồn.
GPU giúp tăng tốc các phép tính tensor và đặc biệt hữu ích khi pipeline sử dụng deep learning models có kích thước lớn. Với workload batch, GPU còn giúp xử lý nhiều tài liệu song song để tăng throughput.
Đây là lý do hạ tầng GPU trở thành một phần quan trọng khi xây dựng hệ thống Document AI ở quy mô lớn. Thay vì đầu tư ngay một cụm GPU vật lý, doanh nghiệp có thể thử nghiệm và scale workload trên hạ tầng cloud GPU như iRender, đặc biệt khi cần test model, benchmark throughput hoặc triển khai inference theo từng giai đoạn.
Tham khảo cấu hình và chi phí iRender tại đây.
Đăng ký tài khoản để trải nghiệm iRender AI hoặc liên hệ đội ngũ chăm sóc khách hàng của chúng tôi để được tư vấn cấu hình phù hợp.

FAQs
1. OCR hiện đại khác OCR truyền thống như thế nào?
OCR hiện đại không chỉ nhận diện ký tự mà còn có thể phân tích bố cục, vị trí và ngữ cảnh của nội dung trong tài liệu.
2. Layout Understanding là gì?
Layout Understanding giúp hệ thống xác định cấu trúc của tài liệu như heading, paragraph, bảng, hình ảnh, header và footer.
3. Document Understanding có phải là OCR không?
Không hoàn toàn. OCR tập trung vào việc đọc văn bản, trong khi Document Understanding đi xa hơn bằng cách hiểu cấu trúc, ngữ nghĩa và trích xuất dữ liệu có cấu trúc.
4. OCR hiện đại có thể xử lý hóa đơn không?
Có. Các hệ thống Document AI có thể nhận diện số hóa đơn, ngày tháng, thông tin khách hàng, bảng sản phẩm, thuế và tổng tiền.
5. GPU có cần thiết cho hệ thống OCR không?
Không phải mọi hệ thống OCR đều cần GPU. Tuy nhiên, GPU có thể giúp tăng tốc inference và throughput khi phải xử lý lượng lớn tài liệu hoặc sử dụng các model AI phức tạp.
6. Document Understanding được ứng dụng ở đâu?
Công nghệ này được sử dụng trong nhiều lĩnh vực như xử lý hóa đơn, hợp đồng, hồ sơ bảo hiểm, chứng từ logistics, báo cáo tài chính và tự động hóa quy trình doanh nghiệp.
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.