3D Computer Vision: Khi AI Bắt Đầu Hiểu Không Gian
Computer Vision từ lâu đã giúp máy tính “nhìn thấy” thế giới thông qua hình ảnh. AI có thể nhận diện khuôn mặt, phát hiện vật thể, đọc chữ hay phân loại một bức ảnh.
Nhưng có một vấn đề: một bức ảnh chỉ cho AI biết thế giới trông như thế nào từ một góc nhìn.
Chiếc xe đang ở đâu? Khoảng cách từ camera đến chiếc xe là bao nhiêu? Một vật thể nằm trước hay sau vật thể khác? Không gian phía trước còn bao nhiêu chỗ trống?
Để trả lời những câu hỏi này, AI cần nhiều hơn việc nhận diện hình ảnh. Nó cần hiểu chiều sâu, khoảng cách và cấu trúc không gian 3D.
Đó chính là nơi 3D Computer Vision bắt đầu trở nên quan trọng.
1. 3D Computer Vision là gì?
3D Computer Vision là nhóm công nghệ giúp máy tính phân tích và hiểu thế giới dưới dạng không gian ba chiều, thay vì chỉ xử lý hình ảnh 2D.
Nếu Computer Vision truyền thống có thể nhận ra:
“Đây là một chiếc ghế.”
thì 3D Computer Vision có thể đi xa hơn:
“Chiếc ghế nằm cách camera khoảng 2 mét, có kích thước như vậy và đang nằm ở vị trí này trong không gian.”
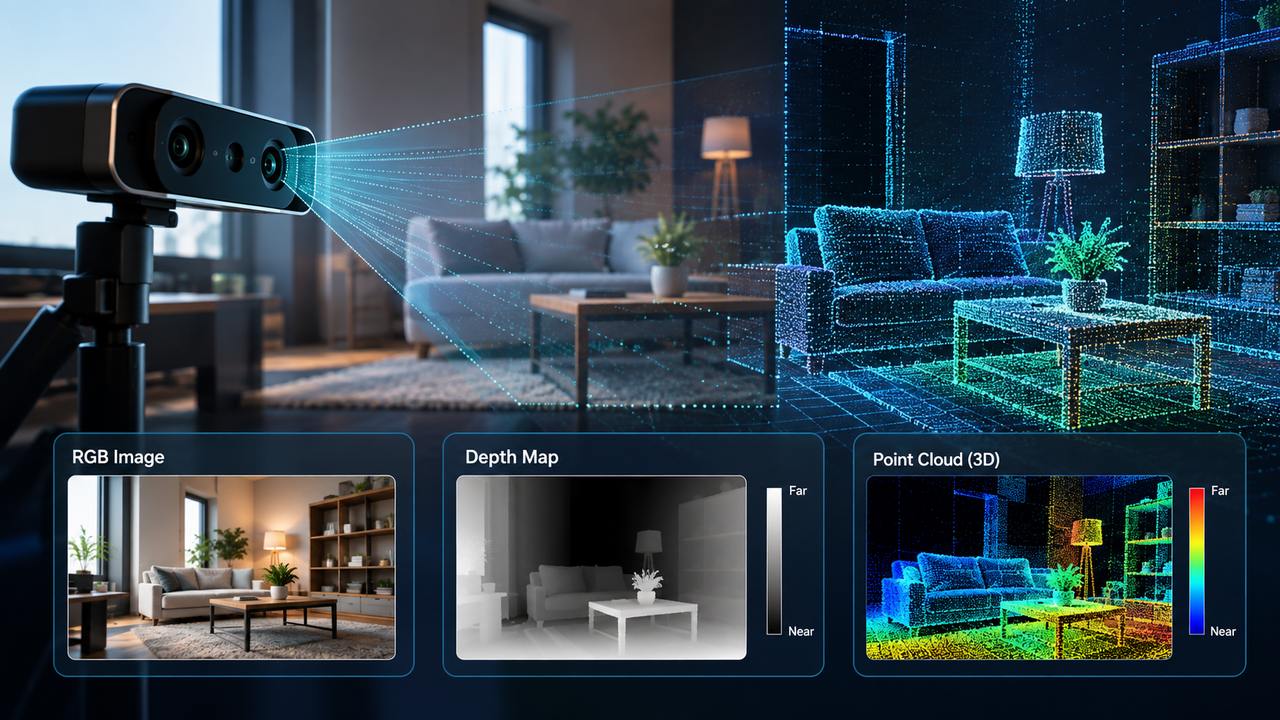
Thông tin 3D có thể được biểu diễn dưới nhiều dạng như depth map, point cloud, voxel hoặc mesh.
Trong đó, point cloud là một cách biểu diễn khá phổ biến. Thay vì một ảnh gồm các pixel, point cloud chứa tập hợp các điểm trong không gian, mỗi điểm có tọa độ 3D và đôi khi đi kèm màu sắc hoặc các thuộc tính khác.
Nhờ vậy, AI có thể bắt đầu “nhìn” thế giới theo cách gần với không gian thực hơn.
2. AI lấy thông tin chiều sâu từ đâu?
Không phải camera nào cũng trực tiếp cung cấp dữ liệu 3D. Có nhiều phương pháp khác nhau để thu được thông tin chiều sâu.
Stereo Vision – nhìn bằng hai mắt
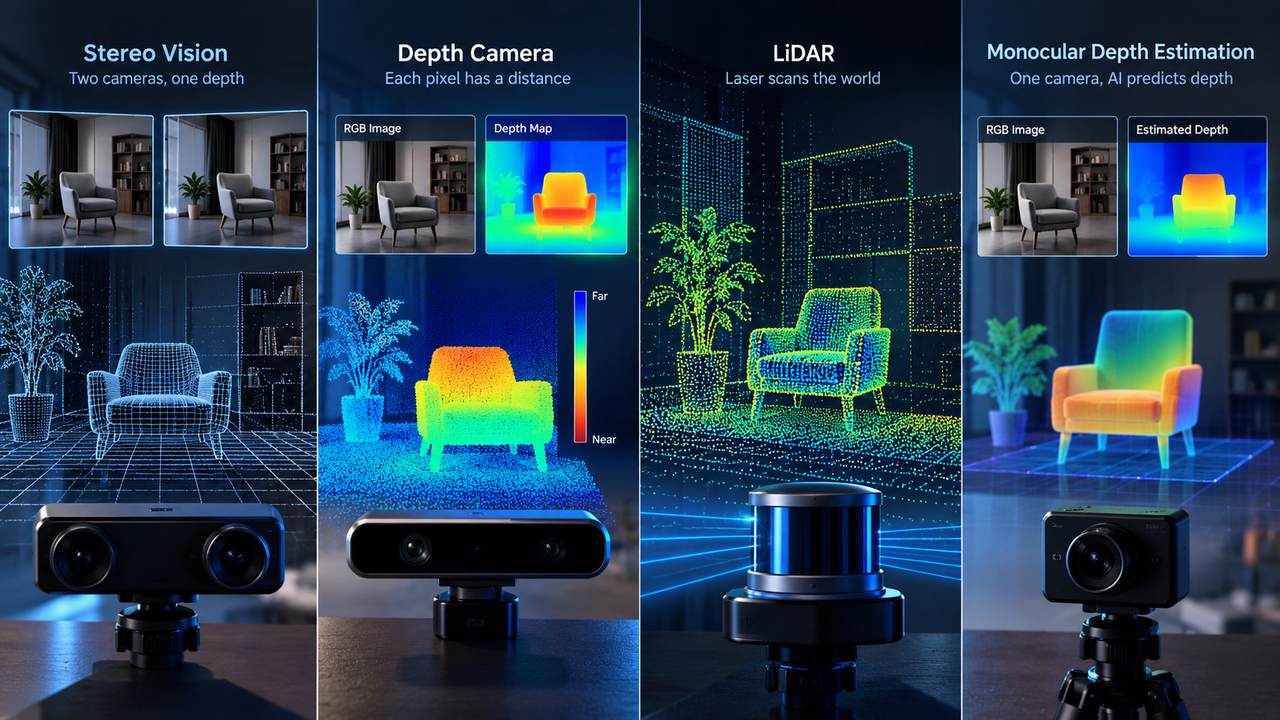
Stereo Vision sử dụng hai camera đặt ở những vị trí khác nhau. Tương tự cách hai mắt người tạo ra cảm nhận chiều sâu, hệ thống so sánh hai hình ảnh để ước tính khoảng cách đến vật thể.
Ví dụ: một robot nhìn thấy một chiếc hộp trước mặt. Camera bên trái và bên phải nhìn chiếc hộp ở hai vị trí hơi khác nhau. Từ độ lệch giữa hai hình ảnh, AI có thể tính được chiếc hộp cách robot bao xa.
Nói đơn giản:
2 camera → 2 góc nhìn → tính độ lệch → suy ra khoảng cách.
Phương pháp này phù hợp với robot, drone, hệ thống navigation hoặc các thiết bị cần nhận biết độ sâu nhưng không muốn phụ thuộc vào LiDAR.
Depth Camera – mỗi pixel có thêm “độ sâu”
Depth Camera cung cấp hình ảnh kèm thông tin khoảng cách. Thay vì mỗi pixel chỉ có giá trị màu RGB, hệ thống còn biết pixel đó nằm cách camera bao xa.
Ví dụ: khi một người đứng trước camera, hệ thống có thể tạo ra depth map trong đó khuôn mặt, thân người và background có các mức độ sâu khác nhau.
Nhờ vậy, AI không chỉ thấy:“Có một người.”
mà còn có thể xác định:“Người này đang đứng cách camera khoảng X mét.”
Depth camera thường hữu ích trong robot, gesture recognition, 3D scanning và các ứng dụng tương tác với môi trường.
LiDAR – đo không gian bằng laser
LiDAR hoạt động theo một cách khác. Cảm biến phát các xung laser ra môi trường và đo thời gian ánh sáng quay trở lại sau khi phản xạ từ vật thể.
Kết quả là một tập hợp lớn các điểm trong không gian, tạo thành point cloud 3D.
Ví dụ: một chiếc xe tự hành di chuyển trên đường. LiDAR có thể tạo ra point cloud của toàn bộ khu vực phía trước, từ xe hơi, người đi bộ, cây cối cho đến các vật thể bên đường.
AI sau đó có thể sử dụng dữ liệu này để xác định:
“Vật thể này ở đâu?” → “Cách bao xa?” → “Đang di chuyển theo hướng nào?”
LiDAR đặc biệt hữu ích khi cần thông tin hình học 3D tương đối chính xác và phạm vi quan sát rộng.
Monocular Depth Estimation – một camera cũng có thể ước tính 3D
Đây là hướng thú vị hơn: chỉ sử dụng một camera 2D nhưng để AI tự suy luận chiều sâu.
Không có camera thứ hai và cũng không nhất thiết phải có LiDAR. Model deep learning học các dấu hiệu trong hình ảnh để ước tính vật thể nào gần, vật thể nào xa.
Ví dụ: nhìn một bức ảnh con đường, AI có thể nhận ra những chiếc xe ở gần thường có kích thước lớn hơn, đường hội tụ về phía xa và các vật thể ở đường chân trời nhỏ hơn. Từ những dấu hiệu này, model tạo ra một depth map ước tính.
Tất nhiên, đây là ước tính, không phải phép đo trực tiếp. Nhưng với những bài toán mà chi phí cảm biến là yếu tố quan trọng, monocular depth estimation mở ra một hướng rất đáng chú ý.
Có thể hình dung bốn phương pháp này như sau:
Điểm quan trọng là không có một phương pháp duy nhất phù hợp cho mọi bài toán. Hệ thống thực tế còn có thể kết hợp nhiều nguồn dữ liệu, chẳng hạn camera + LiDAR, để tận dụng ưu điểm của từng cảm biến.
3. Từ nhận diện vật thể đến hiểu vị trí
Đây là điểm khiến 3D Computer Vision khác đáng kể so với Computer Vision 2D.
Trong một hệ thống 2D Object Detection, kết quả có thể đơn giản là một bounding box:
Car → x1, y1, x2, y2
Nhưng trong không gian 3D, thông tin có thể trở thành:
Car → X, Y, Z + chiều rộng + chiều cao + chiều dài + hướng
AI lúc này không chỉ biết “có một chiếc xe”, mà còn biết chiếc xe đang nằm ở đâu trong không gian.
Điều này đặc biệt quan trọng với robot và hệ thống tự hành. Một robot muốn di chuyển trong phòng không thể chỉ biết “có một cái bàn”. Nó cần biết cái bàn nằm ở đâu, cao bao nhiêu và khoảng trống nào có thể đi qua.
4. Point Cloud và bài toán hiểu không gian
Point cloud thường xuất hiện trong các hệ thống 3D Vision hiện đại.
Một scene thực tế có thể được chuyển thành hàng triệu điểm 3D. Model sau đó phải tìm ra cấu trúc ẩn phía sau những điểm dữ liệu này.
Ví dụ, từ một point cloud của nhà kho, hệ thống có thể phân biệt:
- sàn nhà;
- kệ hàng;
- pallet;
- robot;
- người;
- các vật thể đang di chuyển.
Đây là một bài toán khó hơn nhiều so với việc phân loại một bức ảnh.
Lý do nằm ở quy mô dữ liệu. Một point cloud có thể chứa lượng thông tin rất lớn và các điểm không được sắp xếp thành một lưới đều đặn như pixel trong ảnh.
Các kiến trúc deep learning chuyên biệt vì thế được phát triển để xử lý point cloud, 3D detection và 3D segmentation hiệu quả hơn.
5. 3D Computer Vision được dùng ở đâu?
Ứng dụng của 3D Vision đang mở rộng khá nhanh.
Robot và Automation là một ví dụ điển hình. Robot cần hiểu vị trí của vật thể để có thể gắp, di chuyển hoặc thao tác chính xác.
Trong Autonomous Driving, hệ thống cần kết hợp camera, LiDAR và các cảm biến khác để nhận diện phương tiện, người đi bộ, làn đường và khoảng cách giữa các vật thể.
Trong AR/VR, hiểu không gian giúp thiết bị xác định mặt phẳng, vị trí vật thể và xây dựng representation của môi trường xung quanh.
Trong 3D Reconstruction, AI có thể sử dụng nhiều hình ảnh hoặc dữ liệu cảm biến để tái tạo lại một không gian hoặc vật thể dưới dạng 3D.
Ngay cả retail, logistics và manufacturing cũng có thể tận dụng 3D Vision để đo kích thước, kiểm tra sản phẩm, theo dõi hàng hóa hoặc tự động hóa quy trình kiểm tra.
6. Tại sao 3D Vision cần GPU mạnh?
Nếu một hệ thống chỉ xử lý một vài ảnh thì yêu cầu phần cứng có thể không quá lớn.
Nhưng 3D Computer Vision thường phải xử lý lượng dữ liệu đáng kể.
Một pipeline có thể bao gồm:
Camera / LiDAR → Preprocessing → Depth Estimation → 3D Detection → Segmentation → Tracking → Spatial Understanding
Mỗi stage lại có thể sử dụng một model deep learning riêng.
Đặc biệt, point cloud với hàng trăm nghìn hoặc hàng triệu điểm khiến computational workload tăng nhanh. Khi hệ thống cần xử lý nhiều camera hoặc chạy real-time, GPU gần như trở thành một thành phần rất quan trọng của pipeline.
GPU không chỉ giúp inference nhanh hơn mà còn hữu ích trong quá trình training, fine-tuning và benchmark các model 3D.
Với những team cần thử nghiệm nhiều model hoặc workload thay đổi theo dự án, cloud GPU có thể là lựa chọn linh hoạt hơn việc phải đầu tư sẵn một hệ thống phần cứng cố định. Đây cũng là một trong những trường hợp mà hạ tầng GPU như iRender có thể được sử dụng để chạy training, inference hoặc benchmark cho các workload Computer Vision.
7. Từ “nhìn thấy” đến “hiểu không gian”
Điểm thú vị của 3D Computer Vision không nằm ở việc biến ảnh 2D thành 3D đơn thuần. Mục tiêu lớn hơn là giúp AI xây dựng một mô hình về thế giới xung quanh.
Từ pixel → depth → point cloud → object → spatial relationship, hệ thống dần có thêm khả năng suy luận về khoảng cách, vị trí và tương tác giữa các vật thể.
Đây cũng là một trong những bước quan trọng để AI có thể hoạt động tốt hơn trong thế giới vật lý.
Một model có thể nhận diện chiếc ghế trong ảnh là một chuyện. Nhưng để robot biết chiếc ghế nằm ở đâu, có thể đi vòng qua hay không và phải di chuyển thế nào để tránh nó lại là một bài toán hoàn toàn khác.
3D Computer Vision chính là cây cầu nối giữa hai khả năng đó.
8. Khi Computer Vision tiến vào thế giới thực
Computer Vision 2D giúp AI nhìn thế giới qua hình ảnh. 3D Computer Vision giúp AI bắt đầu hiểu thế giới tồn tại trong không gian như thế nào.
Khi kết hợp 3D Vision với AI, robotics, LiDAR, sensor fusion và GPU acceleration, chúng ta đang tiến gần hơn đến những hệ thống có thể không chỉ nhận diện môi trường mà còn tương tác với môi trường đó.
Và khi dữ liệu 3D ngày càng lớn, bài toán không chỉ còn là chọn model nào tốt. Doanh nghiệp còn phải quan tâm đến GPU, VRAM, inference throughput, pipeline architecture và khả năng scale.
Nếu đang phát triển các dự án 3D Computer Vision, AI inference, robotics, LiDAR processing hoặc spatial AI, việc có một hạ tầng GPU linh hoạt để thử nghiệm và mở rộng workload sẽ giúp quá trình triển khai dễ chủ động hơn.
iRender AI cung cấp GPU Cloud bare-metal với hiệu năng GPU cao, băng thông PCIe mạnh, Root Access và khả năng scale linh hoạt, phù hợp cho các workload như Computer Vision, Video Analytics và Real-time Inference. Mô hình tính phí theo thời gian sử dụng giúp doanh nghiệp chủ động kiểm soát chi phí mà không phải đầu tư hạ tầng GPU cố định.
Tham khảo cấu hình và chi phí iRender tại đây.
Đăng ký tài khoản iRender AI để trải nghiệm GPU Cloud hoặc liên hệ đội ngũ chăm sóc khách hàng để được tư vấn cấu hình phù hợp với nhu cầu Video AI của bạn.

FAQs
- 3D Computer Vision là gì?
3D Computer Vision giúp AI hiểu hình ảnh trong không gian ba chiều, bao gồm chiều sâu, khoảng cách, vị trí và kích thước của vật thể.
2. 3D Computer Vision khác Computer Vision 2D như thế nào?
Computer Vision 2D chủ yếu xác định vật thể trong hình ảnh, còn 3D Computer Vision có thể xác định thêm vị trí và mối quan hệ không gian giữa các vật thể.
3. Những cảm biến nào thường được dùng cho 3D Vision?
Các công nghệ phổ biến gồm Stereo Camera, Depth Camera và LiDAR. Ngoài ra, AI còn có thể ước tính chiều sâu từ một camera duy nhất bằng Monocular Depth Estimation.
4. Point Cloud là gì?
Point Cloud là tập hợp các điểm có tọa độ trong không gian 3D, thường được tạo từ LiDAR hoặc các hệ thống cảm biến 3D để mô tả hình dạng và cấu trúc của môi trường.
5. 3D Computer Vision được ứng dụng ở đâu?
Công nghệ này được sử dụng trong robotics, autonomous driving, AR/VR, 3D reconstruction, logistics, manufacturing và nhiều hệ thống tự động hóa khác.
6. 3D Computer Vision có cần GPU mạnh không?
Không phải mọi workload đều cần GPU mạnh, nhưng GPU đặc biệt hữu ích khi xử lý point cloud lớn, training deep learning model hoặc triển khai inference real-time với nhiều dữ liệu cảm biến.
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.