Cách huấn luyện DSpark nhanh nhất cho Kimi-K3 trên GB300 NVL72
Vào tháng 6, DeepSeek công bố DSpark, một phần mở rộng của thuật toán giải mã suy đoán ở cấp độ khối DFlash. Thuật toán mới hứa hẹn cải thiện khả năng liên kết giữa các token, từ đó tạo ra các chuỗi token được chấp nhận dài hơn.
Nhưng với cộng đồng mã nguồn mở, câu hỏi quan trọng vẫn luôn là: liệu chúng ta có thể tự huấn luyện, đóng gói và triển khai nó mà không cần một nghiên cứu sinh tiến sĩ phải ngồi trông từng checkpoint hay không?
Nhờ thư viện huấn luyện Speculators của dự án vLLM, câu trả lời là hoàn toàn có thể!
Với Speculators, việc huấn luyện, đóng gói và triển khai các mô hình dự đoán DSpark trở nên đơn giản. Các mô hình được lưu dưới định dạng tiêu chuẩn, tương thích với Hugging Face và có thể được vLLM tải trực tiếp.
Cách triển khai này đã được kiểm chứng trên Qwen3.6-35B-A3B, Gemma-4-31B-it, GLM-5.2 và nhiều mô hình khác.
Bài viết này sẽ trình bày cách mở rộng thư viện huấn luyện để hỗ trợ Kimi K3, một mô hình tiên phong với 2,8 nghìn tỷ tham số.
Mô hình dự đoán DSpark mới này tăng tốc độ tương tác trên một luồng từ khoảng 110 lên khoảng 435 token/giây/người dùng đối với các tác vụ suy luận toán học. Đồng thời, khi có nhiều yêu cầu chạy đồng thời, nó có thể đạt thông lượng đầu ra cao hơn tới khoảng 3,5 lần ở cùng mức độ tương tác.
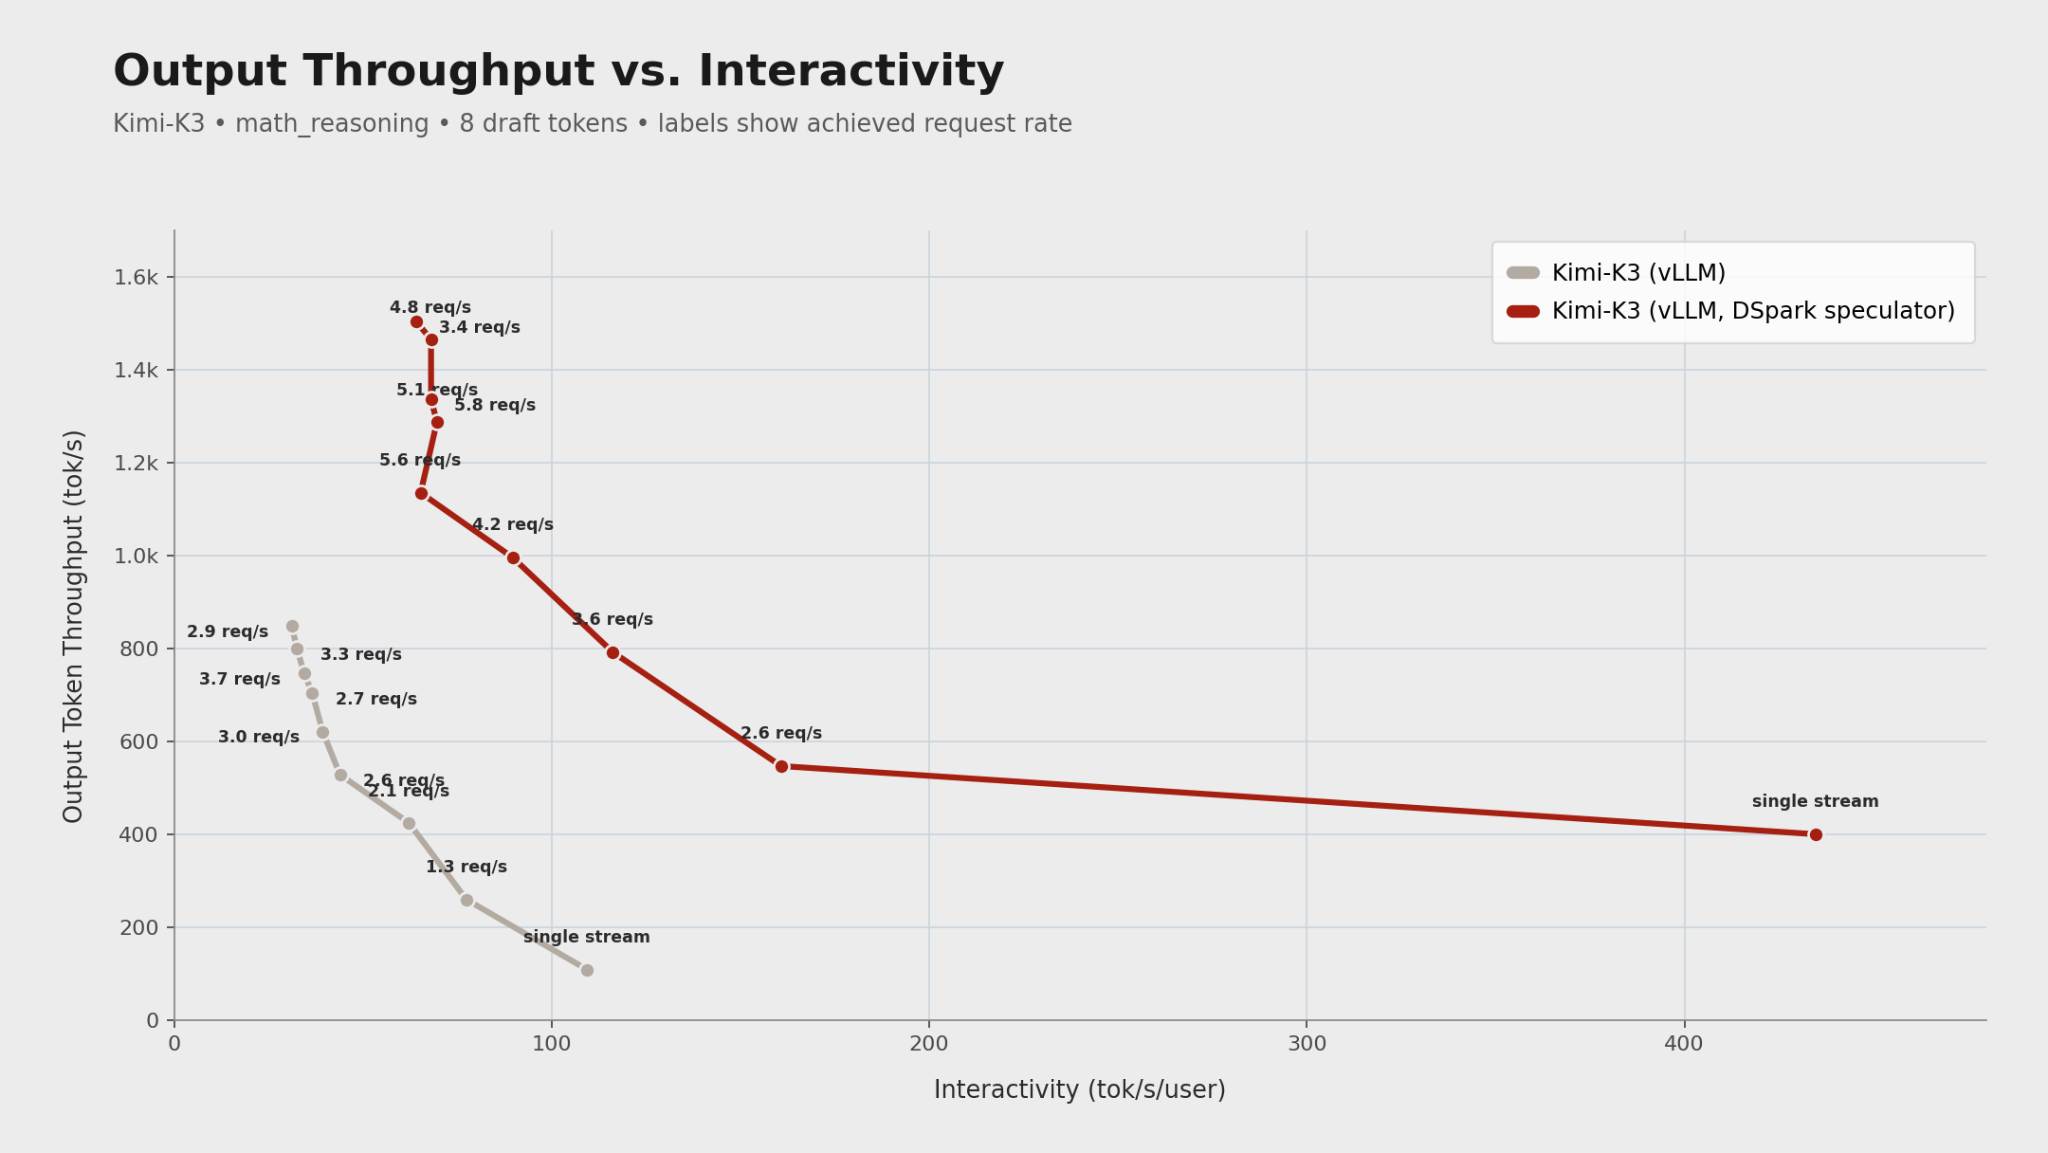
Hình 1. Mô hình dự đoán DSpark cho Kimi K3 cải thiện cả tốc độ tương tác trên một luồng lẫn tổng thông lượng đầu ra đối với các tác vụ suy luận toán học.
DSpark là gì?
Các mô hình ngôn ngữ lớn sinh văn bản từng token, mỗi lần thực hiện một lượt forward pass. Giải mã suy đoán tăng tốc quá trình này bằng cách sử dụng một mô hình dự đoán nhỏ và nhẹ để đề xuất trước một số token, sau đó mô hình đích đầy đủ sẽ kiểm tra tất cả các token đó cùng lúc.
EAGLE-3 là một phương pháp nền tảng mạnh, nhưng vẫn tạo token theo cách tự hồi quy: để đề xuất 7 token cần thực hiện 7 bước dự đoán tuần tự.
Ngược lại, DFlash dự đoán toàn bộ một khối token chỉ trong một lượt chạy backbone không nhân quả (non-causal), và báo cáo mức tăng tốc lên tới 2,5 lần so với EAGLE-3.
Đổi lại, các vị trí được xử lý song song không thể dựa vào thông tin của nhau.
Ví dụ, với prompt “Thank you!”, tại vị trí đầu tiên mô hình có thể đồng thời nghiêng về cả “Of” và “No”, còn ở vị trí tiếp theo có thể nghiêng về cả “course” và “problem”. Điều này có thể tạo ra những kết hợp không phù hợp như “Of problem.”
Vì quá trình kiểm tra dừng ngay khi gặp token đầu tiên bị từ chối, chỉ một lỗi cũng khiến toàn bộ phần còn lại của chuỗi trở nên không hợp lệ. Bài báo về DSpark gọi đây là hiện tượng suy giảm phần đuôi (suffix decay).
DSpark giữ nguyên backbone xử lý song song của DFlash, đồng thời bổ sung hai thành phần nhẹ:
-
-
-
- Đầu ra hiệu chỉnh logit Markov thực hiện sampling token theo tuần tự và điều chỉnh logits ở mỗi vị trí dựa trên token đã được chọn trước đó. Ma trận chuyển trạng thái hạng thấp của nó khôi phục những mối quan hệ cục bộ quan trọng giữa các token mà không cần thực hiện thêm một lượt chạy transformer.
- Đầu dự đoán độ tin cậy ước tính xác suất mỗi token sẽ được chấp nhận. Bộ lập lịch có xét đến đặc điểm phần cứng sử dụng các ước tính này để kiểm tra những tiền tố dài hơn khi hệ thống còn ít tải, đồng thời cắt bỏ những phần đuôi có khả năng thấp khi hệ thống đang bận.
-
-
Nhờ vậy, DSpark vẫn giữ được ưu điểm chính của việc dự đoán song song – chỉ cần một lượt chạy backbone – đồng thời khôi phục một phần khả năng liên kết vốn có của quá trình sinh văn bản tự hồi quy.
Trên các mô hình đích thuộc dòng Qwen3, DSpark tạo ra các chuỗi được chấp nhận dài hơn 16-18% so với DFlash và 27-31% so với EAGLE-3.
Trong môi trường phục vụ thực tế của DeepSeek-V4, DSpark giúp tăng tốc độ sinh văn bản trên mỗi người dùng thêm 60-85% so với phương pháp nền tảng MTP-1 trước đây, khi so sánh ở cùng mức thông lượng.
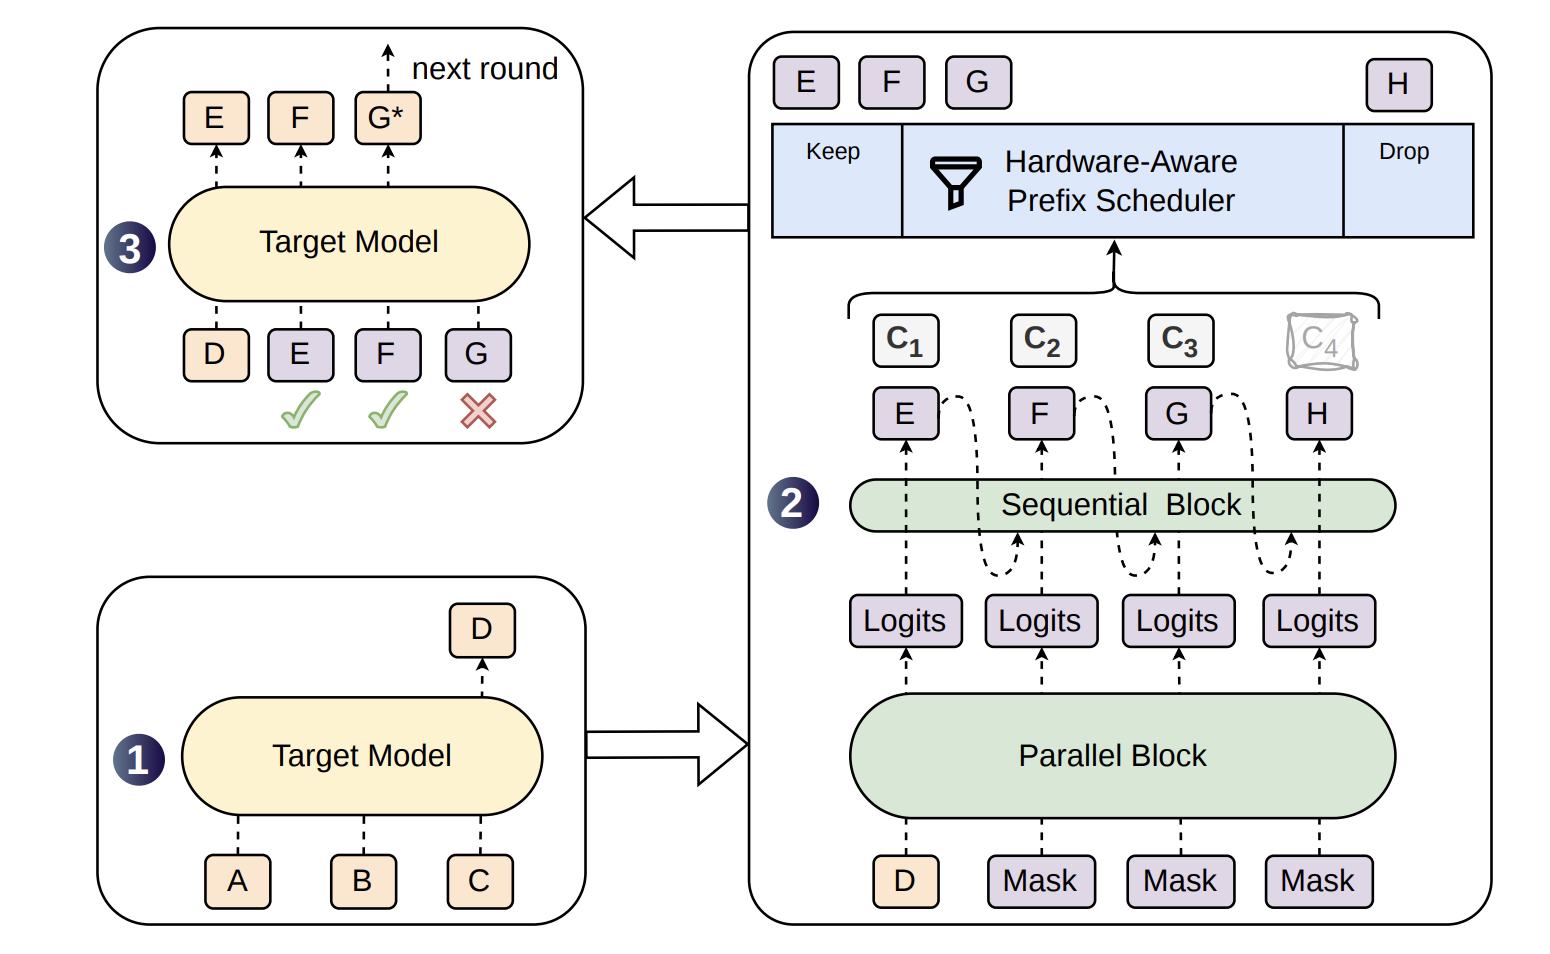
Hình 2. DSpark kết hợp một khối dự đoán song song với bước hiệu chỉnh tuần tự và cơ chế lập lịch tiền tố có xét đến phần cứng trước khi mô hình đích thực hiện kiểm tra.
Hiệu năng khi suy luận
Thiết kế bán tự hồi quy của DSpark chỉ giúp cải thiện tốc độ suy luận khi phần xử lý tuần tự bổ sung vẫn rẻ hơn đáng kể so với việc thực hiện thêm một lượt forward pass của mô hình dự đoán.
Bản mô hình dự đoán DSpark cho Kimi K3 được công bố sử dụng một mô hình dự đoán gồm 5 lớp với 5 tỷ tham số, đồng thời đề xuất 8 token ở mỗi bước giải mã.
Trên 9 nhóm tác vụ đánh giá, mô hình đạt độ dài chấp nhận trung bình 4,11 token cho mỗi lượt kiểm tra. Hiệu năng cao nhất ở các tác vụ có cấu trúc rõ ràng: 6,42 token đối với suy luận toán học, 4,96 token đối với HumanEval và 4,65 token đối với dịch máy. Mức tăng tốc đặc biệt rõ rệt khi số lượng yêu cầu còn thấp.
Mô hình này đặc biệt phù hợp với các prompt có ngữ cảnh dài. Trên một tập dữ liệu chuyên biệt đầy thách thức như LongBench-v2, DSpark cho Kimi K3 đạt tới 5,31 token đầu ra cho mỗi vòng giải mã với một prompt dài 378.000 token.
Ngay cả khi xét trên toàn bộ khối lượng công việc, 10% yêu cầu có kết quả cao nhất vẫn đạt ít nhất 3,76 token mỗi vòng, cho thấy việc thực hiện các lượt dự đoán suy đoán sâu vẫn khả thi ngay cả khi độ dài ngữ cảnh thực sự rất lớn.
Hiệu năng tiếp tục tăng hiệu quả khi số lượng yêu cầu đồng thời tăng lên. Khi mức độ đồng thời tăng từ 1 lên 16, tổng thông lượng đầu ra tăng từ 177 lên 683 token/giây.
Đáng chú ý, thời gian bắt đầu trả về phản hồi vẫn thấp ngay cả khi hệ thống chịu tải cao. Mặc dù phải xử lý số yêu cầu đồng thời nhiều gấp 16 lần, thời gian trung vị để nhận token đầu tiên chỉ tăng thêm 100 mili giây, từ 379 lên 479 mili giây.
Việc triển khai khá đơn giản. Hãy làm theo hướng dẫn chính thức của vLLM tương ứng với phần cứng và trường hợp sử dụng của bạn.
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e GLOO_SOCKET_IFNAME=$IFACE_NAME \
  -e NCCL_SOCKET_IFNAME=$IFACE_NAME \
  -e VLLM_ALLREDUCE_USE_FLASHINFER=1 \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest moonshotai/Kimi-K3 \
  --trust-remote-code \
  --gpu-memory-utilization 0.95 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr $HEAD_IP \
  --load-format fastsafetensors \
  --no-enable-flashinfer-autotune \
  --max-model-len 1048576 \
  --kv-cache-dtype fp8 \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --enable-prefix-caching \
  --attention-backend TOKENSPEED_MLA \
  --prefix-match-unit 128 \
  --reasoning-parser kimi_k3 \
  --language-model-only \
  --speculative-config '{"model":"RedHatAI/Kimi-K3-speculator.dspark", "num_speculative_tokens":8, "method":"dspark", "draft_sample_method":"probabilistic", "rejection_sample_method":"block"}'
Cấu hình phần cứng
Mô hình này được huấn luyện trên một rack GB300, giữ nguyên thiết kế tham chiếu của NVIDIA và chạy bare metal, không sử dụng ảo hóa. Hệ thống chạy Ubuntu 24.04.4 LTS trên kernel 6.14 với kích thước trang 64K của NVIDIA.
Hệ thống sử dụng trình điều khiển GPU mã nguồn mở 610.57.04 của NVIDIA (R610). CUDA 13.4.0 Developer Preview được cài đặt cùng với CUDA 13.1 và 12.9, trong khi NCCL 2.31.2 được cung cấp trên toàn hệ thống.
CUDA 13.4.0 được lựa chọn nhờ các tính năng lập trình mới dành cho Blackwell, đồng thời đây là bộ công cụ đầu tiên hỗ trợ Rubin (sm_107).
Điều này giúp bảo đảm rằng mã nguồn được viết và đo hiệu năng trên GB300 hiện nay có thể được xây dựng cho thế hệ phần cứng tiếp theo mà không gặp những vấn đề tương thích ngoài dự kiến.
Hệ thống cũng cho phép lập hồ sơ GPU dựa trên bộ đếm phần cứng mà không cần quyền root. Nhờ đó, mọi nhà nghiên cứu đều có thể lập hồ sơ cả khối lượng công việc huấn luyện lẫn suy luận.
Trích xuất trạng thái ẩn ở quy mô lớn
Một trong những yếu tố khiến các mô hình dự đoán dành cho giải mã suy đoán trở nên mạnh mẽ dù có kích thước nhỏ là chúng thường nhận trạng thái ẩn từ mô hình đích làm đầu vào để hỗ trợ việc dự đoán.
Điều này cải thiện đáng kể thông tin mà mô hình dự đoán có thể sử dụng và giúp các mô hình này đưa ra dự đoán gần sát với mô hình đích hơn.
Điểm hạn chế là việc huấn luyện các mô hình dự đoán này đòi hỏi một tập dữ liệu gồm trạng thái ẩn làm đầu vào và log-probability đầu ra của mô hình đích.
May mắn là vLLM có sẵn một hệ thống trích xuất trạng thái ẩn, cho phép lấy các trạng thái ẩn bên trong của mô hình đích theo yêu cầu đối với từng mẫu dữ liệu.
Hệ thống này sử dụng một mô hình dự đoán giả. Mô hình này tận dụng lại cơ chế kết nối dành cho mô hình dự đoán của vLLM để nhận trạng thái ẩn từ mô hình đích, sau đó đưa chúng vào KV cache của một lớp attention giả.
Từ đó, một lớp triển khai giao diện KVConnector có thể lấy các trạng thái ẩn ra khỏi vLLM và chuyển chúng sang nơi khác.
Hiện tại, vLLM cung cấp sẵn ExampleHiddenStatesConnector, thực hiện chính xác công việc này bằng cách ghi trạng thái ẩn xuống ổ đĩa một cách bất đồng bộ.
Hệ thống này hoạt động tốt khi vLLM và quá trình huấn luyện cùng nằm trên một máy.
Ví dụ, một nửa số GPU của máy có thể được dành cho huấn luyện, trong khi nửa còn lại chạy mô hình đích bằng vLLM và trích xuất trạng thái ẩn theo yêu cầu.
Cơ chế này đã được Speculators và vLLM hỗ trợ tốt trong nhiều tháng. Tuy nhiên, với một mô hình có 2,8 nghìn tỷ tham số như Kimi K3, ngay cả những bộ tăng tốc tiên tiến nhất cũng bắt đầu gặp giới hạn về VRAM, dù trọng số mô hình đã được lượng tử hóa 4-bit.
Do đó, chúng ta cần một hệ thống có thể mở rộng vượt ra ngoài phạm vi huấn luyện trên một máy duy nhất, đồng thời cho phép tách rời quá trình huấn luyện và quá trình trích xuất trạng thái ẩn.
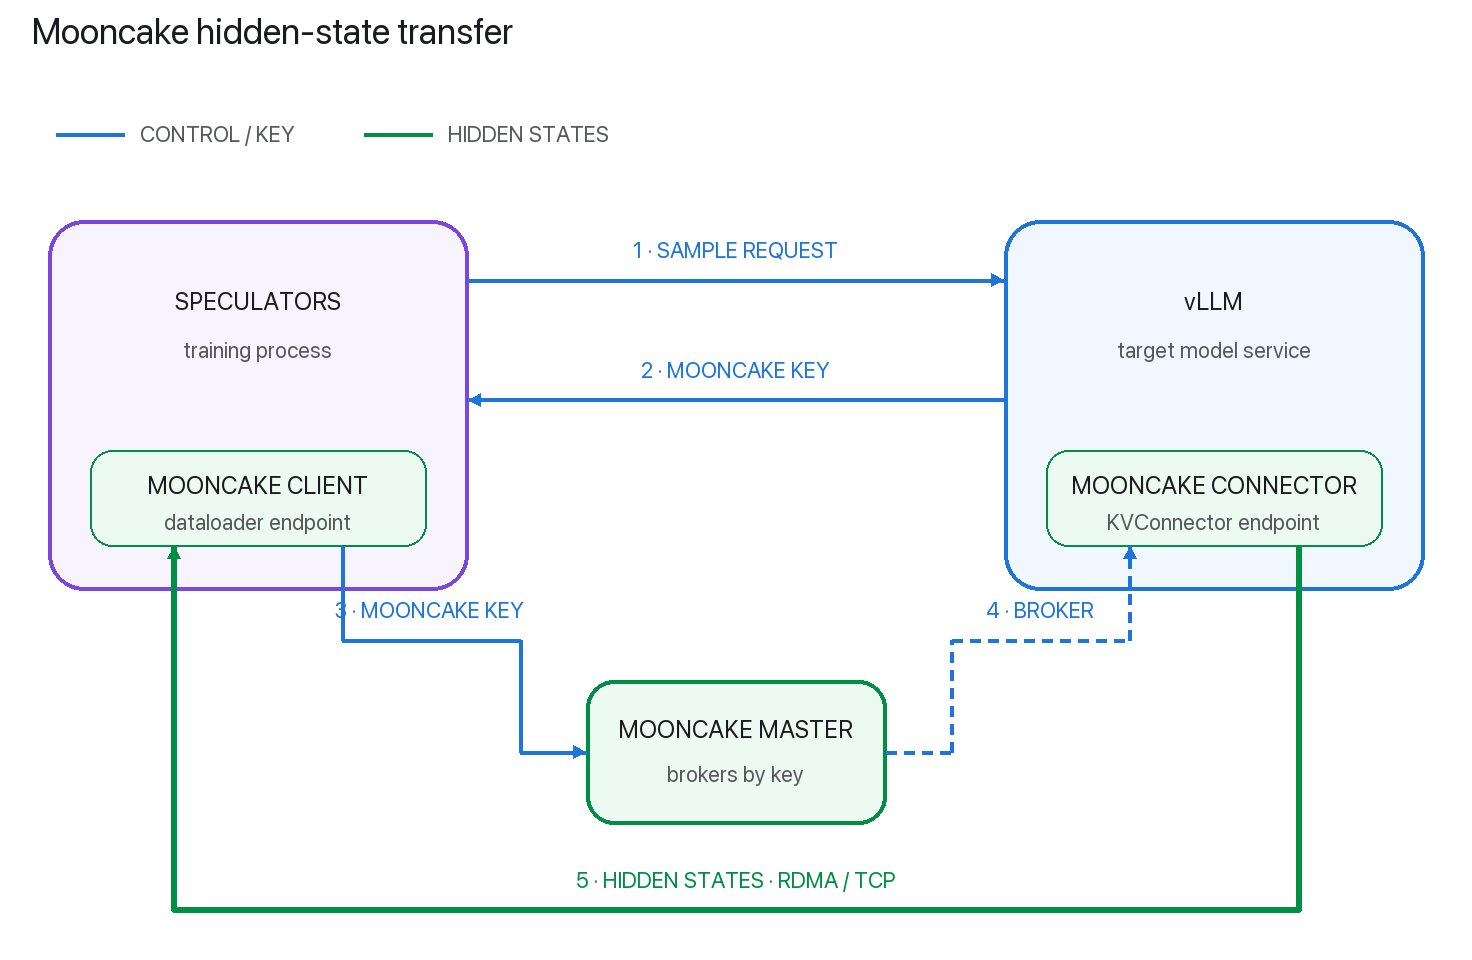
Hình 3. Bộ kết nối Mooncake tách đường điều khiển khỏi đường truyền dữ liệu trạng thái ẩn, sử dụng RDMA hoặc TCP để truyền dữ liệu giữa vLLM và bộ nạp dữ liệu của Speculators.
Với những yêu cầu trên, đội ngũ đã xây dựng MooncakeHiddenStatesConnector, sử dụng công cụ truyền dữ liệu Mooncake làm nền tảng để truyền trạng thái ẩn liên tục giữa các tiến trình và giữa nhiều máy.
Hệ thống mới sử dụng một tiến trình trung gian Mooncake chính để quản lý việc liên lạc với vLLM và các tiến trình huấn luyện. Các tiến trình huấn luyện tự đăng ký với tiến trình này dưới vai trò máy khách (clients).
Sau khi thiết lập xong, các tiến trình huấn luyện có thể gửi yêu cầu đến giao diện phía trước của vLLM và nhận lại một khóa dữ liệu Mooncake.
Khóa này sau đó được chuyển cho tiến trình Mooncake chính. Tiến trình này chịu trách nhiệm điều phối việc truyền dữ liệu từ bộ máy vLLM sang bộ nạp dữ liệu của Speculators.
Toàn bộ quá trình diễn ra tự động và được máy chủ Mooncake quản lý. Tùy theo cấu hình, hệ thống có thể sử dụng RDMA tốc độ cao hoặc TCP thông thường để truyền dữ liệu giữa các tiến trình trên cùng một máy hoặc giữa những máy khác nhau.
Huấn luyện DSpark cho Kimi K3
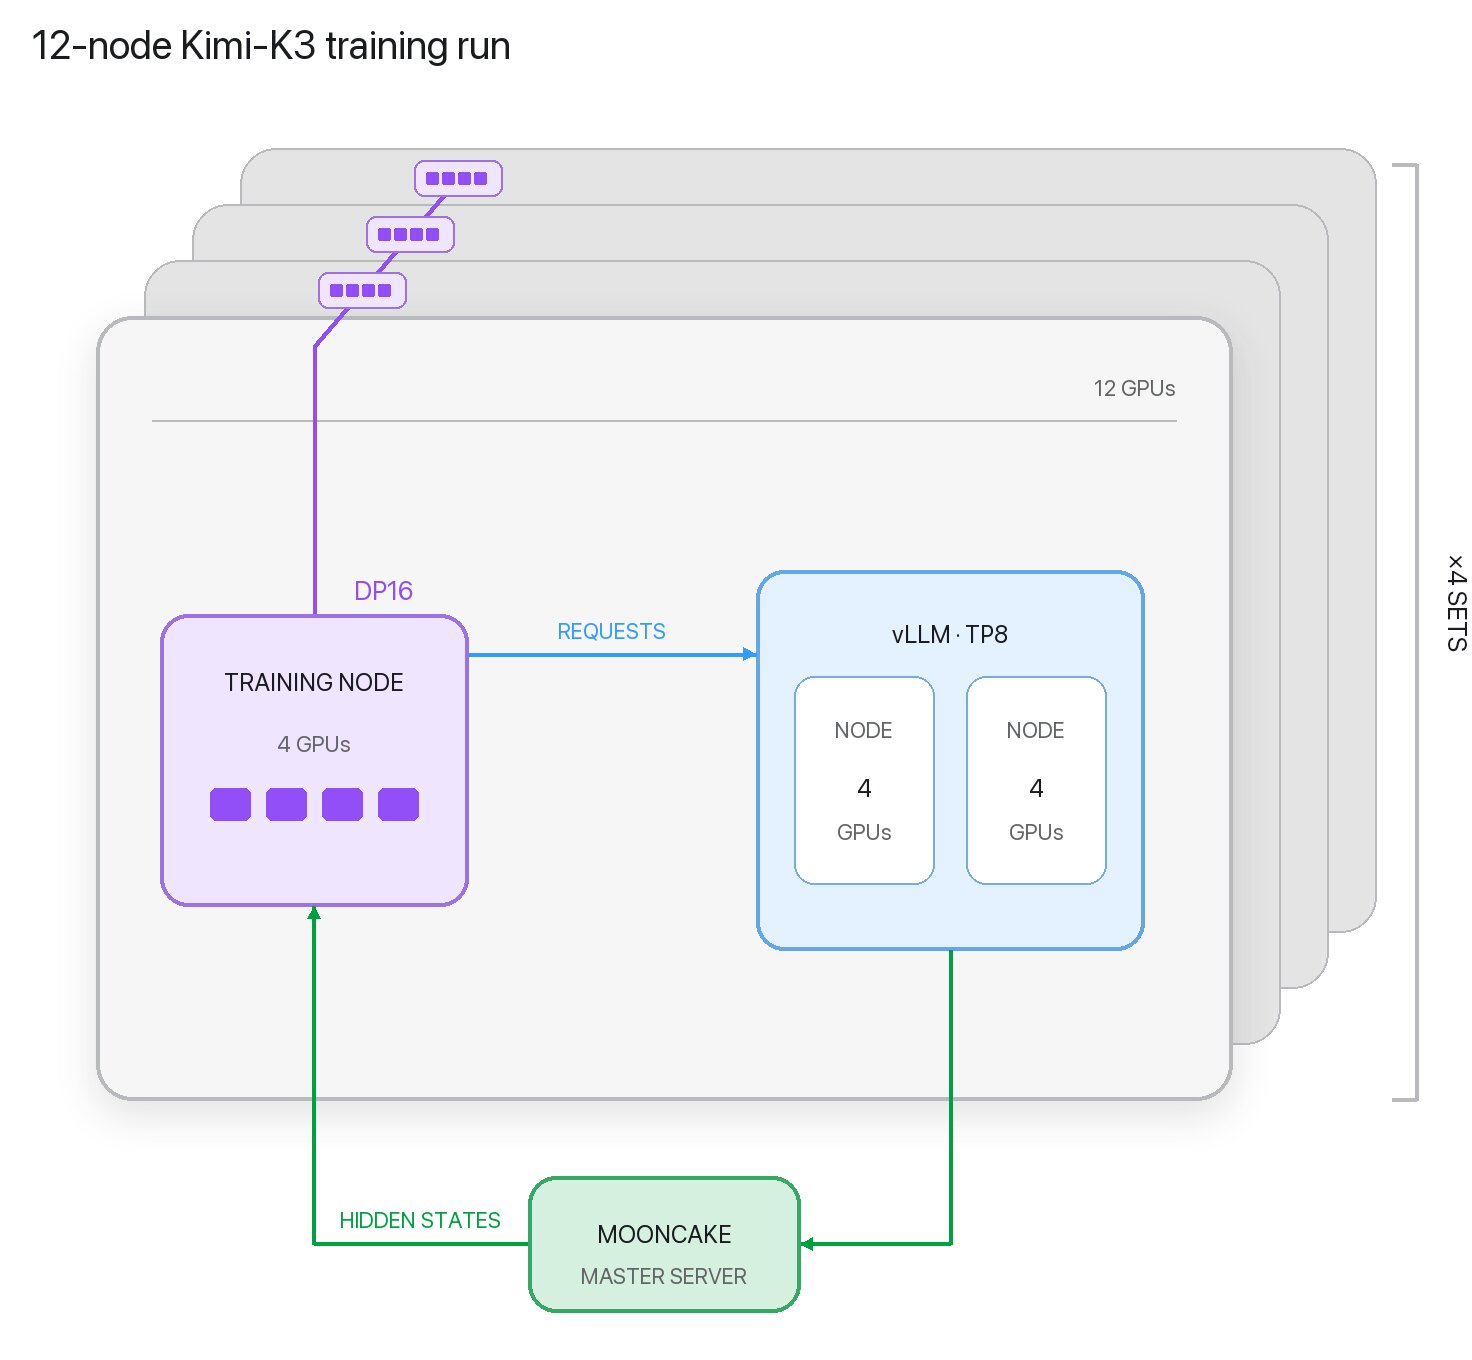
Hình 4. Mỗi cụm ba máy gồm một máy có 4 GPU dành cho huấn luyện và hai máy có 4 GPU dành cho suy luận vLLM; Mooncake đảm nhiệm việc truyền trạng thái ẩn.
Với MooncakeHiddenStatesConnector mới, chúng ta đã có một hệ thống có thể mở rộng quy mô huấn luyện các mô hình lớn trên nhiều máy.
Ngay cả khi Kimi K3 được lượng tử hóa 4 bit, mô hình vẫn cần ít nhất hai máy GB300, mỗi máy có bốn GPU, để phục vụ mô hình.
Nhiều thử nghiệm đã được thực hiện về cách phân bổ tài nguyên khác nhau giữa huấn luyện và vLLM, và nhận thấy rằng mỗi cụm ba máy – hai máy dành cho suy luận và một máy dành cho huấn luyện – mang lại thông lượng tốt nhất.
Một ưu điểm khác của Speculators khi kết hợp với bộ kết nối Mooncake là khả năng tăng hoặc giảm quy mô riêng từng thành phần một cách dễ dàng, từ đó tối ưu hiệu năng theo nhu cầu.
Kết luận
Speculators là một thư viện mã nguồn mở dùng để xây dựng, huấn luyện, đánh giá và chia sẻ các mô hình giải mã suy đoán, có thể tích hợp trực tiếp với các bộ máy suy luận như vLLM.
Cho dù bạn đang huấn luyện một mô hình dự đoán mới, nghiên cứu các thuật toán như DFlash, DSpark hoặc DFlash2, hay cải thiện hiệu năng suy luận trong môi trường thực tế, các ý tưởng và đóng góp từ cộng đồng sẽ luôn được hoan nghênh.
Hãy tham gia vLLM Community Slack và tìm đến tại các kênh #speculators và #feat-spec-decode để đặt câu hỏi, chia sẻ kết quả, thảo luận về các thuật toán mới và cùng hợp tác với cộng đồng.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.