Tối ưu hiệu năng Kimi K3 trong vLLM: Hành trình đạt thông lượng gấp 2,8 lần
Hỗ trợ Kimi K3 ngay từ ngày đầu đã giúp mô hình này có thể chạy trên vLLM. Tuy nhiên, để phục vụ mô hình một cách hiệu quả, cần tiếp tục tối ưu trên toàn bộ hệ thống. Trạng thái hồi quy KDA, LatentMoE, các hạt nhân chuyên gia MXFP4, giải mã suy đoán và TP/PP đều làm lộ ra những điểm nghẽn khác nhau; ngay cả các giới hạn của bộ lập lịch và những lần sao chép tensor nhỏ cũng có thể ảnh hưởng đến hiệu năng không kém một phép GEMM lớn.
Bài viết này bắt đầu bằng kết quả tổng thể từ đầu đến cuối, sau đó đi sâu vào bốn thay đổi tiêu biểu: ngân sách token dự đoán thích ứng, các điểm kiểm tra tiền tố KDA nội bộ, các lô KDA kết hợp không sao chép dữ liệu và trì hoãn bước hoàn tất MXFP4. Bài viết cũng đề cập đến ReplaySSM, việc tách rời nạp đầu vào và giải mã cùng chuyển bộ nhớ đệm sang nơi khác, cũng như xử lý song song theo ngữ cảnh khi giải mã. Toàn bộ nỗ lực được theo dõi tại Kimi K3 Performance Optimization #50587.
Hiệu năng
Đo trên khối lượng công việc gồm 8K token đầu vào và 1K token đầu ra, sử dụng TP8 và dự đoán DSpark với tám token. Mức đồng thời là 1, 4 và 16. So sánh từ v0.27.1 đến commit 82a85dc1 (0913), được kiểm thử trên một máy B300 với CUDA 13.3.
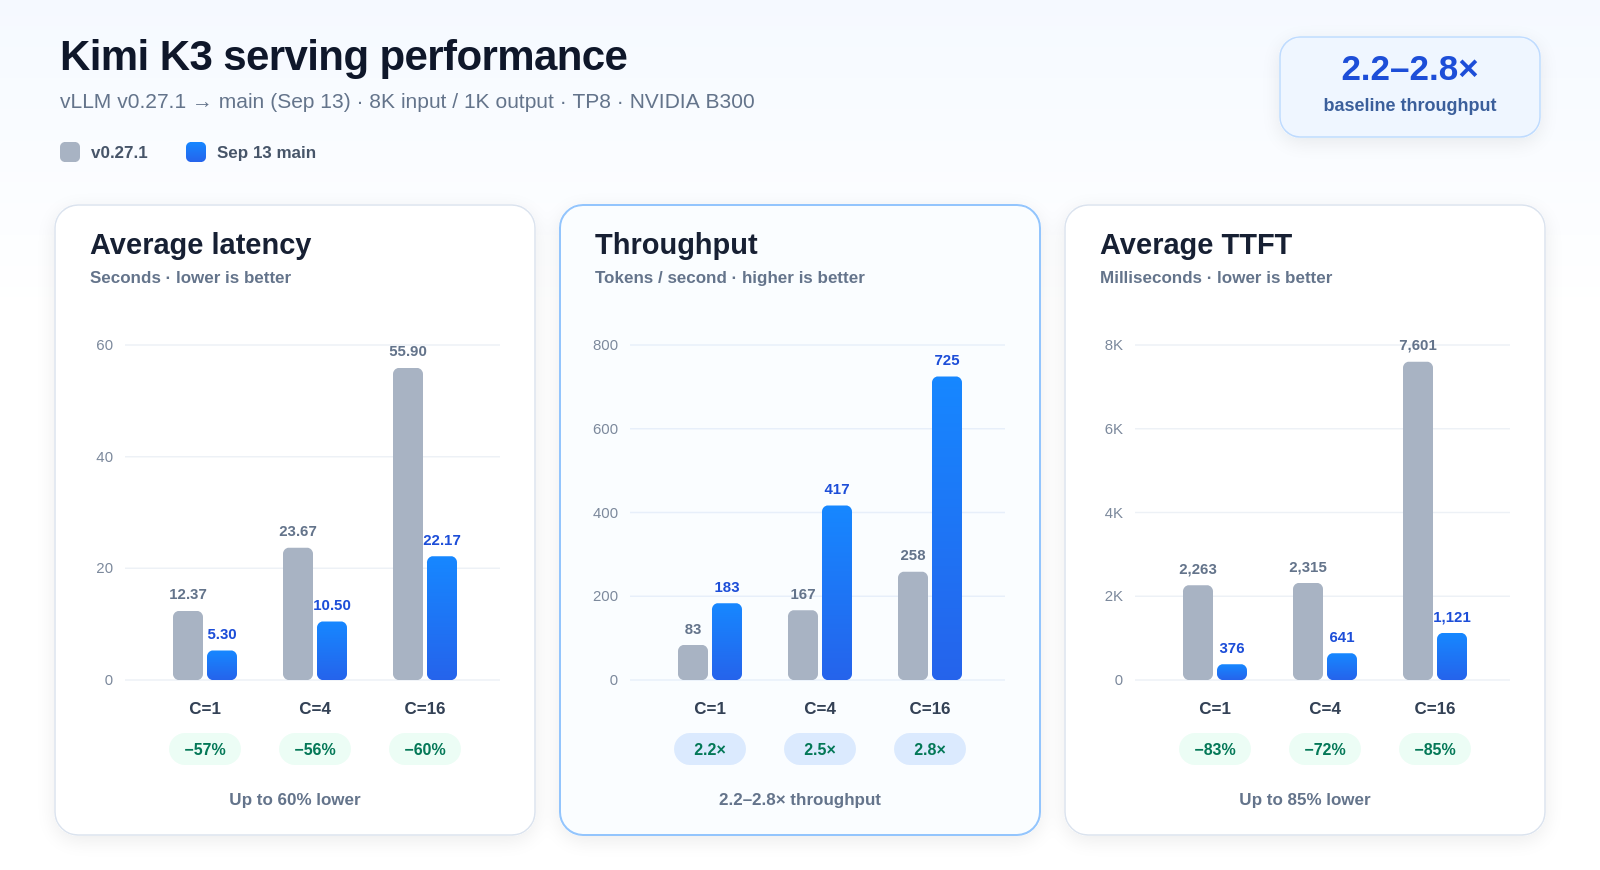
Hiệu năng phục vụ Kimi K3 từ vLLM v0.27.1 đến nhánh chính: độ trễ giảm 56%–60%, thông lượng tăng 2,2–2,8 lần và TTFT giảm 72%–85% ở các mức đồng thời 1, 4 và 16.
Khởi động máy chủ:
vllm serve moonshotai/Kimi-K3 \
  --trust-remote-code \
  --tensor-parallel-size 8 \
  --load-format fastsafetensors \
  --gpu-memory-utilization 0.9 \
  --reasoning-parser kimi_k3 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000 \
  --max-model-len auto \
  --no-enable-prefix-caching \
  --speculative-config '{"model":"RedHatAI/Kimi-K3-speculator.dspark","method":"dspark","num_speculative_tokens":8,"draft_sample_method":"probabilistic","rejection_sample_method":"standard"}'
Lưu ý: Bộ nhớ đệm tiền tố được tắt trong cả hai lần chạy vì v0.27.1 có một lỗi đã biết liên quan đến bộ nhớ đệm tiền tố của Kimi K3, và lỗi này được sửa ở các phiên bản sau.
Chạy phép đo hiệu năng:
guidellm run \
  --backend '{"kind":"openai_http","target":"http://127.0.0.1:30000","model":"moonshotai/Kimi-K3","request_format":"/v1/chat/completions","timeout":100000,"extras":{"body":{"reasoning_effort":"max","temperature":1.0,"top_p":0.95}}}' \
  --tokenizer '{"kind":"huggingface_auto","model":"moonshotai/Kimi-K3","load_kwargs":{"trust_remote_code":true}}' \
  --data 'kind=synthetic_text,prompt_tokens=8000,output_tokens=1000' \
  --profile 'kind=concurrent,warmup=0.1,cooldown=0.1' \
  --override profile.streams '1,4,16' \
  --constraint 'kind=max_duration,seconds=150' \
  --constraint 'kind=max_errors,count=10' \
  --seed 'kind=static,value=42' \
  --metrics 'kind=generative,sample_size=20' \
  --output 'kind=json,path=guidellm-results/output_vllm_kimik3_8k1k.json'
| Mức đồng thời | Độ trễ TB 0.27.1 (giây) | Độ trễ TB nhánh chính 0913 (giây) | Thông lượng 0.27.1 (token/giây) | Thông lượng nhánh chính 0913 (token/giây) | TTFT TB 0.27.1 (ms) | TTFT TB nhánh chính 0913 (ms) |
| 1 | 12.37 | 5.30 (−57.2%) | 83.3 | 183.3 (+120.0%) | 2262.9 | 376.3 (−83.4%) |
| 4 | 23.67 | 10.50 (−55.6%) | 166.7 | 416.7 (+150.0%) | 2314.9 | 640.5 (−72.3%) |
| 16 | 55.90 | 22.17 (−60.3%) | 258.3 | 725.0 (+180.6%) | 7601.1 | 1121.0 (−85.3%) |
Một số ví dụ về tối ưu từ đầu đến cuối
Ngân sách lập lịch thích ứng
Khi số lượng yêu cầu ít, phần lớn max_num_batched_tokens không được sử dụng. PR #51725 đưa vào cơ chế phân bổ ngân sách token được lập lịch một cách thích ứng. PR #51726 tăng giới hạn mặc định từ 8.192 lên 16.384 đối với nhóm GPU có dung lượng bộ nhớ lớn. Trên khối lượng công việc 8K/1K được báo cáo, TTFT giảm 55%–65% và thông lượng tăng tới 41,5%.
Xét max_num_seqs=1024, max_num_batched_tokens=8192 và K=8:
| Số yêu cầu thực tế | Số token được lập lịch theo cách cũ | Hiện tại |
| 1 | 1024 (8192 – 1024 × (8-1)) | 8185 (8192 – 7) |
| 32 | 1024 | 7968 |
| 128 | 1024 | 7296 |
| 1024 | 1024 | 1024 |
PR này sử dụng chiến lược thích ứng để tăng đáng kể số token được lập lịch khi số lượng yêu cầu ít. Nhờ đó, một yêu cầu không còn bị chia thành nhiều lượt lan truyền thuận.
Các điểm kiểm tra tiền tố KDA nội bộ
Bộ nhớ đệm tiền tố theo kiểu Mamba trước đây chia lượt nạp đầu vào tại ranh giới cuối cùng của khối có thể lưu vào bộ nhớ đệm, đôi khi khiến hệ thống phải thực hiện thêm một lượt chạy toàn bộ mô hình cho phần đuôi ngắn còn lại. PR #52789 cho phép xuất điểm kiểm tra ngay trong một lượt nạp đầu vào, giúp TTFT giảm 9%–25%. PR #53614 bổ sung khả năng tái sử dụng một phần tiền tố và giải mã suy đoán, trong đó có việc căn chỉnh ranh giới phát lại của EAGLE.
Với đầu vào 8K token:
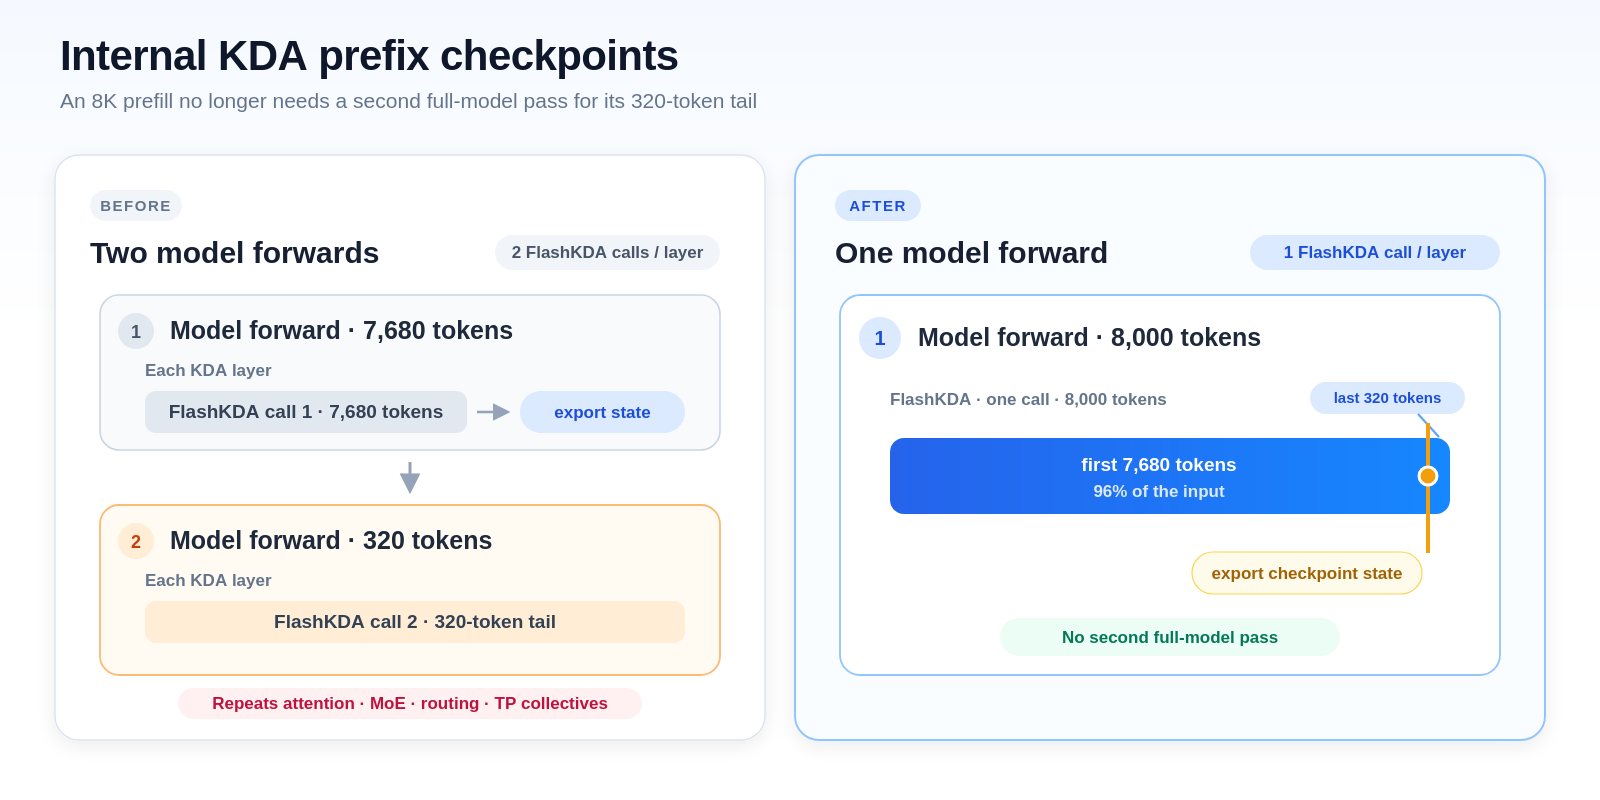
Trước khi có các điểm kiểm tra KDA nội bộ, một lượt nạp đầu vào 8K phải thực hiện hai lượt lan truyền thuận qua mô hình và hai lần gọi FlashKDA cho mỗi lớp KDA; sau thay đổi, một lần gọi FlashKDA xử lý toàn bộ 8.000 token và xuất trạng thái điểm kiểm tra tại token thứ 7.680 ngay trong cùng lượt hồi quy.
PR này giúp tránh phải chạy lại toàn bộ mô hình lần thứ hai qua cơ chế chú ý, MoE, bộ định tuyến và các phép tập hợp TP.
Các lô KDA kết hợp không sao chép dữ liệu
Các lô kết hợp giữa suy đoán và không suy đoán trước đây phải thực hiện sáu phép index_select và hai phép index_copy_ cho mỗi lớp. PR #56159 thay thế bằng các lát cắt liên tục không sao chép dữ liệu và ghi trực tiếp vào đầu ra. Thông lượng tăng 5,2%–7,7% ở mức đồng thời 4 và 16; với mức đồng thời 1, hiệu năng hầu như không đổi.
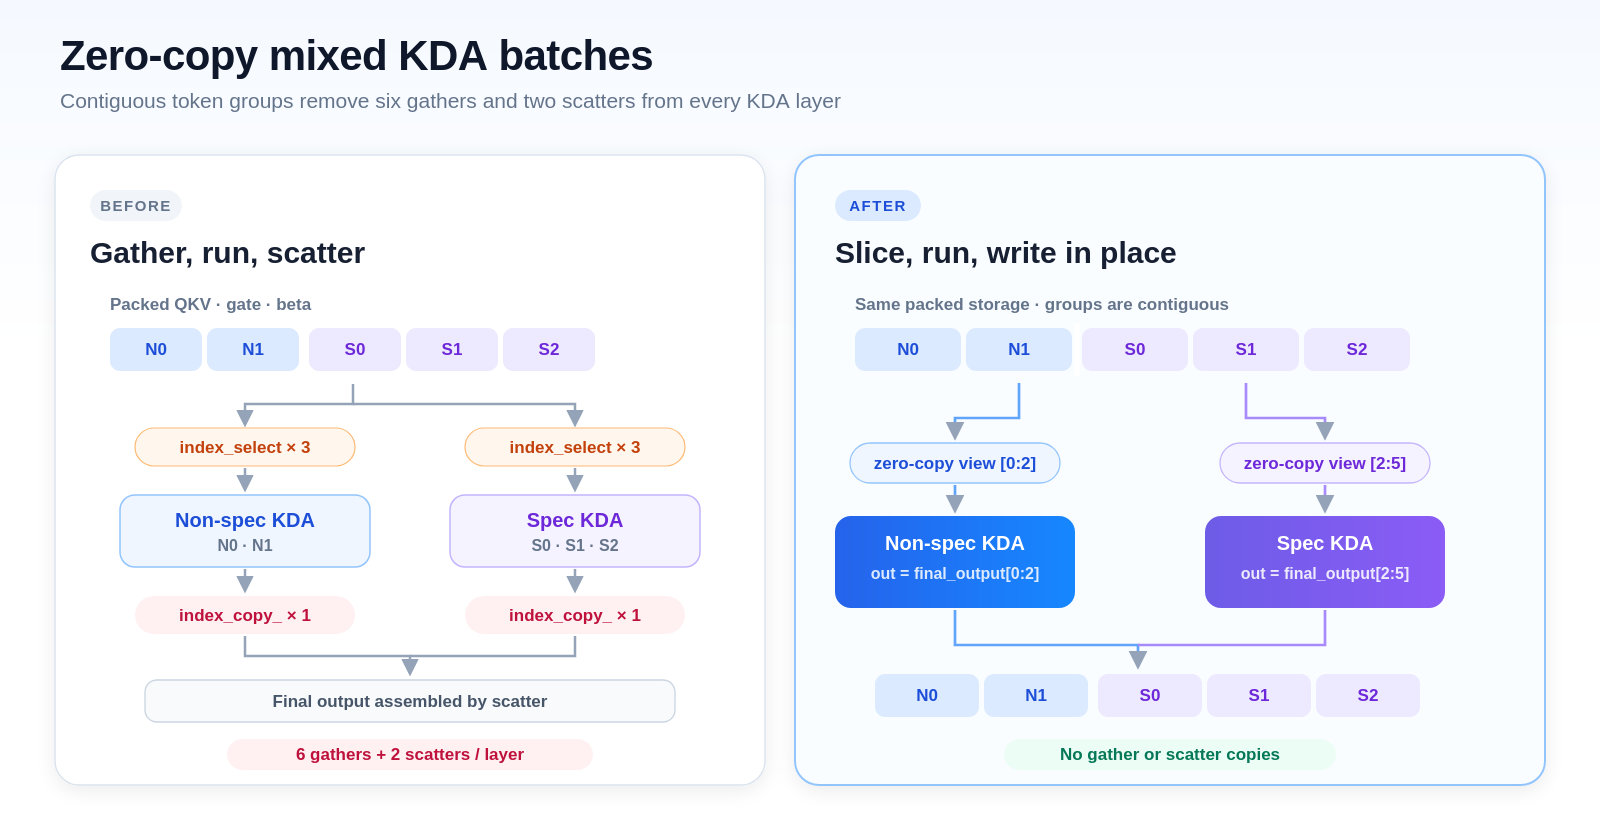
Trước khi có đường xử lý lô kết hợp không sao chép dữ liệu, mỗi lớp KDA gom các đầu vào không suy đoán và suy đoán bằng sáu lần gọi index_select, sau đó phân tán kết quả bằng hai lần gọi index_copy_; sau thay đổi, các khung nhìn liên tục được đưa trực tiếp vào cả hai đường xử lý KDA và ghi thẳng vào các lát cắt của đầu ra cuối cùng.
Trì hoãn bước hoàn tất MXFP4
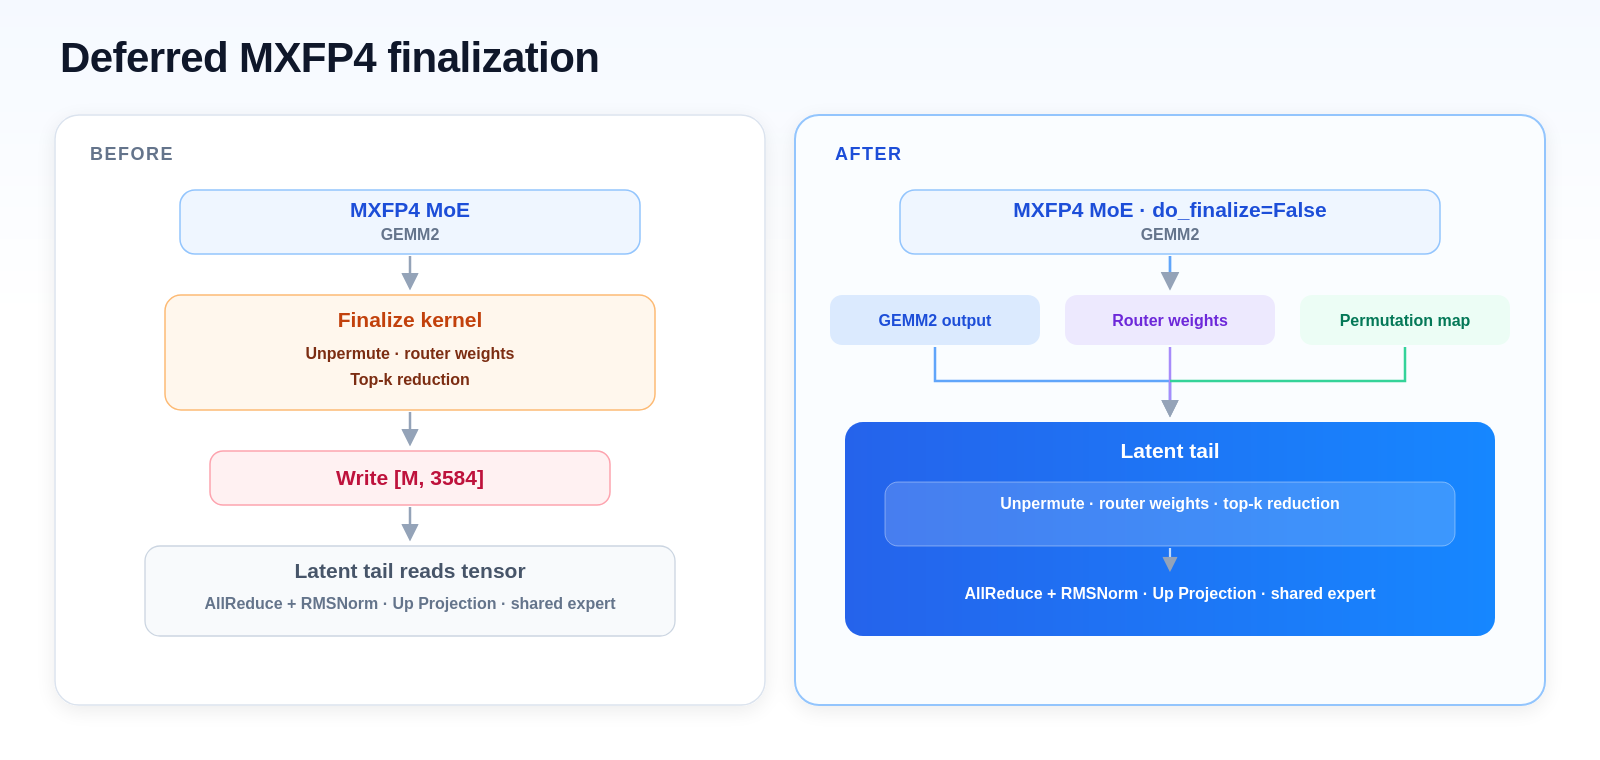
Bước hoàn tất top-k của MXFP4 trước và sau khi hợp nhất vào phần đuôi tiềm ẩn
Thay đổi này loại bỏ một lần khởi chạy hạt nhân và tránh phải ghi rồi đọc lại tensor trung gian đã hoàn tất.
ReplaySSM: tái tạo trạng thái KDA thay vì lưu trữ
Giải mã suy đoán ghi trạng thái hồi quy KDA tại mỗi vị trí dự đoán để có thể quay lại khi token bị từ chối. Với T vị trí dự đoán, mỗi bước sẽ phát sinh T lần ghi trạng thái bổ sung. ReplaySSM thay vào đó lưu tạm các đầu vào SSM gần nhất rồi tái tạo trạng thái đã được chấp nhận tại thời điểm xác nhận. Khi quay lại, hệ thống chỉ cần di chuyển con trỏ của vùng đệm.
PR #51855 đưa ReplaySSM vào Kimi K3 trên Model Runner V2. Một hạt nhân Triton xác nhận trạng thái đã được chấp nhận và ranh giới tiền tố tiếp theo của bộ nhớ đệm trong chế độ align. Với cùng ngân sách bộ nhớ đệm 46,48 GiB, dung lượng sử dụng thực tế tăng 10,97% trên TP8 mà không làm giảm độ chính xác.
Tách rời nạp đầu vào và giải mã, cùng chuyển trạng thái kết hợp sang nơi khác
Việc tách rời nạp đầu vào và giải mã, cũng như chuyển bộ nhớ đệm sang nơi khác, phải truyền cả KV của MLA và trạng thái KDA. KV của MLA được sao chép trên mọi hạng TP, còn trạng thái KDA được chia nhỏ theo đầu và chiều. Các bảng khối align của Mamba cũng có thể thưa và thay đổi trong quá trình chạy. Vì vậy, không thể áp dụng các giả định về truyền dữ liệu vốn chỉ phù hợp với mô hình dùng cơ chế chú ý.
PR #51358: Mooncake lưu các trạng thái tại ranh giới do bộ lập lịch chọn và giữ cố định chúng cho đến khi việc ghi không đồng bộ hoàn tất trên mọi hạng. PR #50344: chỉ những bộ kết nối có khả năng khôi phục trạng thái KDA mới được phép phục vụ các trường hợp tái sử dụng tiền tố khác nhau giữa từng nhóm.
Xử lý song song theo ngữ cảnh khi giải mã
TP sao chép KV tiềm ẩn của MLA trên mọi hạng, vì vậy việc tăng số hạng TP không làm tăng dung lượng bộ nhớ đệm KV. Xử lý song song theo ngữ cảnh khi giải mã chia KV theo chiều dài chuỗi, phù hợp với các khối lượng công việc tác nhân có tiền tố dùng chung rất dài.
PR #50484 bổ sung DCP cho đường xử lý MLA hợp nhất của Kimi K3. Bộ nhớ đối xứng A2A xử lý việc tập hợp đầu ra và LSE; multicast NVLS tập hợp các truy vấn; multimem tập hợp KV của các đoạn ngữ cảnh. Các phần truy vấn được chia nhỏ được ghi trực tiếp vào vùng đệm cuối cùng của bên sử dụng. Độ trễ trao đổi truy vấn giảm 10,4%–29,9% trên cấu hình 4×GB200.
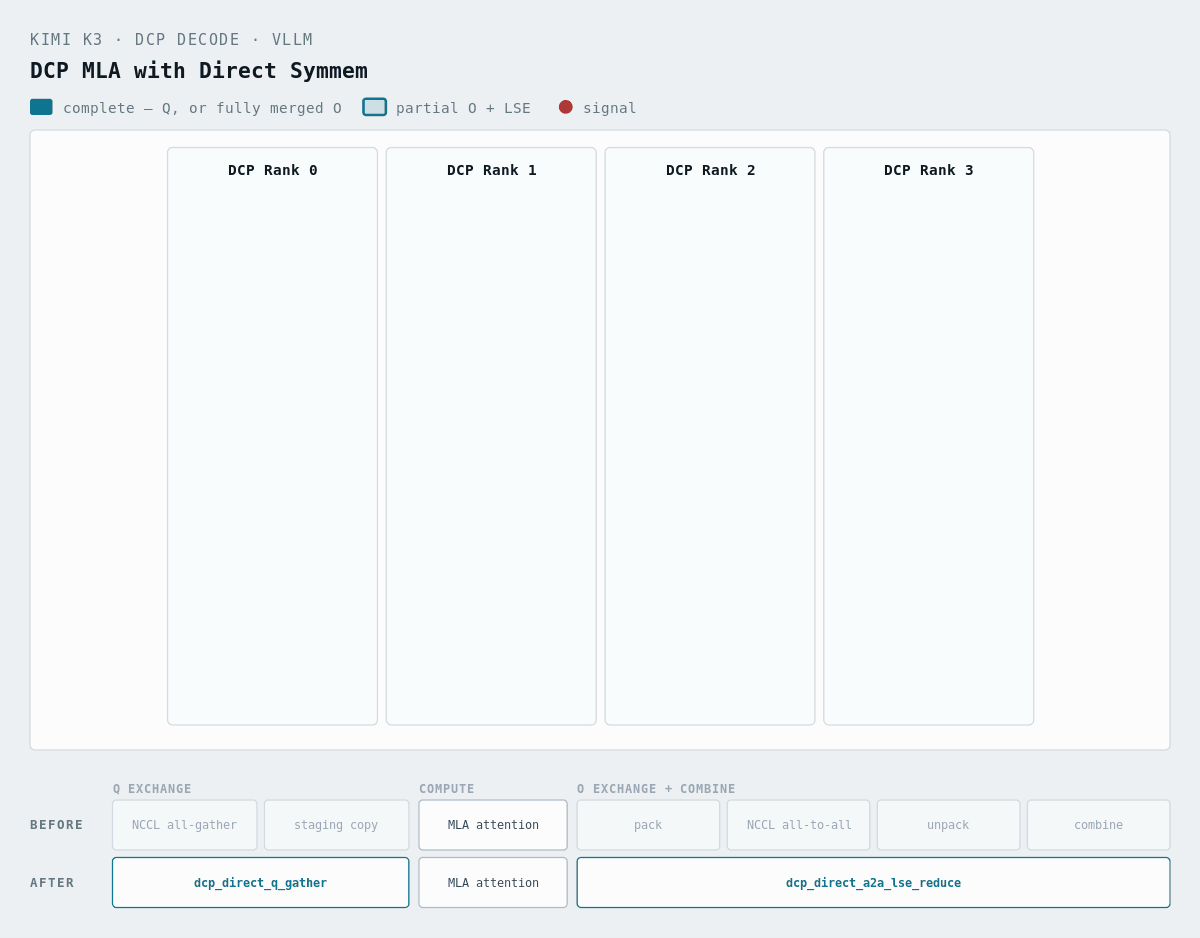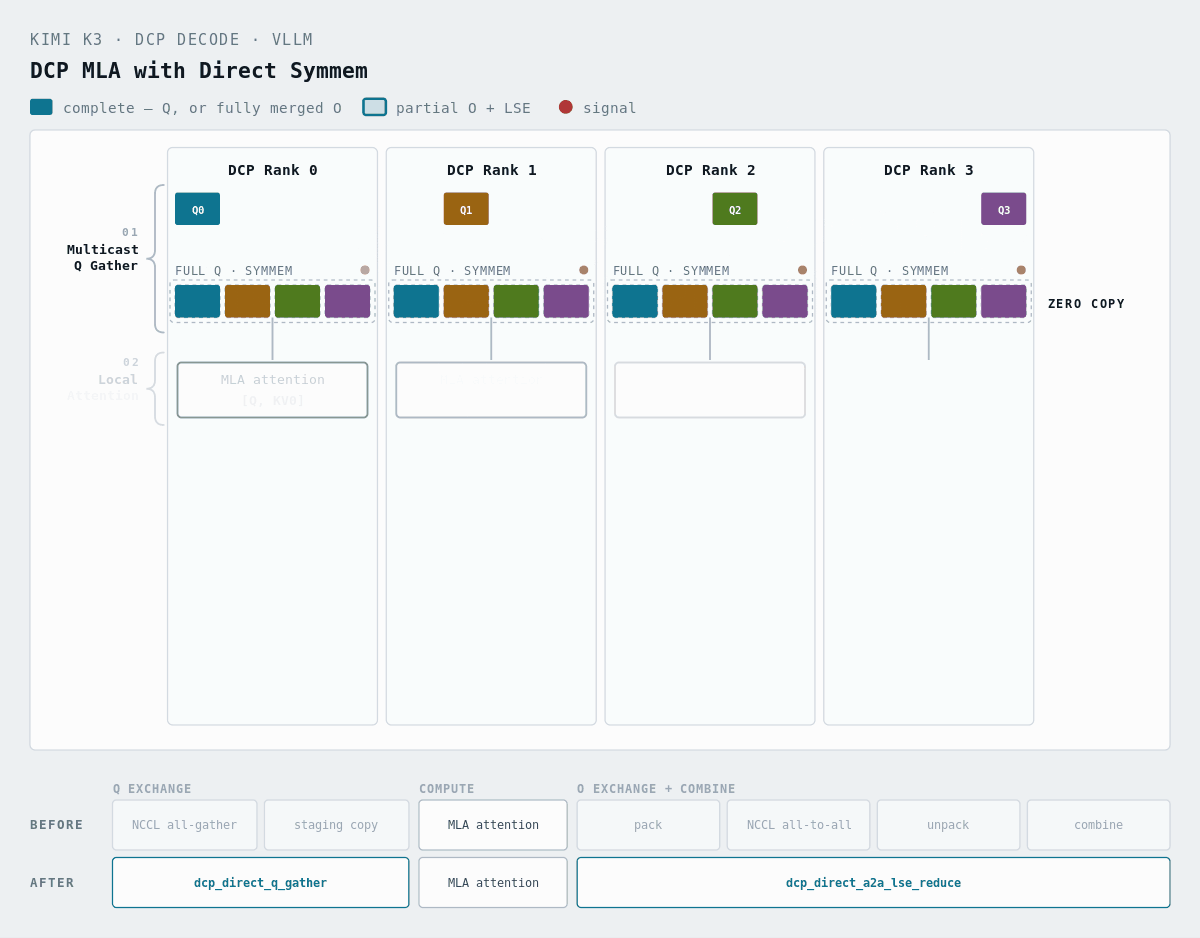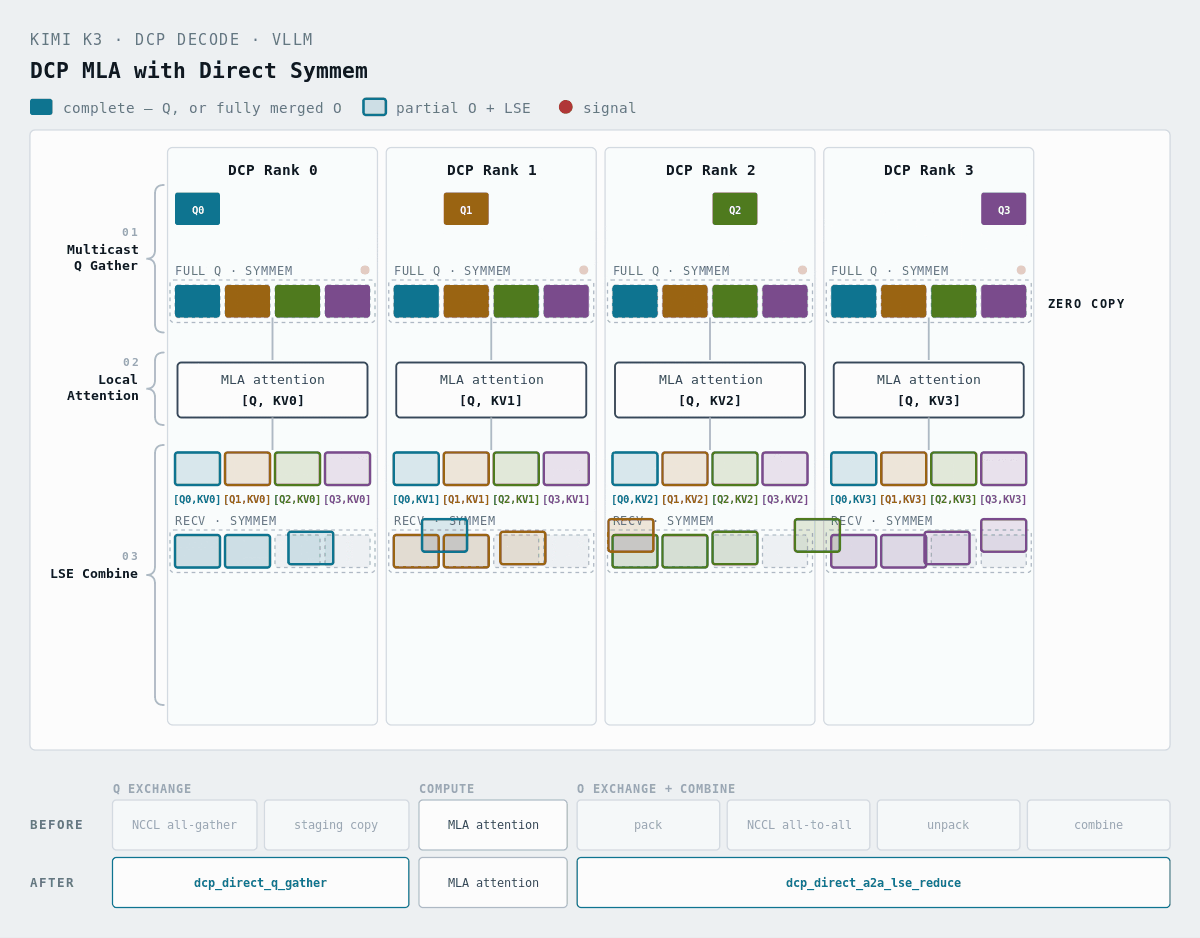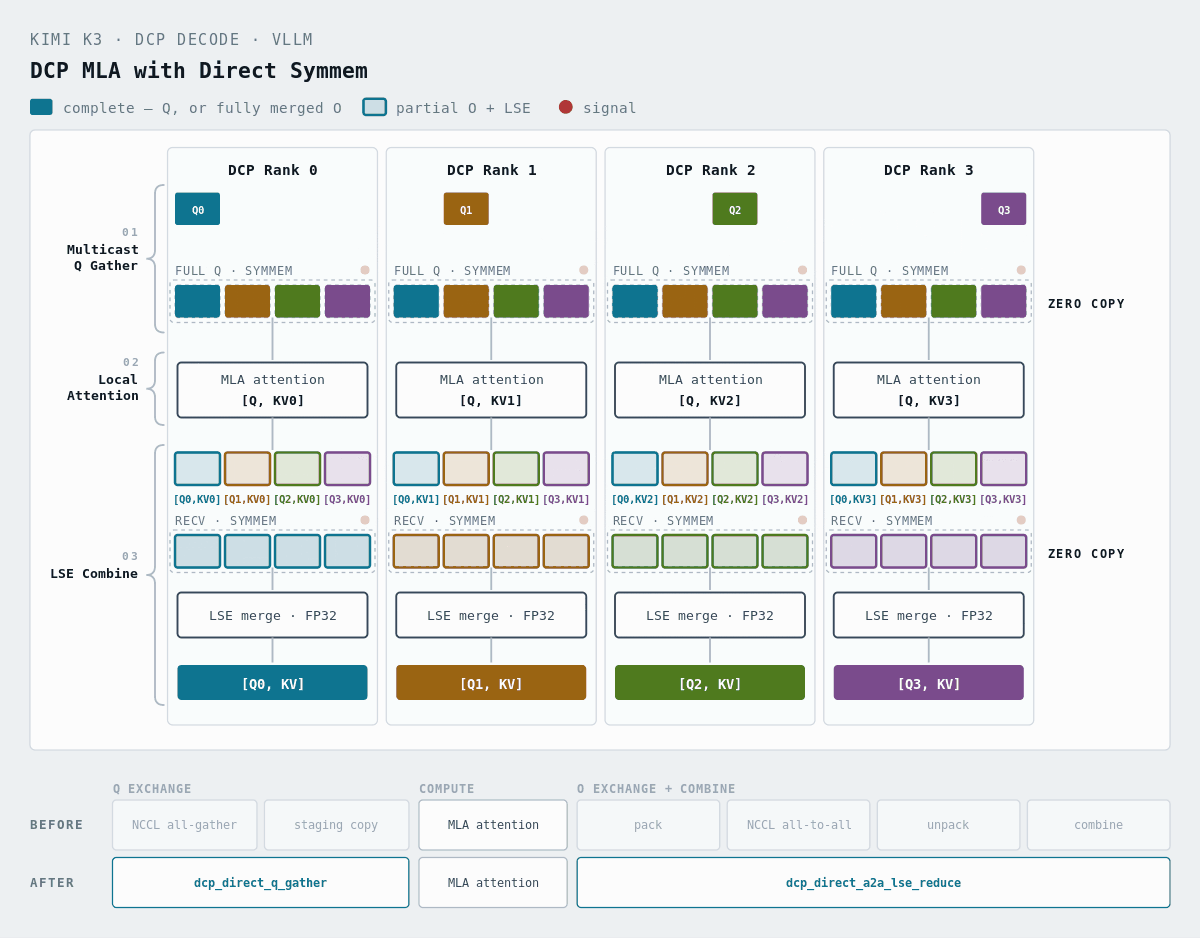
Trên khối lượng công việc 120K token, gồm 114K token tiền tố dùng chung, 6K token phần đuôi và 400 token đầu ra, dung lượng bộ nhớ đệm KV tăng từ 1,93 triệu lên 19,75 triệu token. TPOT p50 giảm từ 13,8 ms xuống 10,5 ms ở mức đồng thời 1, và từ 16,2 ms xuống 11,8 ms ở mức đồng thời 2. Trên GSM8K, độ chính xác đạt 96,97% với DCP8 so với 96,21% với TP8; không có yêu cầu nào bị lỗi.
Những tối ưu khác ngoài các ví dụ trên
Nỗ lực tối ưu rộng hơn bao phủ cách bố trí bộ nhớ, xử lý song song theo chuỗi và theo đường ống, quá trình nạp đầu vào KDA và trạng thái hồi quy, MLA, MoE và GEMM. Nhóm phát triển chia nhỏ các phép chiếu lớn và các chuyên gia dùng chung, giảm số phép tập hợp và lượng dữ liệu phải di chuyển, đồng thời tinh chỉnh các đường xử lý GPU dành cho lô nhỏ. Danh sách đầy đủ các PR được theo dõi tại issue #50587.
Một số PR từ cộng đồng đã mở rộng thêm phạm vi công việc. Robert Shaw và Summer Yang bổ sung DeepEPv2 với DeepGEMM MXFP4 và hỗ trợ DCP được mô tả ở trên, trong khi Thien Tran phát triển các đường xử lý GEMM song song theo chuỗi. Nick Hill và Xiaolong Xu tiếp tục tinh chỉnh quá trình nạp đầu vào KDA trong PR #51540 và PR #52458.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.