Chuyển bộ nhớ đệm KV qua nhiều tầng trong vLLM
Các mô hình xử lý ngữ cảnh dài và những cuộc hội thoại nhiều lượt tạo ra lượng dữ liệu KV khổng lồ. Khi bộ nhớ của bộ tăng tốc (chẳng hạn HBM trên GPU) đầy, những dữ liệu KV đã được tính toán trước đó sẽ bị loại khỏi bộ nhớ. Khi có yêu cầu tiếp theo cần đến dữ liệu này, vLLM phải tính toán lại từ đầu.
Cơ chế chuyển bộ nhớ đệm KV qua nhiều tầng giúp giữ lại dữ liệu KV đã bị loại khỏi bộ nhớ, bằng cách lưu dữ liệu trong bộ nhớ máy chủ, thiết bị lưu trữ và các máy ngang hàng. Thay vì tính toán lại, vLLM nạp dữ liệu từ tầng lưu trữ thấp hơn. Nhờ đó, hệ thống giảm lượng tính toán phải thực hiện, rút ngắn độ trễ và tăng dung lượng phục vụ thực tế của cả cụm máy.
Khi có thêm các tầng lưu trữ thứ cấp, dữ liệu KV còn có thể được chia sẻ giữa nhiều máy. Điều này cho phép mở rộng quy mô bộ nhớ đệm theo chiều ngang, khởi động các phiên bản mới bằng dữ liệu có sẵn trong kho lưu trữ dùng chung, cũng như truyền dữ liệu KV giữa các máy ngang hàng để tách riêng khâu nạp đầu vào và giải mã hoặc cân bằng tải.
Khung phần mềm này đã có trong vLLM từ phiên bản v0.22. Hướng dẫn sử dụng chi tiết có tại đây.
Thiết kế lấy bộ nhớ máy chủ làm trung tâm
Nguyên tắc cốt lõi của thiết kế này là: toàn bộ dữ liệu KV đều đi qua bộ nhớ máy chủ (DRAM của CPU).
Khi chuyển dữ liệu ra khỏi bộ nhớ bộ tăng tốc, dữ liệu KV trước tiên được chuyển sang bộ nhớ máy chủ. Từ đây, dữ liệu tiếp tục được chuyển đến các tầng lưu trữ thứ cấp như hệ thống tệp, kho lưu trữ đối tượng hoặc các máy ngang hàng. Khi nạp dữ liệu trở lại, luồng di chuyển diễn ra theo chiều ngược lại: tầng thứ cấp đưa dữ liệu vào bộ nhớ máy chủ, sau đó dữ liệu mới được nạp lên bộ tăng tốc.
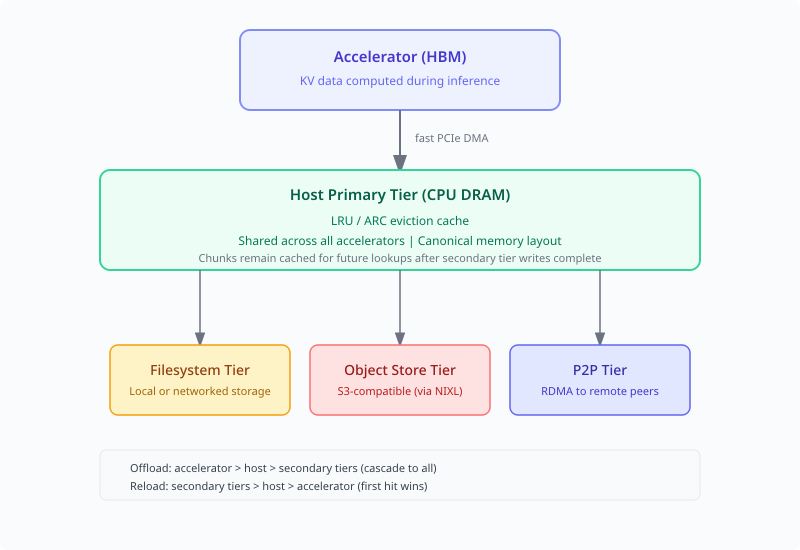
Mọi dữ liệu KV đều đi qua tầng chính là bộ nhớ máy chủ. Các tầng thứ cấp mở rộng dung lượng lưu trữ vượt quá khả năng của DRAM máy chủ. Khi chuyển dữ liệu ra ngoài, các khối dữ liệu được phân phối đến tất cả các tầng. Khi nạp dữ liệu trở lại, tầng đầu tiên có chứa khối cần tìm sẽ cung cấp khối đó.
Thiết kế này mang lại một số lợi ích quan trọng:
Giải phóng bộ nhớ bộ tăng tốc nhanh, chỉ cấp phát khi cần
Việc sao chép dữ liệu từ bộ tăng tốc sang bộ nhớ máy chủ là một thao tác truyền dữ liệu cục bộ tốc độ cao qua PCIe. Bộ nhớ bộ tăng tốc được giải phóng ngay khi sao chép xong, trước khi bất kỳ thao tác truyền dữ liệu nào đến tầng thứ cấp bắt đầu.
Các thao tác ghi vào thiết bị lưu trữ, gửi dữ liệu qua mạng và truyền dữ liệu từ xa bằng RDMA đều sử dụng bản sao trong bộ nhớ máy chủ, không cần truy cập lại bộ nhớ bộ tăng tốc.
Khi nạp dữ liệu trở lại, bộ nhớ bộ tăng tốc chỉ được cấp phát sau khi dữ liệu đã sẵn sàng trong bộ nhớ máy chủ, thay vì phải giữ chỗ từ trước trong lúc chờ truyền dữ liệu qua các tầng.
Hai cơ chế này tạo thành cách cấp phát bộ nhớ đúng lúc: bộ nhớ bộ tăng tốc chỉ được sử dụng trong khoảng thời gian thực sự cần thiết.
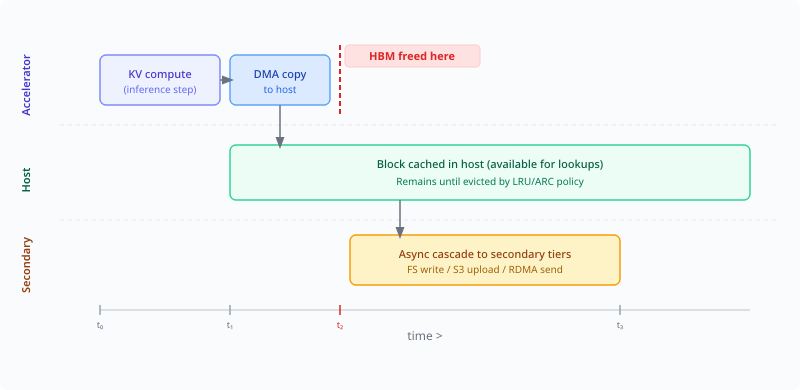
Bộ nhớ bộ tăng tốc được giải phóng tại thời điểm t2, ngay khi hoàn tất sao chép sang bộ nhớ máy chủ. Các thao tác ghi dữ liệu xuống tầng thứ cấp tiếp tục diễn ra không đồng bộ, sử dụng bản sao trong bộ nhớ máy chủ.
Gộp các thao tác vào/ra dữ liệu
Trong hệ thống có nhiều bộ tăng tốc, chẳng hạn với tensor_parallel_size=8, mỗi thiết bị lưu một phần của bộ nhớ đệm KV. Khung phần mềm gộp tất cả các phần dữ liệu này vào một vùng nhớ chung duy nhất trong bộ nhớ máy chủ.
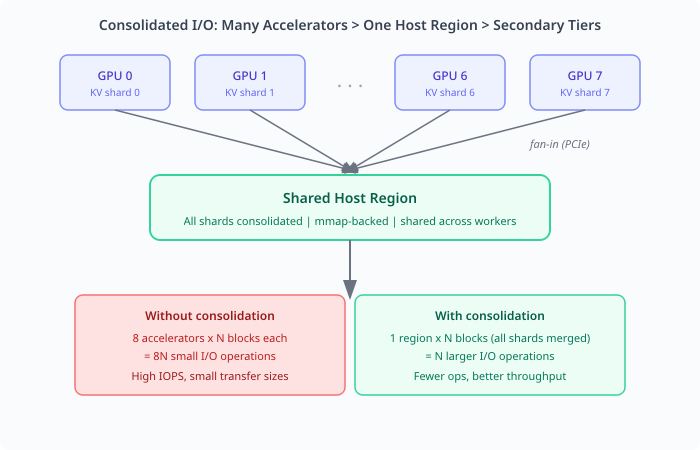
Nhiều phần dữ liệu KV từ các bộ tăng tốc được tập hợp vào một vùng nhớ chung trên máy chủ. Các tầng thứ cấp nhờ đó nhận được ít thao tác vào/ra hơn nhưng mỗi thao tác xử lý lượng dữ liệu lớn hơn, giúp tăng thông lượng lưu trữ và mạng.
Bố trí bộ nhớ thống nhất
Vùng nhớ trên máy chủ sử dụng một cách bố trí dữ liệu thống nhất: mỗi trang lưu một khối dữ liệu của một lớp mô hình, trong đó toàn bộ đầu KV từ các hạng TP được tập hợp vào một vùng nhớ liên tục duy nhất.
Để xác định vị trí của bất kỳ khối dữ liệu nào, hệ thống chỉ cần tính độ lệch trong bộ nhớ. Cách bố trí cố định ở phía máy chủ bảo đảm dữ liệu vẫn được chia sẻ chính xác ngay cả khi cách bố trí bộ nhớ GPU khác nhau giữa các máy.
Dù sử dụng loại bộ tăng tốc khác nhau, bộ phụ trợ cơ chế chú ý khác nhau (FlashAttention, FlashInfer, Triton) hay cấu hình xử lý song song khác nhau, dữ liệu vẫn được ánh xạ về cùng một dạng biểu diễn thống nhất.
Vì cách bố trí này không phụ thuộc vào cấu hình, các máy có thiết lập khác nhau vẫn có thể chia sẻ trực tiếp dữ liệu KV, không cần ánh xạ lại hay chuyển đổi định dạng. Chẳng hạn, với cùng một dữ liệu KV, máy sử dụng TP=2 và máy sử dụng TP=4 sẽ tạo ra các khối dữ liệu giống hệt nhau ở phía máy chủ.
Các tầng thứ cấp đơn giản, dễ vận hành
Việc định tuyến toàn bộ dữ liệu qua bộ nhớ máy chủ giúp các tầng lưu trữ thứ cấp dễ xây dựng và vận hành.
Mỗi tầng thứ cấp chỉ cần một tiến trình cho mỗi phiên bản vLLM. Các tầng này truyền dữ liệu bằng những thư viện thông thường chạy trên CPU, chẳng hạn cơ chế vào/ra POSIX, bộ công cụ phát triển S3 và các thao tác RDMA. Chúng không bao giờ truy cập trực tiếp bộ nhớ hoặc giao diện lập trình của bộ tăng tốc.
Nhờ vậy, hệ thống không cần phối hợp nhiều tiến trình với nhau, cũng không cần hiểu cách bố trí bộ nhớ riêng của từng loại bộ tăng tốc.
Cách chuyển dữ liệu ra ngoài và nạp trở lại
Đơn vị xử lý của cơ chế này là khối dữ liệu (chunk) – một phần dữ liệu KV có kích thước cố định, tương ứng với một nhóm token. Theo mặc định, mỗi khối dữ liệu tương ứng với một khối bộ nhớ trên bộ tăng tốc. Tham số blocks_per_chunk cho phép cấu hình khối dữ liệu lớn hơn, từ đó tăng lượng dữ liệu trong mỗi lần vào/ra ở cả bộ nhớ máy chủ lẫn các tầng thứ cấp.
Luồng chuyển dữ liệu ra ngoài
Các khối KV mới được truyền không đồng bộ từ bộ tăng tốc sang bộ nhớ máy chủ bằng DMA. Bộ nhớ bộ tăng tốc được giải phóng ngay lập tức, trước khi quá trình truyền dữ liệu đến các tầng thứ cấp bắt đầu.
Sau đó, bộ quản lý các tầng lưu trữ đồng thời phân phối các khối dữ liệu đến tất cả các tầng thứ cấp đã cấu hình, bằng cách đọc từ bản sao trong bộ nhớ máy chủ.
Tầng chính là bộ nhớ máy chủ thực sự đóng vai trò bộ nhớ đệm LRU/ARC, chứ không đơn thuần là vùng đệm tạm thời. Các khối dữ liệu tiếp tục được giữ trong bộ nhớ máy chủ và có thể được sử dụng trực tiếp khi có yêu cầu trùng khớp sau này.
Chỉ khi dung lượng bộ nhớ máy chủ không còn đủ, hệ thống mới loại bỏ những khối ít được sử dụng gần đây nhất. Ngay cả khi bị loại khỏi bộ nhớ máy chủ, các khối này vẫn được giữ lại ở những tầng thứ cấp đã nhận chúng.
Luồng nạp dữ liệu trở lại
Bộ lập lịch kiểm tra bộ nhớ đệm trên máy chủ trước. Nếu khối dữ liệu cần tìm đã có sẵn, hệ thống sử dụng ngay mà không cần truy xuất thêm.
Nếu không tìm thấy trong bộ nhớ máy chủ, hệ thống lần lượt truy vấn các tầng thứ cấp theo thứ tự đã cấu hình. Tầng đầu tiên có chứa khối dữ liệu sẽ cung cấp khối đó.
Tầng này đồng thời đưa khối dữ liệu trở lại bộ nhớ máy chủ theo cơ chế không đồng bộ. Trong lúc chờ, bộ lập lịch nhận trạng thái RETRY và kiểm tra lại ở chu kỳ tiếp theo.
Các khối dữ liệu trong cùng một yêu cầu không nhất thiết phải được lấy từ cùng một tầng. Chẳng hạn, một khối có thể được đọc từ hệ thống tệp, trong khi khối khác được lấy từ một máy ngang hàng ở xa.
Các tầng lưu trữ thứ cấp
Hệ thống tệp
Mỗi khối KV được lưu thành một tệp trên thiết bị lưu trữ cục bộ hoặc hệ thống lưu trữ qua mạng. Tên tệp được tạo dựa trên nội dung: những chuỗi token giống nhau sẽ ánh xạ đến cùng một khóa, nhờ đó các đầu vào trùng khớp có thể tự động dùng chung dữ liệu đã lưu trong bộ nhớ đệm.
Khi nhiều phiên bản vLLM cùng sử dụng một điểm gắn kết lưu trữ, chẳng hạn thiết bị lưu trữ kết nối qua mạng hoặc nhiều phiên bản chạy trên cùng một máy, chúng tự động chia sẻ dữ liệu KV mà không cần cấu hình bổ sung.
Các đặc điểm chính:
-
-
-
- Tra cứu không chặn
- Ghi dữ liệu nguyên tử
- Các nhóm luồng đọc và ghi riêng biệt
-
-
vllm serve Qwen/Qwen3.6-35B-A3B \
    --kv-transfer-config '{
        "kv_connector_extra_config": {
            "spec_name": "TieringOffloadingSpec",
            "cpu_bytes_to_use": 107374182400,
            "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}]
        }
    }'
Kho lưu trữ đối tượng
Lưu các khối KV trong những kho lưu trữ đối tượng tương thích với S3 thông qua NIXL. Cách đặt tên dựa trên nội dung giống với tầng hệ thống tệp. Đây là lựa chọn lưu trữ qua mạng có chi phí hợp lý: giá cho mỗi GB thường thấp hơn so với hệ thống tệp hiệu năng cao, đồng thời vẫn cho phép nhiều phiên bản dùng chung dữ liệu.
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{
            "type": "obj",
            "bucket": "my-kv-cache",
            "endpoint_override": "http://minio:9000"
        }]
    }
}'
Truyền dữ liệu ngang hàng (P2P)
Cho phép chia sẻ bộ nhớ đệm KV giữa các phiên bản qua mạng. Hệ thống sử dụng ZMQ để điều phối và RDMA thông qua NIXL để truyền lượng lớn dữ liệu. Mọi thao tác truyền đều diễn ra trực tiếp giữa các máy chủ; không bên nào cần truy cập bộ nhớ của bộ tăng tốc.
Tầng P2P không quyết định sẽ lấy dữ liệu KV từ máy ngang hàng nào. Việc này thuộc về lớp điều phối, chẳng hạn bộ định tuyến như llm-d. Bộ điều phối khởi tạo các thao tác truyền dữ liệu giữa các máy thông qua kv_transfer_params của yêu cầu. Bạn có thể xem ví dụ và thông tin chi tiết trong hướng dẫn sử dụng.
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}]
    }
}'
Hai trường hợp sử dụng chính:
Tách riêng khâu nạp đầu vào và giải mã
Máy thực hiện nạp đầu vào tính toán các khối KV rồi cung cấp chúng trong tầng bộ nhớ đệm của máy chủ. Máy thực hiện giải mã lấy các khối này trực tiếp từ bộ nhớ máy chủ của máy nạp đầu vào thông qua RDMA.
So với các phương pháp tách riêng nạp đầu vào và giải mã dựa trên GPU, cách này có một ưu điểm quan trọng: việc gộp dữ liệu biến nhiều lần truyền nhỏ từ từng GPU thành một số ít thao tác RDMA có kích thước lớn hơn, nhờ đó cải thiện đáng kể thông lượng mạng.
Ngoài ra, khi sử dụng cơ chế nạp đầu vào theo từng khối (chunked prefill), mỗi khối hoàn tất có thể được chuyển đi ngay lập tức. Việc tính toán và truyền dữ liệu diễn ra chồng lấp nhau, giúp rút ngắn thời gian nhận token đầu tiên.
Cân bằng tải
Chuyển các khối KV từ một phiên bản vLLM đang quá tải sang phiên bản còn dung lượng xử lý. Bất kỳ máy nào cũng có thể lấy các khối dữ liệu từ bất kỳ máy ngang hàng nào.
Để tìm hiểu thêm về cách chia sẻ bộ nhớ đệm KV ngang hàng bằng llm-d, hãy xem bài viết này.
Hỗ trợ mô hình kết hợp nhiều loại lớp
Khung phần mềm này tích hợp với bộ cấp phát bộ nhớ dành cho mô hình kết hợp của vLLM. Các mô hình sử dụng nhiều loại lớp khác nhau – cơ chế chú ý toàn phần, cơ chế chú ý cửa sổ trượt, MLA và Mamba – đều được xử lý tự động.
Cách bố trí bộ nhớ thống nhất chuyển mọi định dạng KV thành một dạng biểu diễn chung dưới dạng vùng đệm byte. Mỗi khối dữ liệu có kích thước byte cố định trong bộ nhớ máy chủ, bất kể khối đó chứa những loại lớp nào.
Các loại lớp khác nhau có thể chứa số lượng token khác nhau trong cùng một khối dữ liệu. Chẳng hạn, các lớp lưu trạng thái của Mamba bao phủ nhiều token hơn đáng kể trong mỗi khối so với các lớp dùng cơ chế chú ý toàn phần. Vì vậy, chúng cần được chuyển ra khỏi bộ nhớ ít thường xuyên hơn.
Điều này mang lại hai lợi ích:
-
-
-
- Các lớp dùng cơ chế chú ý cửa sổ trượt chỉ nạp lại những token nằm trong cửa sổ, thay vì toàn bộ lịch sử.
- Các lớp không gian trạng thái như Mamba chuyển cả trạng thái của chúng ra ngoài và nạp trở lại, song song với dữ liệu KV của cơ chế chú ý.
-
-
Khung phần mềm này hỗ trợ những kiến trúc kết hợp tiên tiến nhất hiện nay, bao gồm DeepSeek V4, GLM 5.3, Nemotron 3 và nhiều kiến trúc khác.
Theo dõi và giám sát hoạt động
Khung phần mềm cung cấp các chỉ số Prometheus thông qua điểm cuối /metrics tiêu chuẩn của vLLM, bao gồm:
-
-
-
- Mức sử dụng bộ nhớ đệm trên máy chủ – tỷ lệ dung lượng đã sử dụng của tầng chính tại thời điểm hiện tại.
- Thông lượng truyền dữ liệu – lượng dữ liệu và thời gian truyền giữa bộ tăng tốc với bộ nhớ máy chủ.
- Độ trễ của từng tầng – thời gian tra cứu và truyền dữ liệu ở mỗi tầng.
- Tỷ lệ tìm thấy dữ liệu trong bộ nhớ đệm của từng tầng – cho biết những tầng nào đang phục vụ khối lượng công việc.
-
-
Các tầng thứ cấp có thể tự định nghĩa những chỉ số riêng, chẳng hạn bộ đếm, biểu đồ phân bố và giá trị đo tức thời. Những chỉ số này sẽ được tự động đăng ký và cung cấp, không cần sửa đổi khung phần mềm.
Sự kiện KV
Khi các khối dữ liệu di chuyển giữa các tầng, khung phần mềm phát ra những sự kiện KV có cấu trúc, ghi lại khối nào được lưu hoặc bị loại bỏ, thao tác diễn ra ở tầng nào và dữ liệu thuộc phạm vi cục bộ hay từ xa. Các tầng thứ cấp cũng có thể phát ra sự kiện riêng.
Những sự kiện này cho phép các hệ thống điều phối bên ngoài đưa ra quyết định định tuyến thông minh hơn. Các dự án như llm-d và Dynamo sử dụng sự kiện KV để chuyển yêu cầu đến phiên bản có khả năng tìm thấy dữ liệu sẵn trong bộ nhớ đệm cao nhất. Cách này giúp tăng đáng kể thông lượng và giảm độ trễ so với cơ chế lập lịch không xét đến trạng thái bộ nhớ đệm.
Ngoài ra, llm-d còn sử dụng những sự kiện này để điều phối việc truyền dữ liệu KV ngang hàng giữa các máy.
Thêm một tầng lưu trữ thứ cấp mới
Giao diện dành cho tầng thứ cấp rất gọn, chỉ gồm bốn phương thức cốt lõi:
class SecondaryTierManager(ABC):

    def lookup(self, key, req_context) -> LookupResult:
        """Does this tier have a chunk? Returns HIT, MISS, or RETRY."""

    def submit_store(self, job_metadata: JobMetadata) -> None:
        """Start async store from host to this tier."""

    def submit_load(self, job_metadata: JobMetadata) -> None:
        """Start async load from this tier to host."""

    def get_finished_jobs(self) -> Iterable[JobResult]:
        """Poll completed transfers."""
Ngay khi được khởi tạo, mỗi tầng nhận một memoryview trực tiếp trỏ đến vùng nhớ chung trên máy chủ. Khi gọi submit_store(), tầng đọc dữ liệu KV trực tiếp từ vùng nhớ này. Khi gọi submit_load(), tầng ghi dữ liệu vào chính vùng nhớ đó.
Không cần tạo bản sao trung gian hay tuần tự hóa dữ liệu – tầng thứ cấp làm việc trực tiếp trên bộ nhớ của tầng chính.
Mỗi tầng thứ cấp cũng tự quản lý chính sách loại bỏ dữ liệu của mình, độc lập với các tầng khác.
Một bản triển khai tham khảo hoàn chỉnh sử dụng bộ nhớ trong có tại vllm/v1/kv_offload/tiering/example/.
Khung phần mềm cũng hỗ trợ các tầng thứ cấp được phát triển bên ngoài mã nguồn vLLM. Chỉ cần khai báo module_path trong cấu hình tầng, vLLM sẽ tự nạp phần triển khai SecondaryTierManager do bạn cung cấp mà không cần sửa đổi mã nguồn vLLM.
Hiệu năng - Mở rộng quy mô phục vụ nhiều người dùng hơn
Lợi ích chính của việc chuyển bộ nhớ đệm KV sang các tầng lưu trữ khác là tránh phải tính toán lại toàn bộ phần nạp đầu vào vốn rất tốn kém, bằng cách nạp lại dữ liệu KV từ một tầng có chi phí thấp hơn.
Khi số cuộc hội thoại đồng thời còn ít, mọi phương pháp lưu bộ nhớ đệm đều đạt thông lượng cao vì bộ nhớ GPU đủ sức chứa toàn bộ dữ liệu đang sử dụng. Khi số cuộc hội thoại tăng lên, giới hạn dung lượng của từng tầng dần xuất hiện:
-
-
-
- Đến khoảng 64 cuộc hội thoại: HBM chứa đủ dữ liệu đang hoạt động nên mọi phương pháp lưu bộ nhớ đệm đều hoạt động tốt.
- Từ 64 đến 128 cuộc hội thoại: HBM bắt đầu đầy. Nếu không chuyển dữ liệu sang nơi khác, thông lượng giảm mạnh. Chuyển dữ liệu sang bộ nhớ CPU giúp duy trì hiệu năng.
- Trên 128 cuộc hội thoại: Bộ nhớ đệm của CPU cũng đầy. Chuyển dữ liệu sang thiết bị lưu trữ vẫn duy trì được tỷ lệ tìm thấy dữ liệu trong bộ nhớ đệm ở mức cao, giúp thông lượng tăng hơn gấp đôi so với các phương án còn lại.
-
-
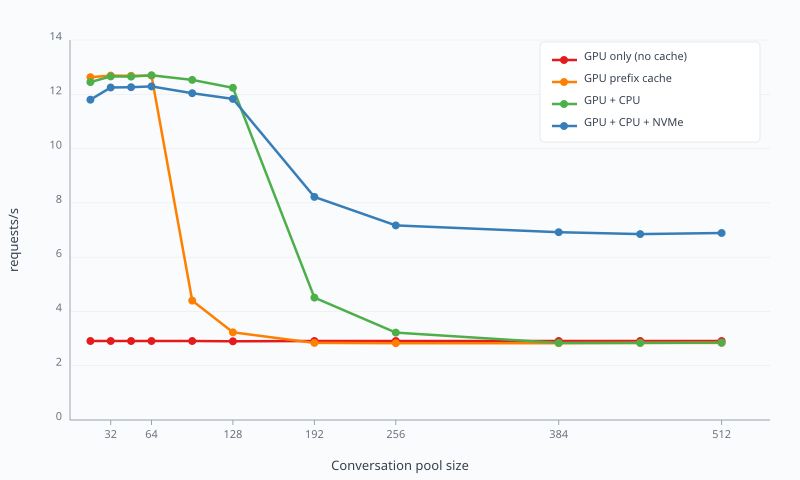
Thiết bị lưu trữ có độ trễ cao hơn bộ nhớ CPU nên không thể đạt thông lượng cực đại. Tuy nhiên, khi quy mô tăng lên, lựa chọn thực tế là lấy dữ liệu có sẵn từ bộ nhớ đệm trên thiết bị lưu trữ hay tính toán lại toàn bộ. Trong trường hợp này, lấy dữ liệu từ thiết bị lưu trữ có lợi thế rõ rệt.
Cấu hình đo hiệu năng:
-
-
-
- Mô hình: Qwen/Qwen3.6-35B-A3B, chạy trên 2 GPU NVIDIA H100 (TP=2).
- Tầng lưu trữ: Bộ phụ trợ hệ thống tệp, sử dụng ổ NVMe cục bộ.
- Khối lượng công việc: Hội thoại nhiều lượt, mỗi hội thoại có 12K token đầu vào ban đầu và thêm 4K token ở mỗi lượt, tổng cộng 8 lượt.
- Mức đồng thời tối đa của yêu cầu: 64.
- Phạm vi đo: Chỉ đo thông lượng của máy nạp đầu vào trong cấu hình tách riêng nạp đầu vào và giải mã.
-
-
Toàn bộ kết quả hiệu năng và các tập lệnh dùng để tái hiện phép đo có tại neuralmagic/fs-offload-experiments.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI tính phí theo từng phút sử dụng, minh bạch và không có phí ẩn. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.