Tăng tốc truyền bộ nhớ đệm KV theo cơ chế đẩy để giảm TTFT và TPOT trong mô hình suy luận tách rời của vLLM
vLLM là công cụ mã nguồn mở dùng để suy luận và vận hành các mô hình ngôn ngữ lớn (LLM).
Quá trình suy luận của LLM gồm hai giai đoạn riêng biệt. Giai đoạn tiền xử lý đầu vào (prefill) xử lý lời nhắc đầu vào và tạo bộ nhớ đệm khóa-giá trị (KV). Giai đoạn sinh token (decode) sử dụng bộ nhớ đệm này để tạo đầu ra, mỗi lần một token. Hai giai đoạn có đặc điểm khác nhau về năng lực tính toán, bộ nhớ và khả năng mở rộng.
Phương pháp tách rời tiền xử lý và sinh token (P-D disaggregation) trong vLLM chạy hai giai đoạn trên các phiên bản bộ máy riêng biệt. Nhờ đó, mỗi giai đoạn có thể được mở rộng và tối ưu độc lập, giúp sử dụng tài nguyên hiệu quả hơn, tăng thông lượng và giảm độ trễ khi hệ thống chịu tải cao.
Tuy nhiên, cách triển khai này cũng đòi hỏi phải chuyển bộ nhớ đệm KV từ máy xử lý tiền xử lý sang máy sinh token trước khi bắt đầu tạo đầu ra. Vì vậy, hiệu quả truyền KV có ảnh hưởng trực tiếp đến thời gian tạo token đầu tiên (TTFT).
Một trong những phương thức truyền dữ liệu mà vLLM hỗ trợ là thông qua bộ kết nối của NVIDIA Inference Xfer Library (NIXL). Bộ kết nối này truyền các khối KV qua mạng hỗ trợ RDMA, chẳng hạn như AWS Elastic Fabric Adapter (AWS EFA), một công nghệ mạng RDMA có độ trễ thấp được sử dụng để kết nối các máy chủ trên AWS.
Trên các loại máy chủ được hỗ trợ, AWS EFA hỗ trợ GPUDirect RDMA và Neuron Direct RDMA. Nhờ đó, NIXL có thể truyền trực tiếp các khối KV giữa bộ nhớ của GPU hoặc thiết bị Trainium mà không cần chuyển tiếp qua bộ nhớ máy chủ.
Chế độ mặc định của bộ kết nối NIXL là truyền theo cơ chế kéo (pull). Sau khi máy tiền xử lý hoàn tất việc tạo bộ nhớ đệm KV cho lời nhắc, bộ định tuyến chuyển thông tin mô tả dữ liệu nguồn, bao gồm mã định danh các khối KV ở máy tiền xử lý, sang máy sinh token. Tiếp đó, máy sinh token cấp phát các khối đích, chuẩn bị quá trình truyền bằng NIXL rồi gửi yêu cầu NIXL READ để lấy các khối KV từ máy tiền xử lý.
Các bước phối hợp và chuẩn bị này diễn ra tuần tự sau khi tiền xử lý hoàn tất và trước khi quá trình sinh token bắt đầu. Do đó, chúng kéo dài đường xử lý quyết định thời gian tạo token đầu tiên, như minh họa trong sơ đồ bên dưới.
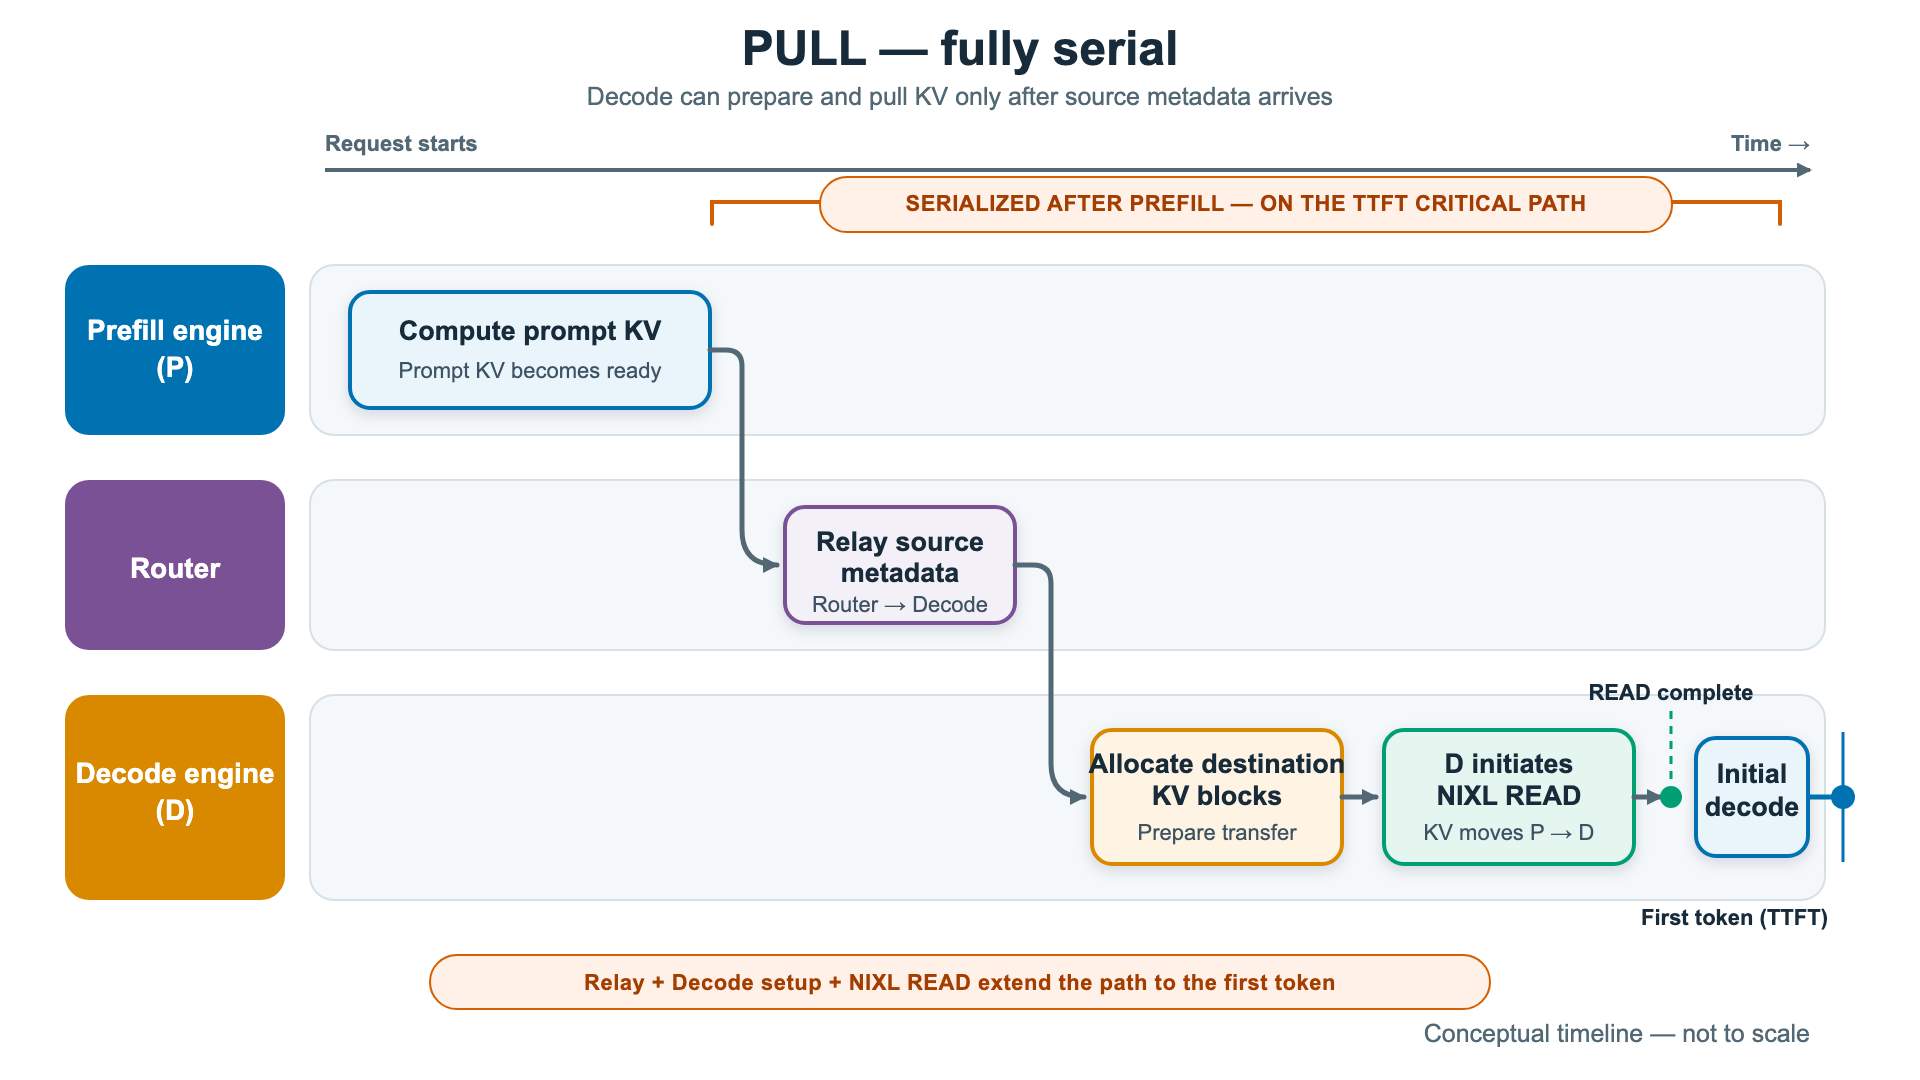
Diễn tiến của chế độ kéo: chuyển tiếp thông tin qua bộ định tuyến, cấp phát bộ nhớ ở máy sinh token và thực hiện NIXL READ lần lượt nối tiếp nhau trước khi token đầu tiên được tạo.
Bài viết này giới thiệu bộ kết nối NIXL truyền theo cơ chế đẩy (push), giúp đưa các bước phối hợp và chuẩn bị truyền dữ liệu sau tiền xử lý ra khỏi đường xử lý quyết định độ trễ. Với khách hàng sử dụng vLLM để suy luận theo mô hình tách rời tiền xử lý và sinh token, phương pháp này có thể cải thiện tốc độ phản hồi của ứng dụng nhờ giảm TTFT và thời gian xử lý trung bình cho mỗi token đầu ra (TPOT), đặc biệt khi số lượng yêu cầu tăng cao.
Trong thử nghiệm trên hệ thống triển khai 1P1D, sử dụng các máy Amazon EC2 P5en kết nối qua EFA, chế độ đẩy đạt TTFT tốt hơn tới 3 lần và giảm TPOT tới 30% so với chế độ kéo khi chạy mô hình Qwen3-32B. Xem mục Dữ liệu hiệu năng để biết thêm chi tiết. Kết quả thực tế còn phụ thuộc vào khối lượng công việc và cấu hình hệ thống.
Đội ngũ đã xây dựng và kiểm chứng tính năng này trên các cụm máy AWS Trainium kết nối qua EFA, sau đó đóng góp tính năng vào vLLM theo hướng không phụ thuộc vào loại bộ tăng tốc. Kết quả trong bài viết được đo trên cụm máy AWS p5en sử dụng GPU và EFA, cho thấy lợi ích của phương pháp này cũng được duy trì trên GPU.
Bài viết sẽ giải thích kiến trúc truyền theo cơ chế đẩy, luồng truyền dữ liệu, mô hình phân chia luồng xử lý, kết quả hiệu năng và cách tái tạo thử nghiệm.
Truyền KV theo cơ chế đẩy
Tổng quan kiến trúc
Cơ chế truyền theo kiểu đẩy cải thiện TTFT và thông lượng sinh token nhờ hai yếu tố:
-
-
-
- Loại bỏ các bước tuần tự của cơ chế kéo bằng cách cho phép bên gửi và bên nhận làm việc đồng thời. Máy sinh token đăng ký trước các khối bộ nhớ đích trong khi máy tiền xử lý vẫn đang tạo KV. Ngay khi các khối dữ liệu ở bên gửi sẵn sàng, quá trình truyền có thể bắt đầu mà không cần chờ một lượt trao đổi thông tin để bên nhận tìm và xác định các khối dữ liệu. Nhờ vậy, lượt trao đổi này được loại khỏi đường xử lý dẫn đến token đầu tiên.
- Chuyển thời gian chuẩn bị truyền dữ liệu ra khỏi máy sinh token. Công việc chuẩn bị bộ mô tả dữ liệu cho NIXL và gửi yêu cầu truyền được thực hiện ở phía tiền xử lý trên một luồng chạy nền. Vì vậy, máy sinh token không phải dành thời gian cho các bước này trong giai đoạn tạo token vốn rất nhạy cảm với độ trễ.
-
-
Kết quả là TTFT giảm và thông lượng tạo token đầu ra của máy sinh token tăng lên.
Bộ kết nối kiểu đẩy phối hợp ba thành phần: máy sinh token đăng ký trước các khối bộ nhớ đích; máy tiền xử lý ghép nối từng yêu cầu và khởi tạo việc truyền dữ liệu; một luồng chạy nền chuyên dụng đảm nhận việc ghi KV, tránh làm gián đoạn vòng lặp xử lý chính của bộ máy.
Sơ đồ bên dưới minh họa cách các thành phần này phối hợp với nhau.
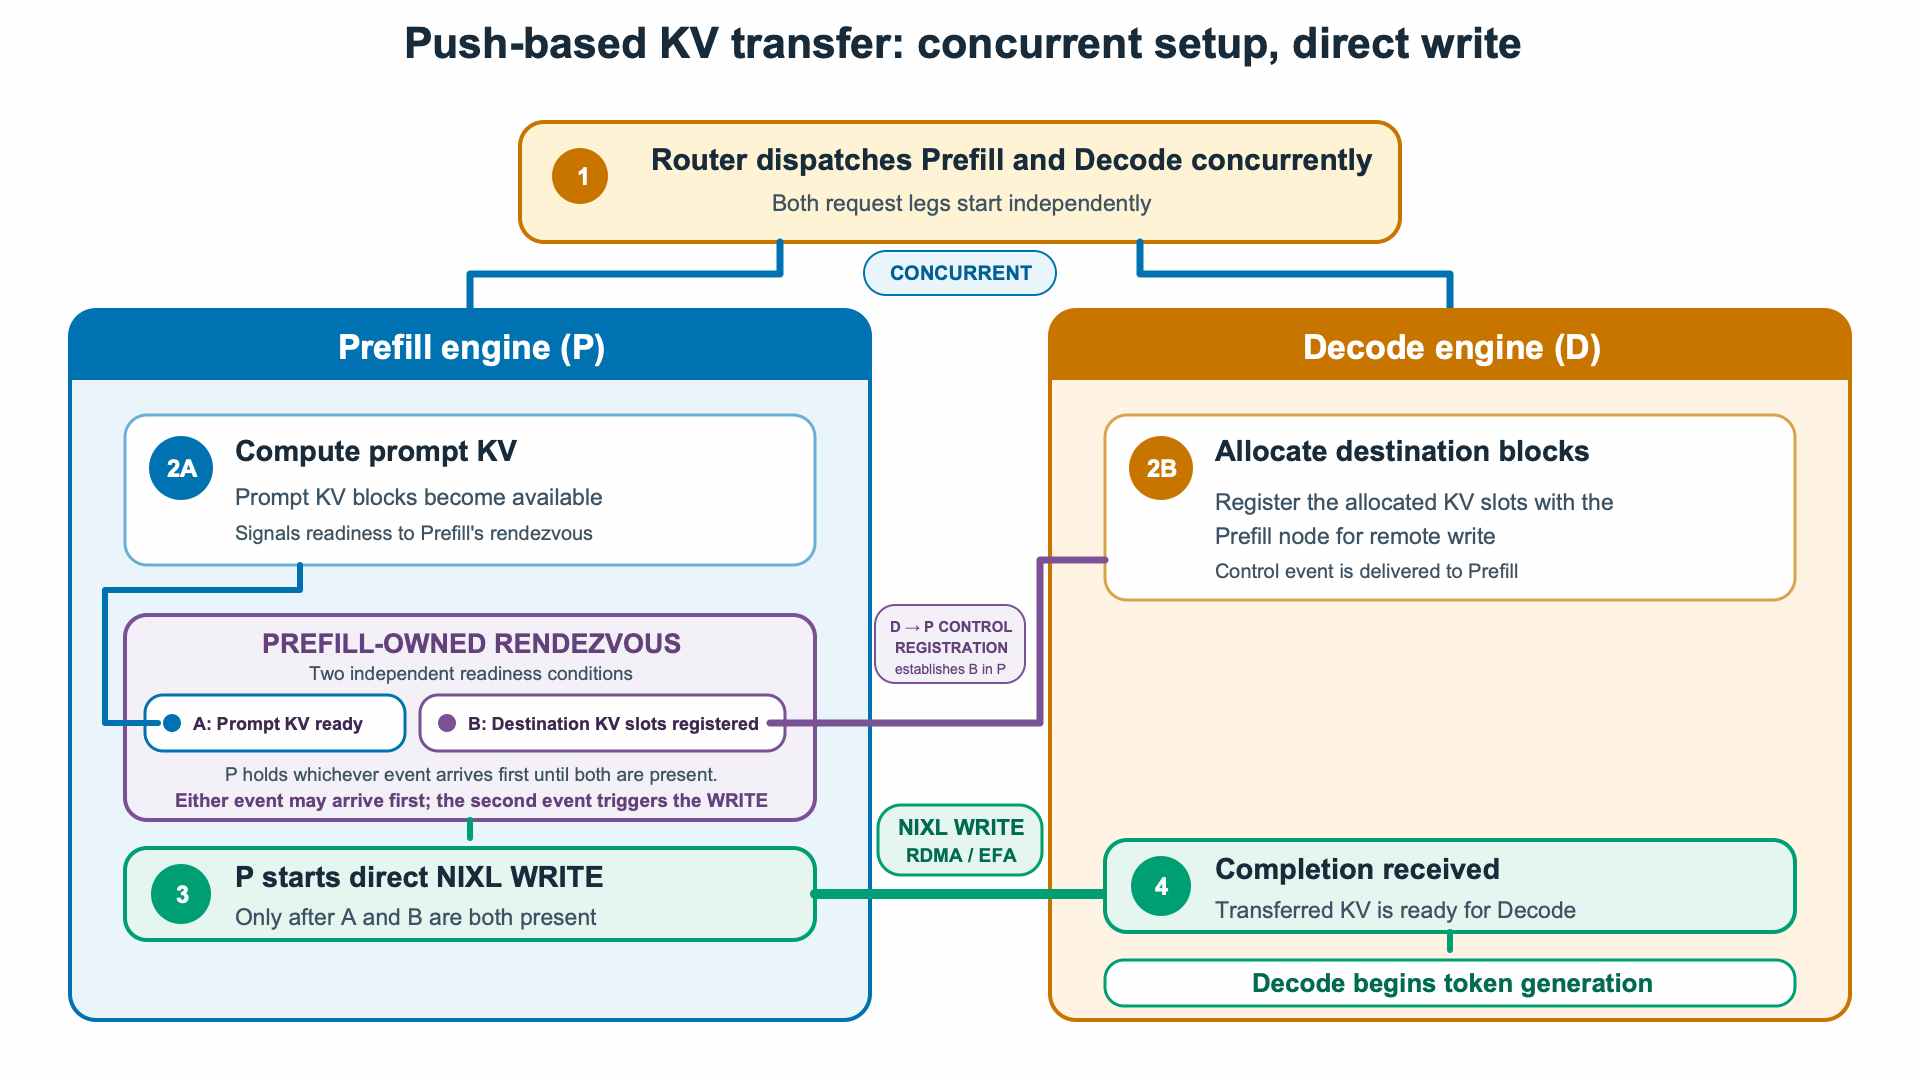
Tổng quan kiến trúc truyền KV theo cơ chế đẩy: máy sinh token đăng ký các khối bộ nhớ với máy tiền xử lý, sau đó máy tiền xử lý đẩy KV sang máy sinh token bằng lệnh NIXL WRITE.
Chi tiết triển khai
Giao thức truyền gồm ba bước chính.
- Đăng ký ở phía sinh token
Khi máy sinh token cấp phát các khối bộ nhớ cục bộ cho một yêu cầu cần nhận dữ liệu tiền xử lý từ máy khác, nó tạo thông tin đăng ký cho biết máy tiền xử lý cần ghi KV vào đâu. Thông tin này bao gồm định danh của máy nhận và vị trí các khối bộ nhớ vừa được dành riêng.
Trong cùng một bước xử lý của bộ máy, tiến trình làm việc sẽ gửi thông tin đăng ký này đến máy tiền xử lý dưới dạng thông báo NIXL. Vì đăng ký được thực hiện ngay lúc cấp phát bộ nhớ, bộ kết nối đã biết các khối đích trước khi máy tiền xử lý hoàn tất việc xử lý đầu vào.
- Ghép nối yêu cầu ở phía tiền xử lý
Thông tin đăng ký từ máy sinh token và tín hiệu hoàn tất tiền xử lý từ máy gửi có thể đến theo bất kỳ thứ tự nào. Bộ kết nối được thiết kế để xử lý cả hai trường hợp.
Nếu thông tin đăng ký đến trước, máy gửi sẽ giữ thông tin đó cho đến khi hoàn tất tiền xử lý. Nếu tiền xử lý hoàn tất trước, máy gửi sẽ giữ lại các khối KV của yêu cầu cho đến khi nhận được thông tin đăng ký.
Bất kể sự kiện nào xảy ra sau cùng cũng sẽ kích hoạt quá trình truyền dữ liệu. Bộ kết nối ghép nối các yêu cầu dựa trên mã định danh, đồng thời xử lý cả những yêu cầu được gửi lại, bảo đảm các yêu cầu bị tạm dừng hoặc thử lại được liên kết đúng với dữ liệu tương ứng.
- Truyền dữ liệu ở phía tiền xử lý
Sau khi ghép nối thành công một yêu cầu, máy gửi sẽ thiết lập kết nối đến máy sinh token nếu chưa có kết nối sẵn, rồi gửi lệnh NIXL WRITE để sao chép trực tiếp các khối KV vào vùng bộ nhớ đã đăng ký của máy nhận. Việc truyền được thực hiện đến đúng từng hạng xử lý song song tensor ở phía nhận.
Cách bố trí các khối bộ nhớ bên trong máy gửi và máy nhận có thể khác nhau. Khi truyền dữ liệu, mỗi bên tự ánh xạ vị trí các khối sang cách bố trí vật lý của mình. Nhờ đó, hai bên có thể sử dụng kích thước khối khác nhau.
Mỗi lệnh WRITE đi kèm một thông báo hoàn tất. Khi dữ liệu đến nơi, NIXL gửi thông báo này đến máy sinh token. Máy nhận đếm số thông báo, tương ứng với từng hạng xử lý ở phía gửi có ghi dữ liệu vào máy nhận. Chỉ khi nhận đủ tất cả thông báo dự kiến, máy sinh token mới xác định rằng KV đã được truyền đầy đủ và tiếp tục sinh token.
Mô hình phân chia luồng xử lý
Bộ kết nối kiểu đẩy tách biệt việc thực thi mô hình khỏi công đoạn chuẩn bị truyền KV bằng cách sử dụng một luồng truyền chạy nền chuyên dụng trên mỗi tiến trình xử lý ở phía tiền xử lý.
Khi bắt đầu một yêu cầu, vòng lặp chính của máy sinh token cấp phát các khối KV đích và đăng ký chúng với máy tiền xử lý. Trong khi đó, vòng lặp chính của máy tiền xử lý tiếp tục tạo bộ nhớ đệm KV cho lời nhắc đầu vào.
Khi cả thông tin đăng ký bộ nhớ đích và KV của lời nhắc đều sẵn sàng, vòng lặp chính ở máy tiền xử lý chuyển các khối KV cho luồng chạy nền rồi nhanh chóng quay lại xử lý mô hình.
Luồng chạy nền sẽ thiết lập kết nối NIXL mới hoặc sử dụng lại kết nối hiện có, ánh xạ mã định danh các khối KV của yêu cầu sang bộ mô tả bộ nhớ, gộp những khối nằm liền kề thành các vùng truyền lớn hơn rồi gửi lệnh NIXL WRITE đến máy sinh token.
Khi NIXL hoàn tất truyền dữ liệu, nó gửi thông báo hoàn tất đến máy sinh token, cho phép máy này bắt đầu tạo đầu ra.
Việc chuyển công đoạn chuẩn bị bộ mô tả và gửi yêu cầu truyền ra khỏi vòng lặp chính giúp tránh để những công việc phát sinh theo từng yêu cầu làm chậm quá trình thực thi mô hình. Sơ đồ bên dưới minh họa cách công việc được chuyển giao giữa vòng lặp chính và luồng chạy nền khi xử lý một yêu cầu.
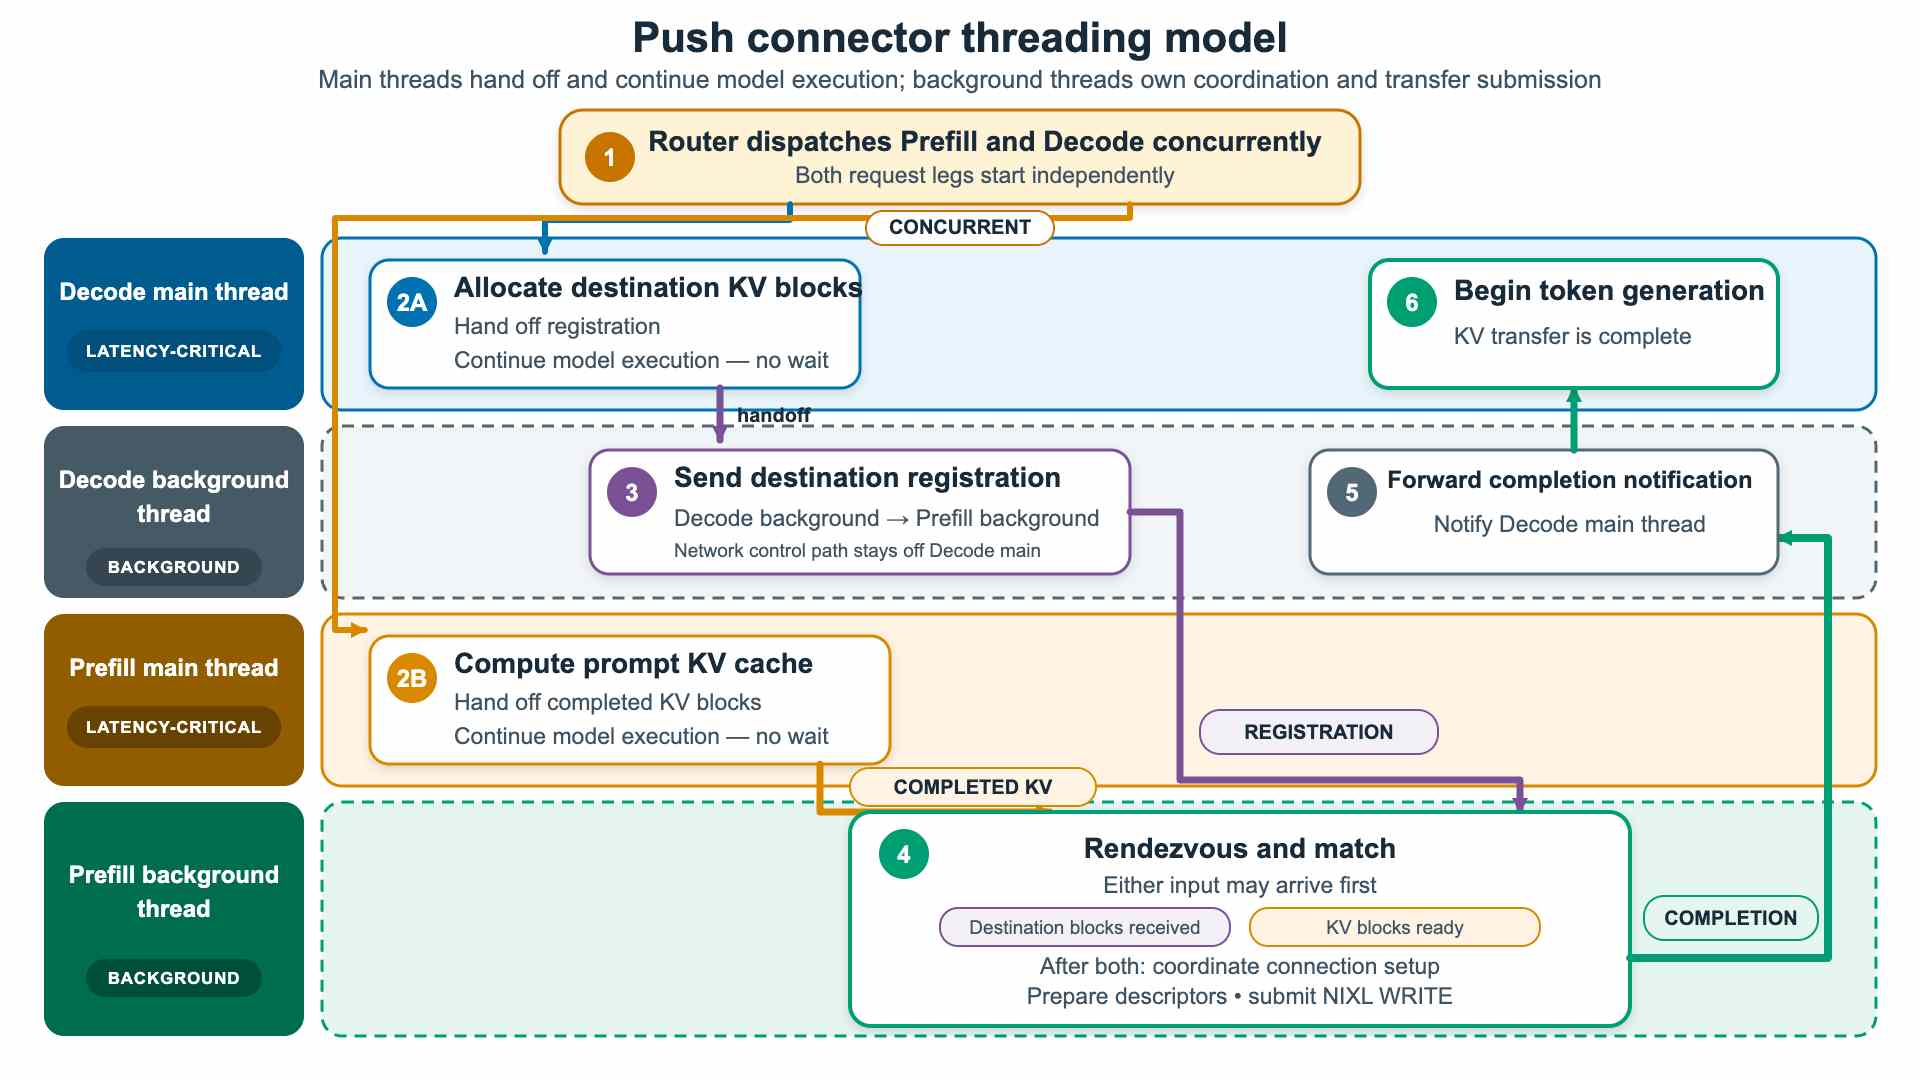
Sơ đồ trình tự của một yêu cầu theo cơ chế đẩy, thể hiện việc chuyển giao công việc giữa vòng lặp chính và luồng chạy nền ở cả máy tiền xử lý lẫn máy sinh token.
So sánh thời gian: Cơ chế kéo và cơ chế đẩy
Sơ đồ bên dưới tóm tắt luồng truyền dữ liệu của hai cơ chế kéo và đẩy đã trình bày ở trên, đồng thời làm rõ ảnh hưởng của chúng đến TTFT.
Mặc dù cả hai chế độ đều sử dụng cùng đường truyền dữ liệu NIXL qua EFA/RDMA, cơ chế kéo chỉ chuyển tiếp thông tin và chuẩn bị bộ nhớ ở máy sinh token sau khi tiền xử lý hoàn tất. Ngược lại, cơ chế đẩy cho phép thực hiện bước chuẩn bị ở máy sinh token song song với quá trình tiền xử lý.
Nhờ vậy, cơ chế đẩy loại bỏ các thao tác này khỏi chuỗi công việc bắt buộc phải hoàn tất sau tiền xử lý, giúp quá trình sinh token bắt đầu sớm hơn.
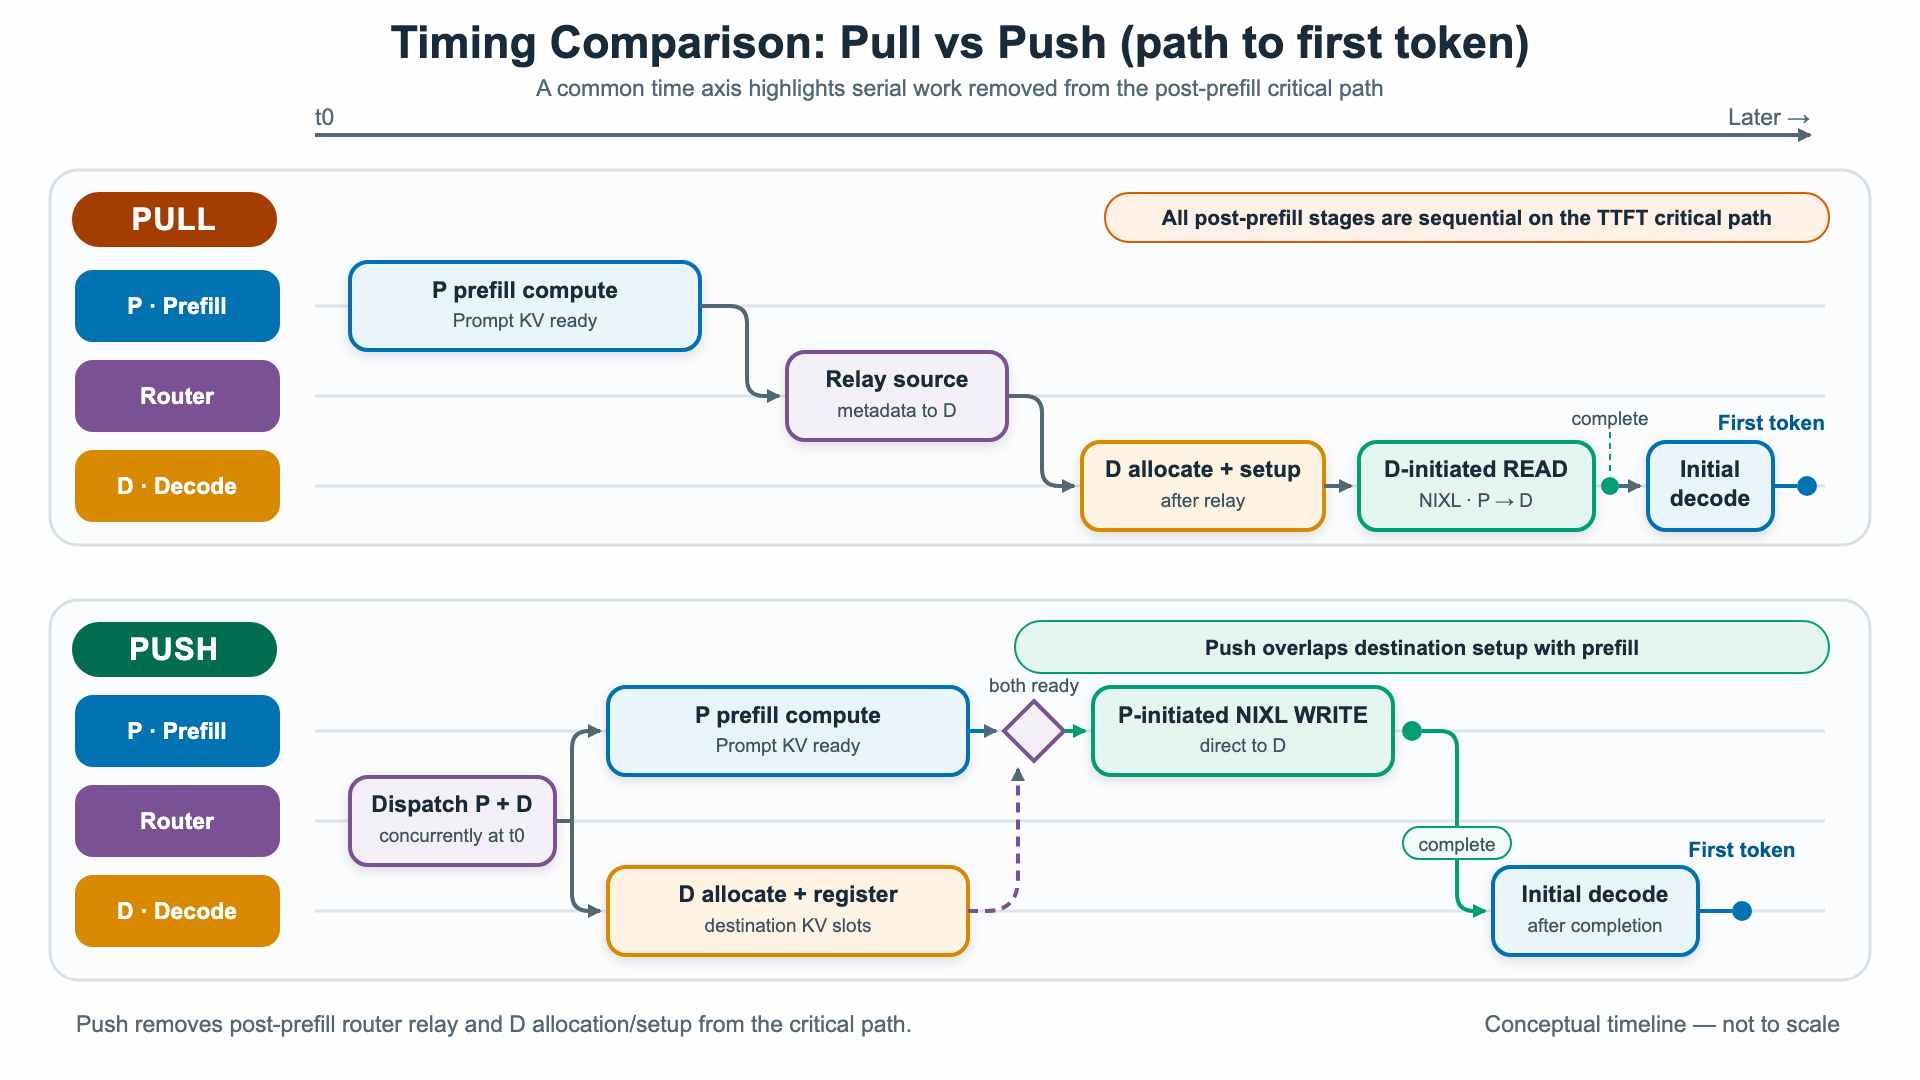
Sơ đồ so sánh thời gian của cơ chế kéo và cơ chế đẩy trên đường xử lý dẫn đến token đầu tiên.
Hai chế độ này cũng có sự đánh đổi về cách định tuyến yêu cầu.
Với cơ chế kéo, bộ định tuyến có thể chọn máy sinh token sau khi tiền xử lý hoàn tất. Điều này mang lại sự linh hoạt cao hơn khi phân phối tải và quản lý chất lượng dịch vụ.
Với cơ chế đẩy, máy sinh token được chọn sớm hơn để có thể chuẩn bị bộ nhớ đích song song với quá trình tiền xử lý. Đổi lại, khi mức tải tương đương, máy tiền xử lý có thể giải phóng các khối KV sớm hơn vì quá trình truyền bắt đầu ngay khi cả KV của lời nhắc và thông tin đăng ký bộ nhớ đích đều sẵn sàng.
Dữ liệu hiệu năng
Để đánh giá hiệu năng, đội ngũ sử dụng mô hình Qwen3-32B trên hệ thống triển khai 1P1D, chạy bằng các máy Amazon EC2 P5en kết nối qua EFA.
Để đo riêng hiệu năng truyền dữ liệu từ máy tiền xử lý sang máy sinh token, đội ngũ tắt chức năng lưu đệm tiền tố bằng tham số --no-enable-prefix-caching. Với cấu hình này, máy sinh token phải lấy toàn bộ bộ nhớ đệm KV từ máy tiền xử lý cho mỗi yêu cầu.
Nếu không tắt chức năng lưu đệm, các lời nhắc có nội dung trùng lặp có thể sử dụng lại bộ nhớ đệm cục bộ ở máy sinh token và bỏ qua bước truyền dữ liệu. Điều đó sẽ khiến kết quả so sánh không phản ánh đúng hiệu năng truyền KV.
Biểu đồ bên dưới so sánh TTFT giữa hai cơ chế truyền KV kéo và đẩy. Thử nghiệm thay đổi độ dài đầu vào từ 1.000 đến 16.000 token, đồng thời tăng tốc độ tiếp nhận yêu cầu từ 1 đến 8 QPS, tức số yêu cầu mỗi giây.
Khi tải thấp và lời nhắc ngắn, hiệu năng của hai chế độ gần như tương đương. Tuy nhiên, khi số yêu cầu mỗi giây và độ dài đầu vào tăng lên, chế độ kéo suy giảm rõ rệt. Ở mức 8 QPS với đầu vào 16.000 token, TTFT của chế độ kéo đạt khoảng 1.744 ms. Trong khi đó, chế độ đẩy duy trì mức khoảng 540 ms, tương đương giảm độ trễ khoảng 3 lần.
Sự chênh lệch xuất hiện vì ở chế độ kéo, máy sinh token phải tạo và gửi các bộ mô tả dữ liệu cho NIXL ngay trong vòng lặp xử lý chính của bộ máy, theo cách đồng bộ. Công việc này làm gián đoạn quá trình tạo token. Chế độ đẩy chuyển công việc đó sang luồng chạy nền, đưa nó ra khỏi đường xử lý quyết định độ trễ.
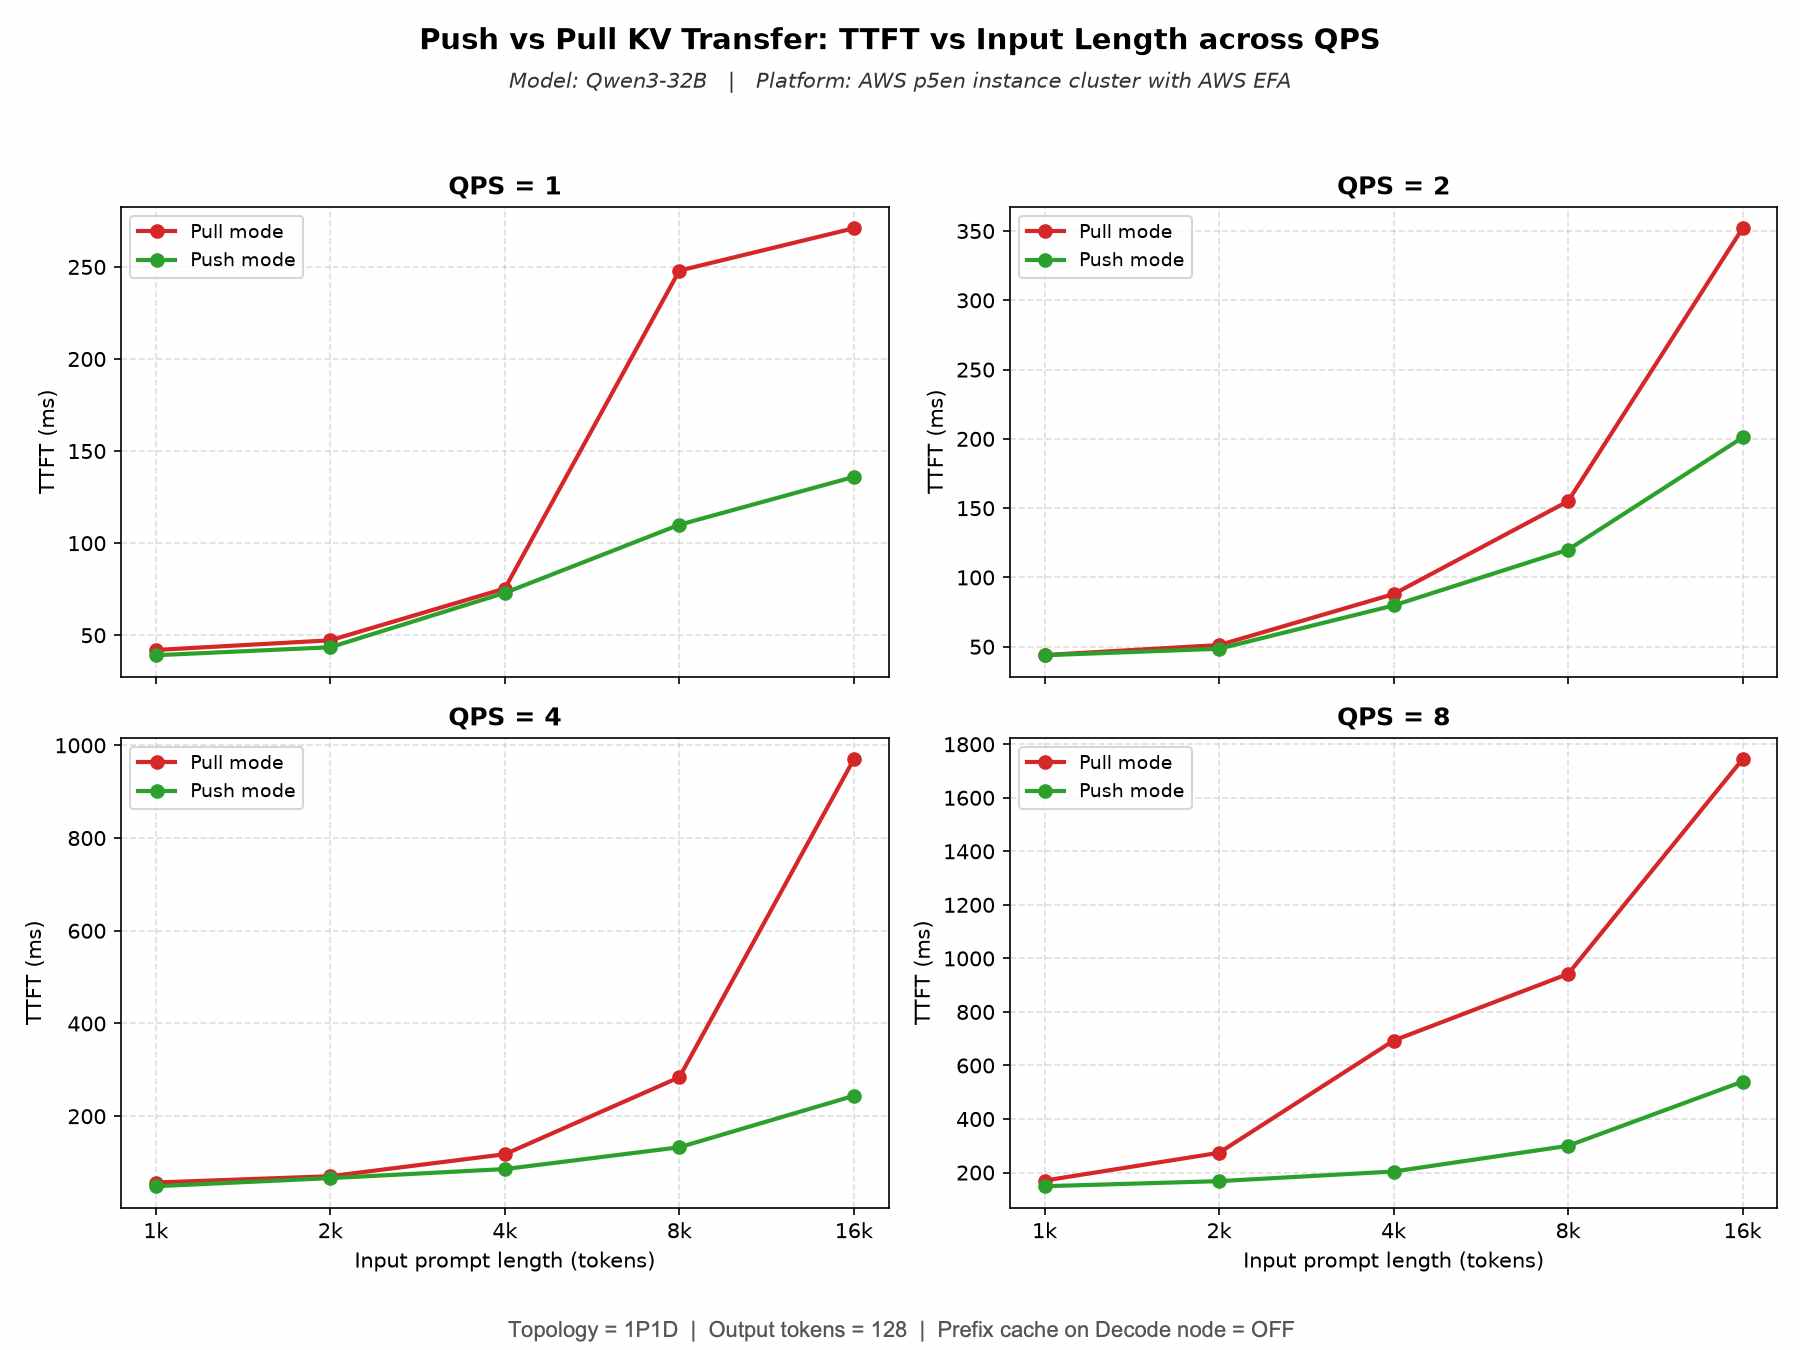
Biểu đồ gồm bốn ô so sánh TTFT giữa cơ chế truyền KV kiểu đẩy và kiểu kéo khi chạy mô hình Qwen3-32B trên các máy Amazon EC2 P5en kết nối qua EFA. Cấu hình thử nghiệm: mô hình 1P1D, 128 token đầu ra và tắt chức năng lưu đệm tiền tố trên máy sinh token.
Biểu đồ này thể hiện TPOT trong cùng điều kiện thử nghiệm. Xu hướng tương tự như với TTFT. Khi tải nhẹ, hai cơ chế có hiệu năng gần nhau, khoảng 5,6 đến 5,8 ms. Khi tải và độ dài đầu vào tăng, TPOT của cơ chế kéo tăng lên khoảng 10,4 ms ở mức 4 đến 8 QPS với đầu vào 16.000 token, trong khi cơ chế đẩy duy trì ở mức gần 7 ms.
Nguyên nhân là cơ chế đẩy chuyển công việc chuẩn bị bộ mô tả dữ liệu và gửi yêu cầu truyền sang luồng chạy nền, thay vì để máy sinh token tự xử lý. Nhờ vậy, quá trình tạo token không bị thiếu thời gian xử lý do phải chờ các công việc truyền dữ liệu. Độ trễ của từng token vì thế duy trì ổn định ngay cả khi có nhiều yêu cầu đồng thời và ngữ cảnh đầu vào dài.
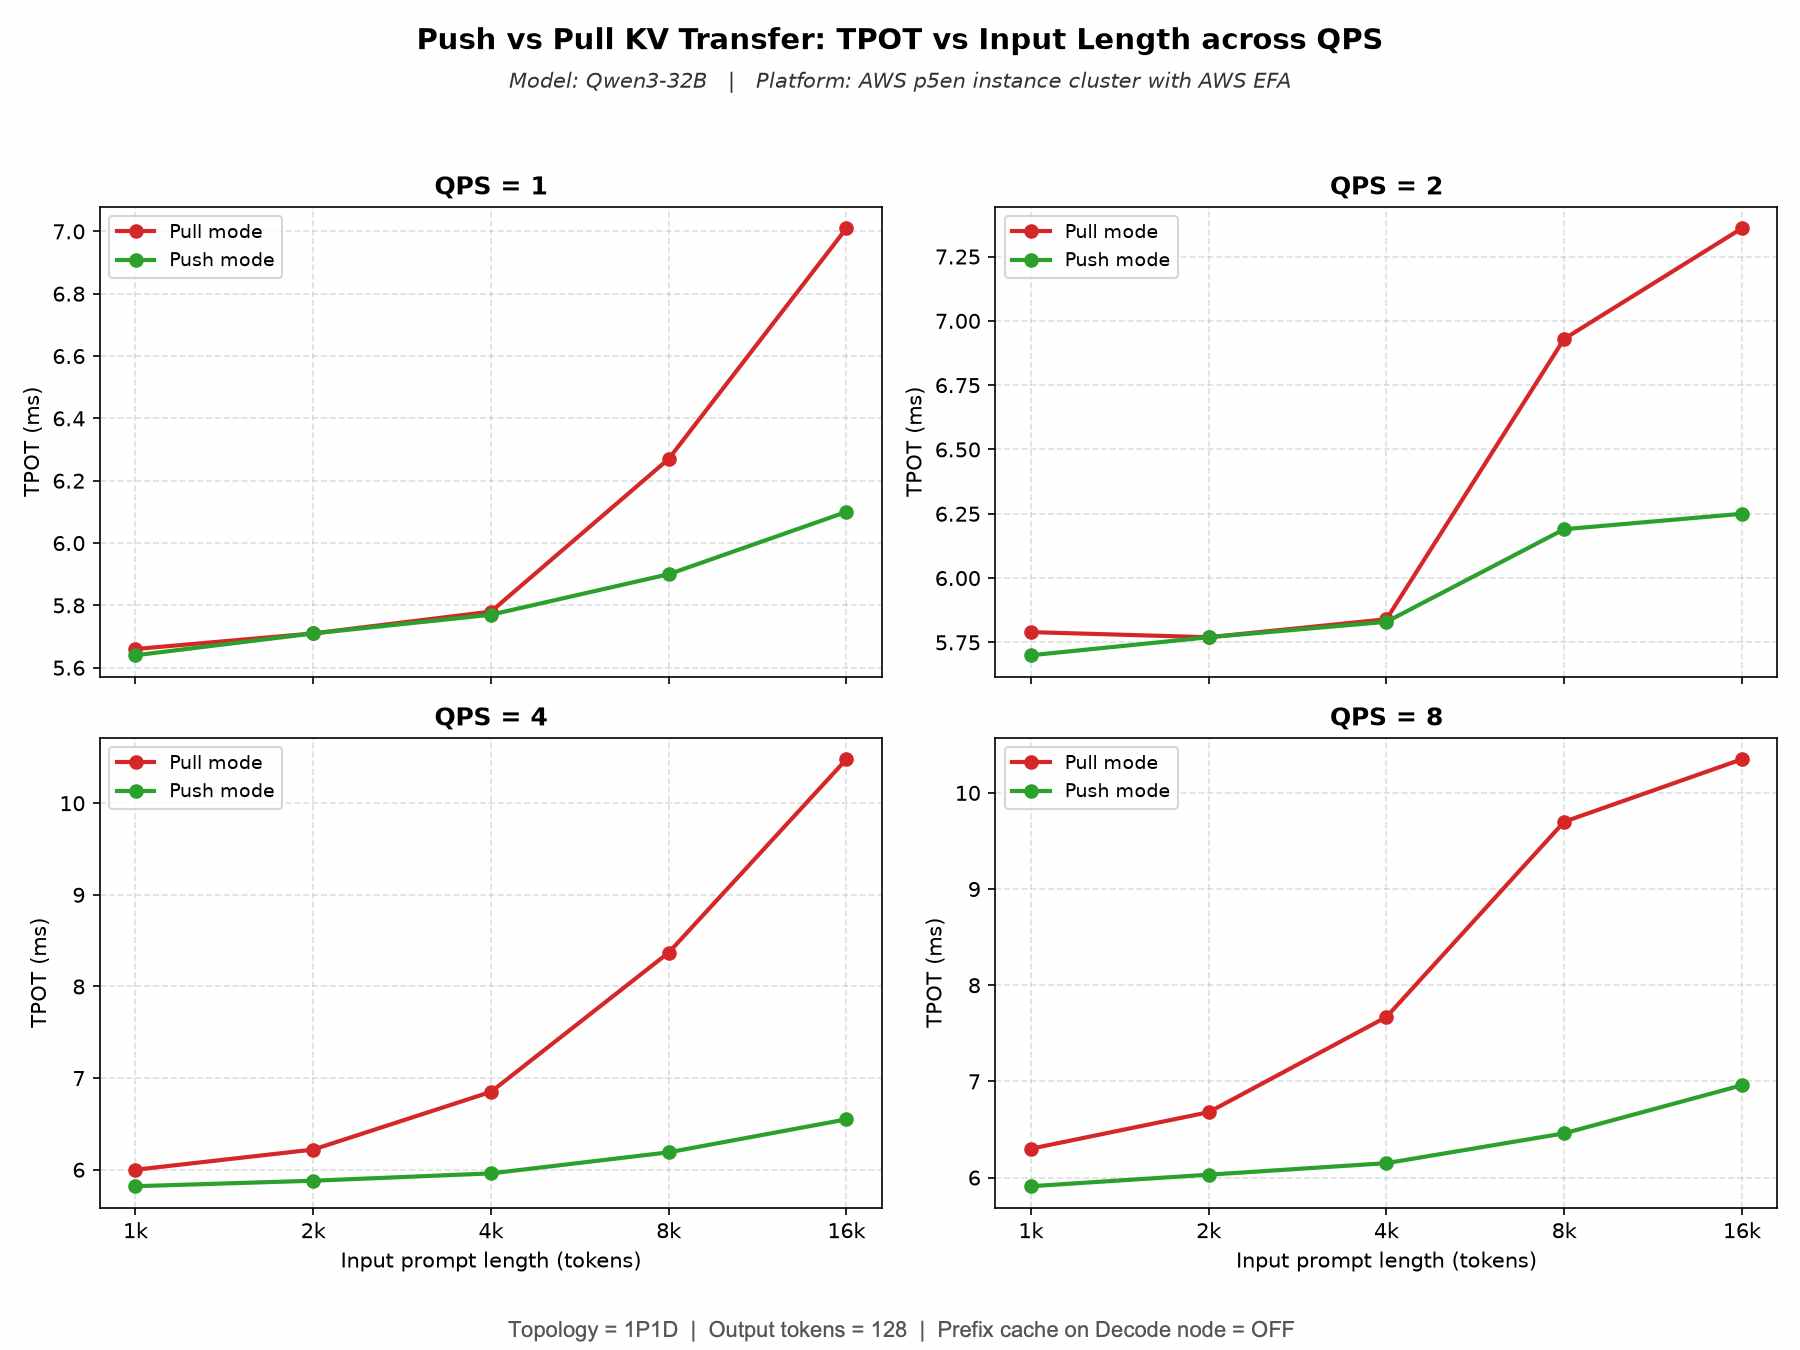
Biểu đồ gồm bốn ô so sánh TPOT giữa cơ chế truyền KV kiểu đẩy và kiểu kéo khi chạy mô hình Qwen3-32B trên các máy Amazon EC2 P5en kết nối qua EFA. Cấu hình thử nghiệm: mô hình 1P1D, 128 token đầu ra và tắt chức năng lưu đệm tiền tố trên máy sinh token.
Cách chạy thử nghiệm hiệu năng
Để tái tạo cấu hình thử nghiệm 1P1D gồm một máy tiền xử lý và một máy sinh token, sử dụng các máy Amazon EC2 P5en kết nối qua EFA, hãy tham khảo hướng dẫn chi tiết Tái tạo kết quả thử nghiệm.
Hướng dẫn này trình bày cách thiết lập môi trường, khởi chạy máy chủ vLLM cho hai giai đoạn tiền xử lý và sinh token, chạy thử nghiệm hiệu năng và thu thập kết quả. Tính năng này cũng có thể hoạt động trên các cấu hình khác được hỗ trợ, nhưng hiệu năng sẽ thay đổi tùy theo phần cứng, mô hình, khối lượng công việc và cấu hình mạng.
Kết luận
Trong bài viết này, đội ngũ đã trình bày cách bộ kết nối KV kiểu đẩy cho phép quá trình tính toán tiền xử lý diễn ra song song với việc cấp phát và đăng ký các khối bộ nhớ ở máy sinh token. Nhờ đó, cơ chế này loại bỏ lượt trao đổi thông tin qua bộ định tuyến sau khi tiền xử lý hoàn tất, đồng thời đưa công đoạn chuẩn bị truyền dữ liệu ở máy sinh token ra khỏi đường xử lý quyết định độ trễ.
Cách tiếp cận này giúp giảm TTFT và TPOT, đặc biệt khi tốc độ tiếp nhận yêu cầu cao. Trong thử nghiệm với mô hình Qwen3-32B trên hệ thống 1P1D sử dụng các máy Amazon EC2 P5en kết nối qua EFA, chế độ đẩy cải thiện TTFT tới 3 lần và giảm TPOT tới 30% so với chế độ kéo. Kết quả thực tế có thể khác nhau tùy theo khối lượng công việc và cấu hình hệ thống.
Để sử dụng chế độ đẩy, hãy cấu hình cả máy chủ tiền xử lý và máy chủ sinh token dùng NixlPushConnector thay cho NixlConnector.
Nên chọn bộ kết nối kiểu đẩy khi có thể xác định máy sinh token từ sớm và ưu tiên giảm TTFT. Bộ kết nối kiểu kéo vẫn phù hợp hơn với các khối lượng công việc cần truyền KV theo cả hai chiều hoặc cần chờ tiền xử lý hoàn tất mới chọn máy sinh token để định tuyến theo tải. vLLM hỗ trợ cả hai phương thức truyền KV kiểu đẩy và kiểu kéo, cho phép người dùng chọn cách phù hợp nhất với hệ thống triển khai của mình.
Trong thời gian tới, đội ngũ đang nghiên cứu áp dụng mô hình luồng chạy nền của NIXL cho bộ kết nối kiểu kéo. Mục tiêu là chuyển công đoạn thiết lập NIXL ra khỏi đường xử lý quyết định độ trễ, để các hệ thống dùng chế độ kéo cũng có thể hưởng lợi từ những tối ưu tương tự. Một yêu cầu đóng góp mã nguồn đã được mở để nghiên cứu hướng cải tiến này: #45211.
Phụ lục: Tái tạo kết quả thử nghiệm
Cấu hình thử nghiệm gồm hai máy GPU p5en có bật EFA. Máy tiền xử lý chạy tại cổng :8100, máy sinh token chạy tại cổng :8200. Ngoài ra, một máy thứ ba có cấu hình nhỏ hơn đảm nhiệm việc chạy máy chủ trung gian và chương trình gửi yêu cầu thử nghiệm.
Bài viết cung cấp ba tập lệnh:
-
-
-
serve_pd.sh: khởi chạy một trong hai máy xử lý theo chế độ đẩy hoặc kéo.run_sweep.sh: chạy thử nghiệm với các mức cấu hình khác nhau.cleanup.sh: dừng các tiến trình và dọn dẹp toàn bộ môi trường thử nghiệm.
-
-
Tập lệnh plot_push_vs_pull.py dùng để vẽ lại hai biểu đồ ở trên từ các tệp kết quả JSON.
Môi trường thử nghiệm
Hai máy GPU được cấu hình giống nhau:
| Hạng mục | Cấu hình |
| Loại máy | p5en.48xlarge, trang bị 8 GPU NVIDIA H200. Một máy chạy tiền xử lý, máy còn lại chạy sinh token. |
| Khu vực và vùng sẵn sàng | ap-south-1 (Mumbai), ap-south-1b (mã vùng sẵn sàng aps1-az3). Cả hai máy đều nằm trong cùng một vùng sẵn sàng. |
| Bố trí máy | Không sử dụng nhóm bố trí cụm. Cả hai máy được khởi chạy trong một vùng dành riêng dung lượng theo hình thức On-Demand có chỉ định mục tiêu, với chế độ thuê máy mặc định. |
| Ảnh máy ảo (AMI) | Máy Ubuntu 24.04 x86_64 công khai của AWS ParallelCluster 3.14.2: aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713. Mã AMI tại ap-south-1 là ami-0133f195033a4baae; mã AMI sẽ khác tùy khu vực. Máy này đi kèm nhân hệ điều hành 6.14.0-1018-aws, trình điều khiển NVIDIA 570 và CUDA 12.8. Vì vậy, cần nâng cấp trình điều khiển, bộ công cụ CUDA và trình cài đặt EFA lên các phiên bản nêu bên dưới. |
| Hệ điều hành và nhân hệ điều hành | Ubuntu 24.04.4 LTS, nhân 6.14.0-1018-aws. |
| Trình điều khiển NVIDIA và CUDA | Trình điều khiển 580.126.16 (API trình điều khiển CUDA 13.0); bộ công cụ CUDA 13.0. |
| Giao diện EFA | Mỗi máy có 16 giao diện mạng, mỗi giao diện tương ứng với một card mạng (card 0 đến 15), tất cả đều thuộc loại efa. Mỗi giao diện đạt 200 Gb/s, tổng băng thông là 3,2 Tb/s. Mỗi nút NUMA có 8 giao diện, và mỗi GPU dùng chung một bộ chuyển mạch PCIe với 2 giao diện trong số đó. |
| Phần mềm EFA | Trình cài đặt EFA 1.50.0, mô-đun nhân EFA 3.3.0g, libfabric 2.6.0amzn1.0 và rdma-core 64.0amzn0. |
Cách NIXL chọn thiết bị EFA
Phần phụ trợ LIBFABRIC mở cả 16 thiết bị EFA thành các đường truyền song song thông qua trình cung cấp efa. Sau đó, nó chỉ đăng ký bộ nhớ đệm KV của mỗi GPU trên 2 đường truyền dùng chung bộ chuyển mạch PCIe với GPU đó. Nhờ vậy, toàn bộ dữ liệu truyền đi đều nằm trong phạm vi kết nối PCIe cục bộ.
Không thiết lập tùy chọn ghi đè thiết bị cho NIXL hoặc libfabric. Hệ thống sử dụng cách lựa chọn mặc định.
Để kiểm tra cấu hình tương tự trên máy của bạn, hãy khởi chạy máy chủ với biến môi trường NIXL_LOG_LEVEL=DEBUG, sau đó kiểm tra các dòng nhật ký đăng ký thiết bị.
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Cấp phát và chuẩn bị các máy
Cài đặt bộ phần mềm EFA phía người dùng trên cả hai máy GPU, sau đó xác nhận trình cung cấp EFA đã có mặt. Trong thử nghiệm này, đội ngũ sử dụng trình cài đặt phiên bản 1.50.0:
curl -0 https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
Hai máy GPU phải có thể kết nối với nhau qua các cổng 8100, 8200 và cổng kênh phụ của NIXL (5600).
2. Cài đặt vLLM và NIXL
Thực hiện trên cả hai máy GPU:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
Trên máy chủ trung gian, không cần cài đặt môi trường chạy GPU:
pip install vllm aiohttp fastapi uvicorn pandas datasets3. Tải mô hình
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. Khởi chạy cặp máy tiền xử lý và sinh token
Chạy tập lệnh serve_pd.sh một lần trên mỗi máy GPU. Điểm khác biệt duy nhất giữa hai chế độ là tham số kv_connector: dùng NixlConnector cho cơ chế kéo và NixlPushConnector cho cơ chế đẩy.
Các cổng, mã định danh bộ máy, vai trò và thứ hạng xử lý đều được giữ nguyên.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
Ở phía tiền xử lý, cấu hình sẽ được mở rộng thành:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen -dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
Máy chủ sinh token bổ sung tham số --no-enable-prefix-caching để buộc mỗi yêu cầu phải lấy toàn bộ KV từ máy tiền xử lý. Đây chính là hoạt động mà chúng ta cần đo lường.
Nếu bật chức năng lưu đệm, các lời nhắc có nội dung trùng lặp có thể sử dụng bộ nhớ đệm cục bộ trên máy sinh token và bỏ qua bước truyền dữ liệu từ tiền xử lý sang sinh token. Điều này sẽ khiến kết quả đo không chính xác.
Trước khi chạy thử nghiệm hiệu năng, hãy chờ đến khi cả hai điểm cuối /health đều trả về mã trạng thái 200.
5. Chạy thử nghiệm với nhiều mức cấu hình
Tập lệnh thử nghiệm hiệu năng được cung cấp trong yêu cầu đóng góp mã nguồn #57567. Tập lệnh sẽ chọn chương trình trung gian phù hợp với chế độ đang dùng: disagg_proxy_demo.py cho cơ chế kéo và disagg_proxy_pushconnector_demo.py cho cơ chế đẩy. Sau đó, chương trình chạy thử nghiệm thông qua lệnh vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
Tiếp theo, dừng cả hai máy chủ, khởi chạy lại theo bước 4 với MODE=push trên mỗi máy rồi chạy lại thử nghiệm với MODE=push.
Chế độ đẩy còn cần thông tin kết nối NIXL của máy tiền xử lý để chương trình trung gian có thể thông báo cho máy sinh token biết nơi đăng ký bộ nhớ đích. Các biến cần thiết gồm:
PREFILL_ENGINE_IDPREFILL_KV_HOSTPREFILL_SIDE_CHANNEL_PORTPREFILL_TP_SIZEPREFILL_PP_SIZE
Tập lệnh run_sweep.sh tự điền các giá trị này theo cấu hình mặc định đã nêu ở trên.
Hãy giữ nguyên các danh sách QPS_LIST, INPUT_LENS và OUTPUT_LENS giữa hai lần chạy để bảo đảm kết quả có thể so sánh trực tiếp. Đồng thời, cần xác nhận PREFILL_TP_SIZE khớp với kích thước song song tensor thực tế của máy chủ tiền xử lý.
Thư mục result/ chứa các tệp có tên theo mẫu <mode>_qps<q>_in<in>_out<out>_iter<i>.json cùng các tệp nhật ký .log. Những tệp này lưu số liệu TTFT, ITL, thông lượng và độ trễ đầu cuối của từng lần chạy.
Để vẽ lại các biểu đồ:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
Khắc phục sự cố
-
-
-
- Máy chủ bị dừng ngay sau yêu cầu đầu tiên: Chế độ chạy không khớp với bộ kết nối. Cơ chế kéo cần
NixlConnector, còn cơ chế đẩy cầnNixlPushConnector. Cả máy tiền xử lý và máy sinh token đều phải sử dụng đúng bộ kết nối. - Lỗi
Backend 404: model ... does not exist: Giá trịSERVED_MODEL_NAMEkhông khớp với tham số--served-model-nametrên máy chủ. Trong cấu hình thử nghiệm này, tên mô hình được cung cấp làQwen. - Chờ chương trình trung gian sẵn sàng quá thời hạn: Kiểm tra xem chương trình trung gian dành cho chế độ đang sử dụng có tồn tại trong thư mục
$VLLM_SRC/examples/disaggregated/disaggregated_serving/hay không. Đồng thời, xác nhận cả hai điểm cuối/healthcủa máy tiền xử lý và máy sinh token đều trả về mã trạng thái 200. - Lỗi bắt tay hoặc truyền dữ liệu NIXL: Kiểm tra EFA bằng lệnh
fi_info -p efa, xác nhận cổng kênh phụ (5600) được mở giữa hai máy và bảo đảmPREFILL_TP_SIZEkhớp với kích thước song song tensor của máy chủ tiền xử lý.
- Máy chủ bị dừng ngay sau yêu cầu đầu tiên: Chế độ chạy không khớp với bộ kết nối. Cơ chế kéo cần
-
-
Dọn dẹp môi trường
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Sau khi hoàn tất thử nghiệm, hãy làm theo hướng dẫn sử dụng AWS EC2 để chấm dứt các phiên máy đã khởi chạy.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI tính phí theo từng phút sử dụng, minh bạch và không có phí ẩn. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.