Hỗ trợ Muse Spark Open ngay từ ngày đầu trên vLLM
Đội ngũ vLLM đã hợp tác với Meta Superintelligence Labs để đưa Muse Spark Open lên vLLM ngay từ ngày đầu ra mắt. Muse Spark Open là mô hình hỗn hợp chuyên gia thưa (MoE) có trọng số mở, được xây dựng để xử lý các quy trình lập trình bằng tác nhân kéo dài qua nhiều bước. Đây là mô hình có trọng số mở mạnh nhất của Hoa Kỳ tính đến nay, đồng thời cũng là mô hình gốc được dùng để chưng cất Muse Glimmer 30B.
Điểm nổi bật
-
-
-
- Kiến trúc: Tổng cộng 816 tỷ tham số, trong đó 42 tỷ tham số được kích hoạt cho mỗi token. Cửa sổ ngữ cảnh hỗ trợ tới 1 triệu token.
- Lượng tử hóa: Meta phát hành mô hình ở hai định dạng BF16 và NVFP4. AMD phát hành thêm phiên bản có trọng số MXFP4.
- Đa phương thức: Có khả năng nhận biết hình ảnh và video nguyên bản thông qua Perception Encoder, giống Muse Glimmer; đồng thời hỗ trợ thêm âm thanh.
- Xử lý song song: Hỗ trợ song song tensor và song song đường ống trên cả NVIDIA lẫn AMD. Trên NVIDIA, mô hình còn hỗ trợ EP, TEP, DEP và tách riêng khâu nạp đầu vào với giải mã. Hỗ trợ ban đầu trên TPU cũng đã có.
- Giải mã suy đoán: Đội ngũ vLLM đã huấn luyện mô hình dự đoán DSpark. Mô hình này hỗ trợ cả CUDA lẫn ROCm, giúp tăng tốc suy luận và đã được kiểm thử bằng bộ đo hiệu năng SPEED.
-
-
Cách sử dụng
Các bản dựng đóng gói sẵn đã có cho cả hai nền tảng:
-
-
-
- NVIDIA: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
-
-
Lưu ý: Mô hình chỉ có trong các gói PyPI dựng hằng đêm sau khi phần mã nguồn (PR #61879) được xem xét và hợp nhất. Quá trình này thường mất khoảng một tuần.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
Để sử dụng mô hình với văn bản thuần:
curl http://localhost:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
    "messages": [{"role": "user", "content": "Refactor this module."}],
    "reasoning_effort": "xhigh"
  }'
Để xử lý dữ liệu đa phương thức:
curl http://localhost:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-models/Muse-Spark-Open-816B-A42B",
    "messages": [{"role": "user", "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
      {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
      {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
      {"type": "text",      "text": "What is happening here, and when?"}
    ]}]
  }'
Chi tiết triển khai
Kiến trúc mô hình
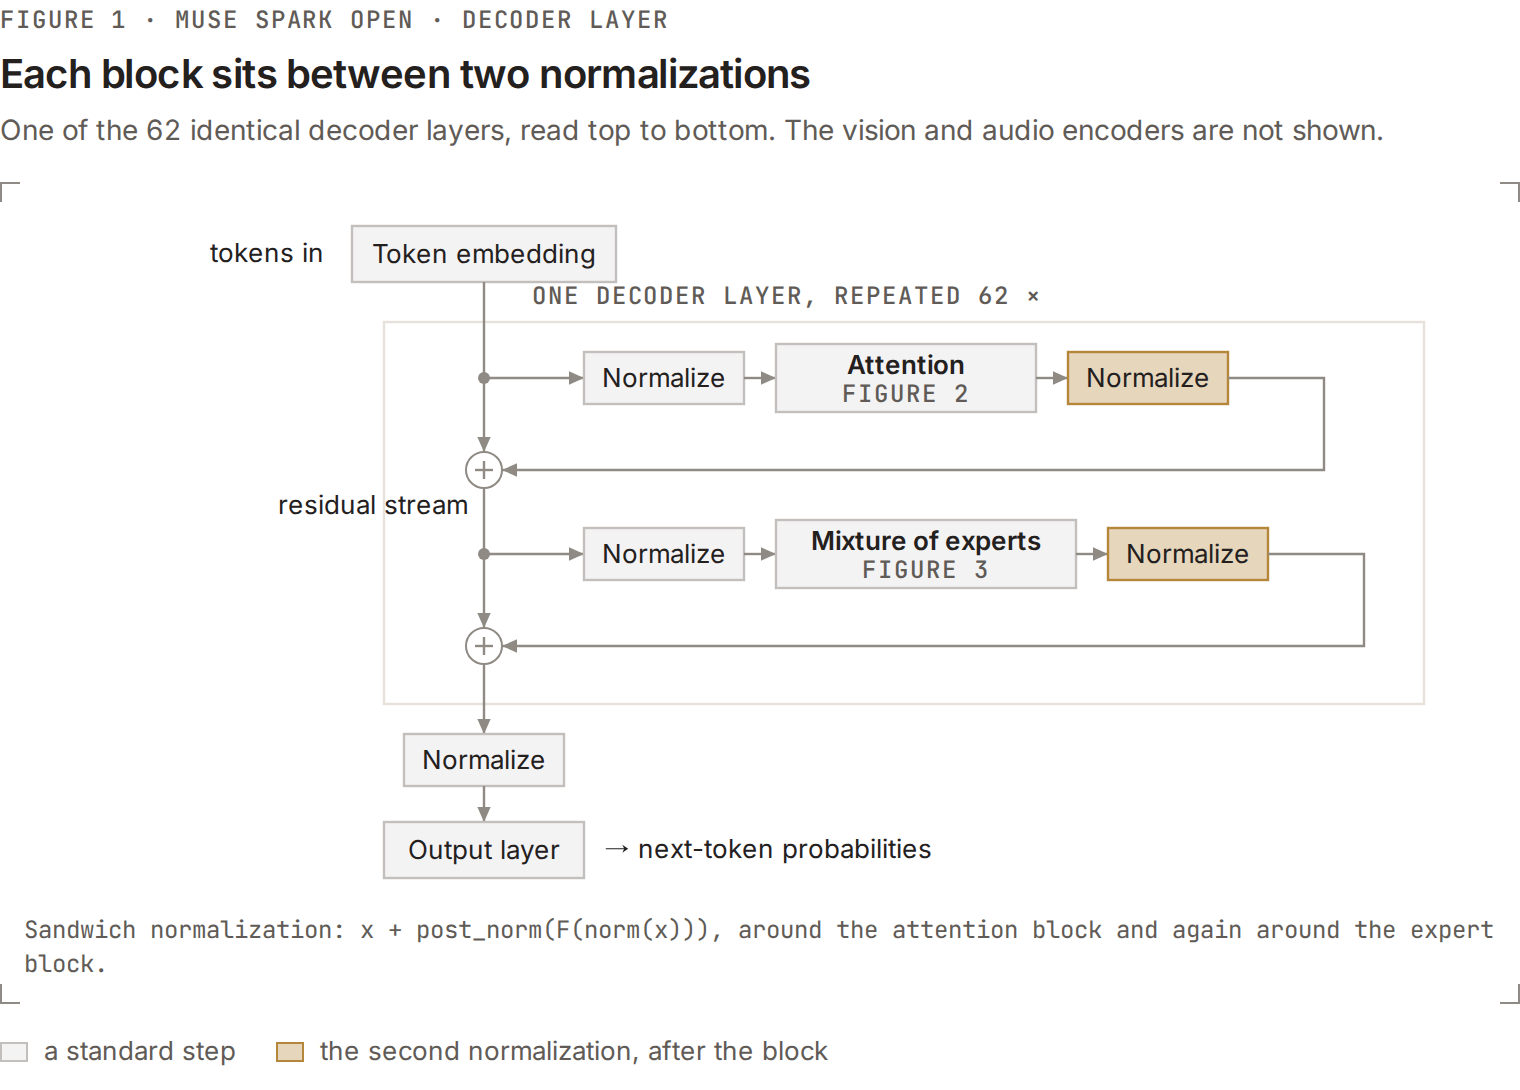
Muse Spark Open là mô hình hỗn hợp chuyên gia có tổng cộng 816 tỷ tham số dành cho bộ giải mã văn bản, bên cạnh bộ mã hóa thị giác 2 tỷ tham số và một bộ mã hóa âm thanh nhỏ. Bộ giải mã có 62 lớp, và cả 62 lớp đều là lớp hỗn hợp chuyên gia.
Phân bố tham số như sau:
| Thành phần | Số tham số |
| 256 chuyên gia trong mỗi lớp | 799 tỷ |
| Cơ chế chú ý | 13,5 tỷ |
| Các phép chiếu ẩn của MoE | 4,2 tỷ |
| Lớp nhúng và lớp đầu ra | 3,3 tỷ |
| Bộ phận xử lý thị giác riêng biệt | 1,9 tỷ |
Kiến trúc của mô hình có nhiều điểm tương đồng với Muse Glimmer. Với những ai chưa từng sử dụng Muse Glimmer, dưới đây là một số điểm đáng chú ý trong thiết kế của Muse Spark Open.
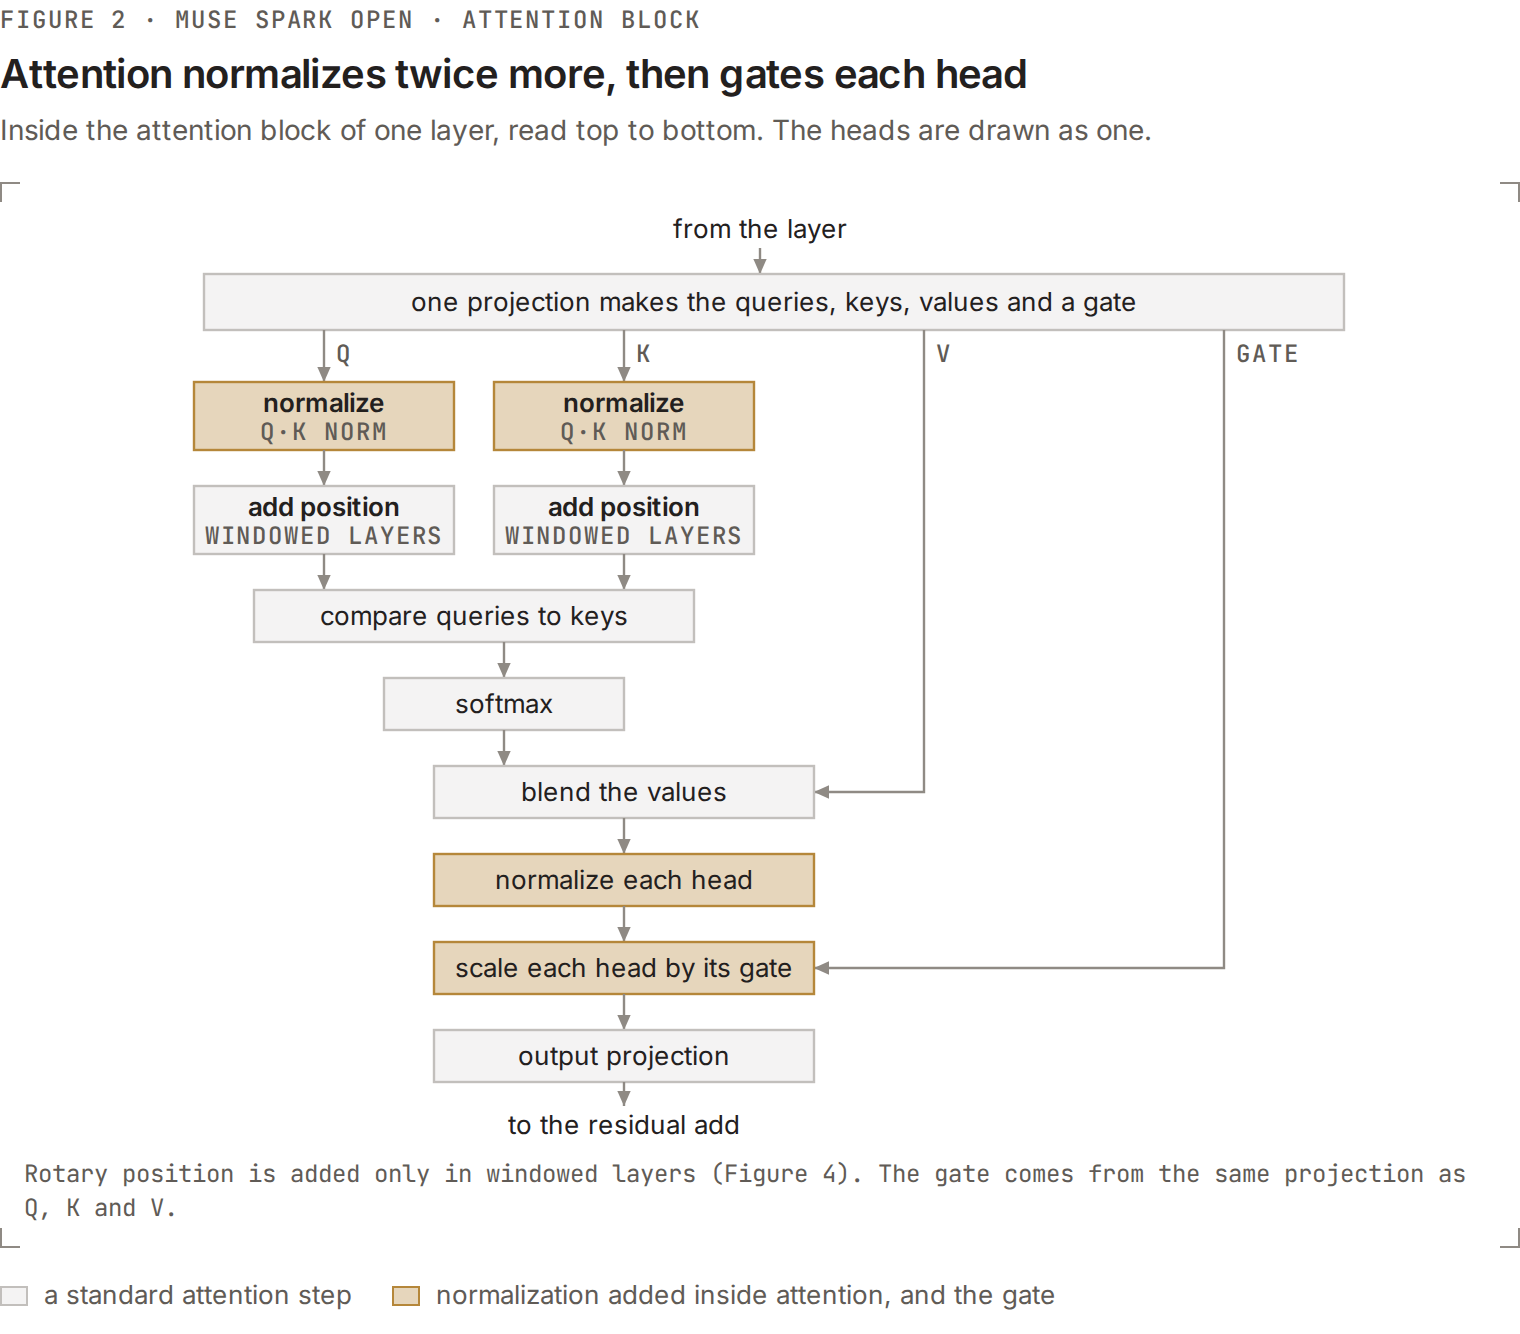
Chuẩn hóa kiểu bánh kẹp. Phần lớn bộ giải mã đặt một lớp chuẩn hóa trước mỗi khối, tạo thành biểu thức x + F(norm(x)). Muse Spark Open, tương tự Muse Glimmer, đặt một lớp chuẩn hóa ở cả trước lẫn sau khối. Có thể hình dung khối nằm giữa hai lớp chuẩn hóa như phần nhân kẹp giữa hai lát bánh mì. Khi đó, biểu thức trở thành x + post_norm(F(norm(x))).
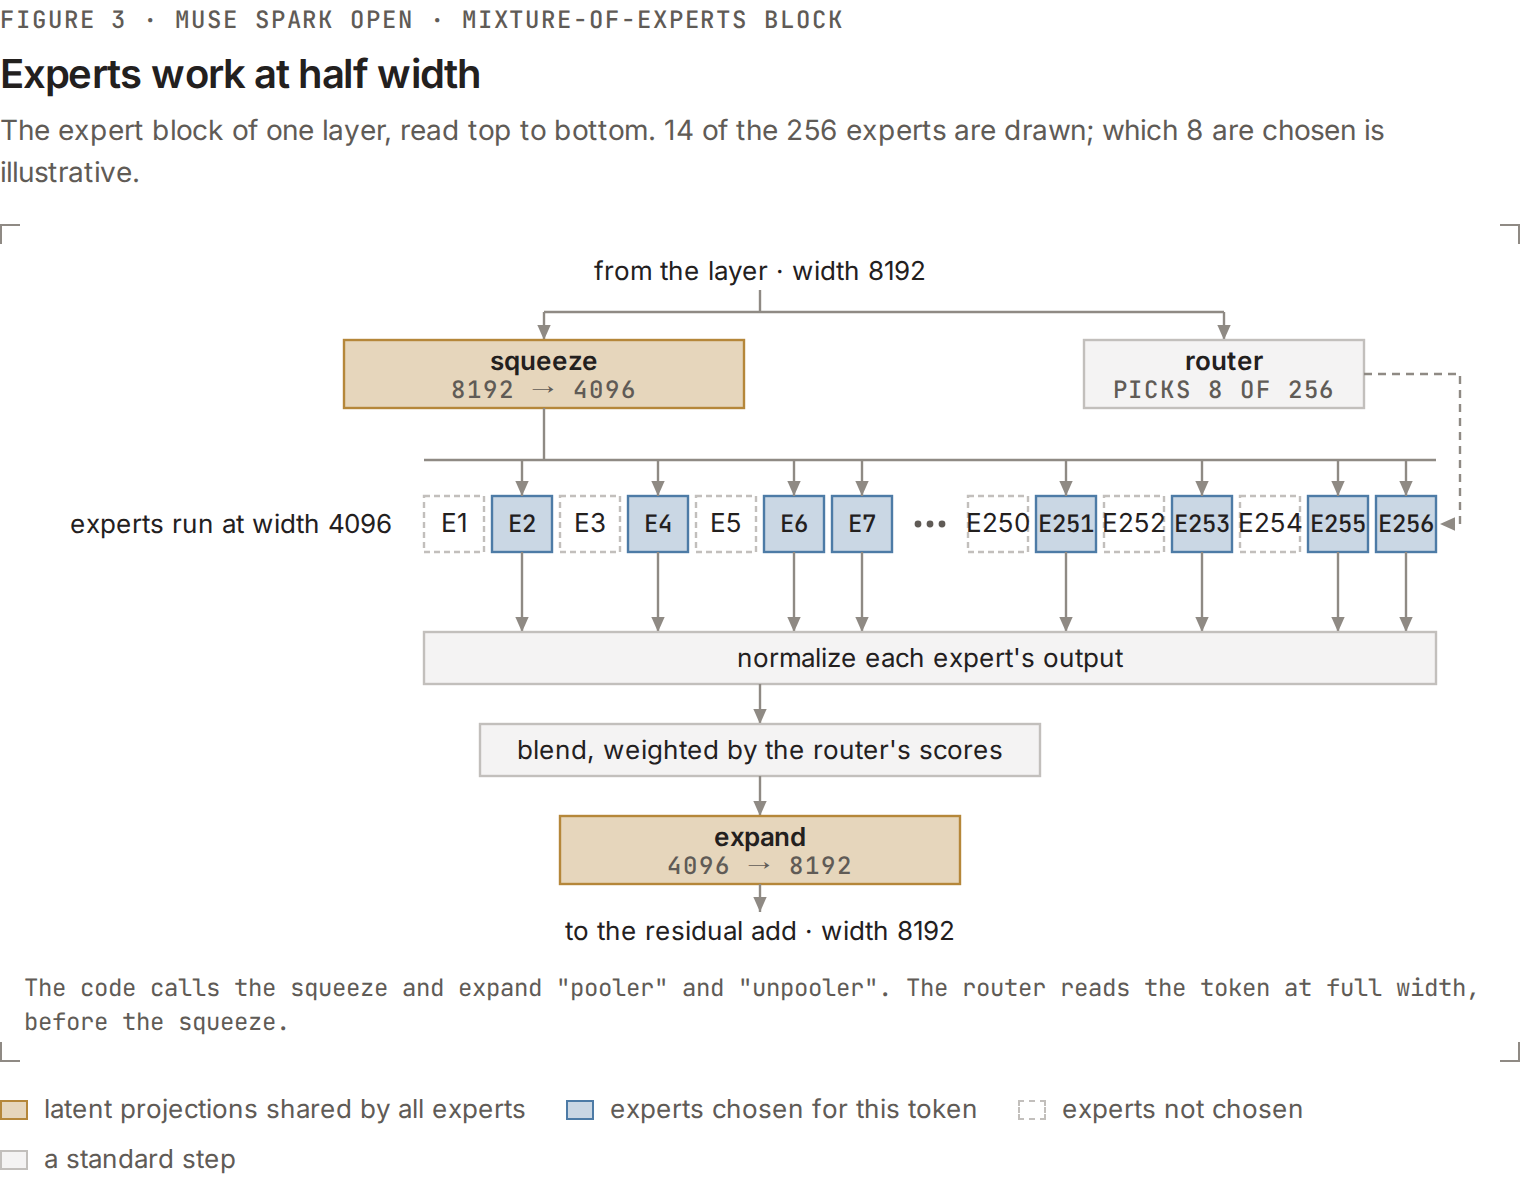
MoE ẩn. Mỗi lớp hỗn hợp chuyên gia (MoE) có thêm hai ma trận dùng chung cho cả 256 chuyên gia trong lớp. Mã nguồn gọi chúng là pooler và unpooler. Tuy nhiên, chúng không thực hiện thao tác gom dữ liệu theo nghĩa thông thường, mà là hai phép chiếu được học để thu hẹp rồi khôi phục số chiều của dữ liệu.
Ma trận pooler có kích thước 8192 × 4096, giúp giảm một nửa số chiều của mỗi token trước khi chuyển token đến các chuyên gia. Sau đó, unpooler khôi phục số chiều ban đầu. Nhờ vậy, các chuyên gia chỉ cần xử lý dữ liệu có 4096 chiều thay vì 8192 chiều, qua đó giảm gần một nửa số tham số cần thiết trong hai lớp chiếu của mỗi chuyên gia.
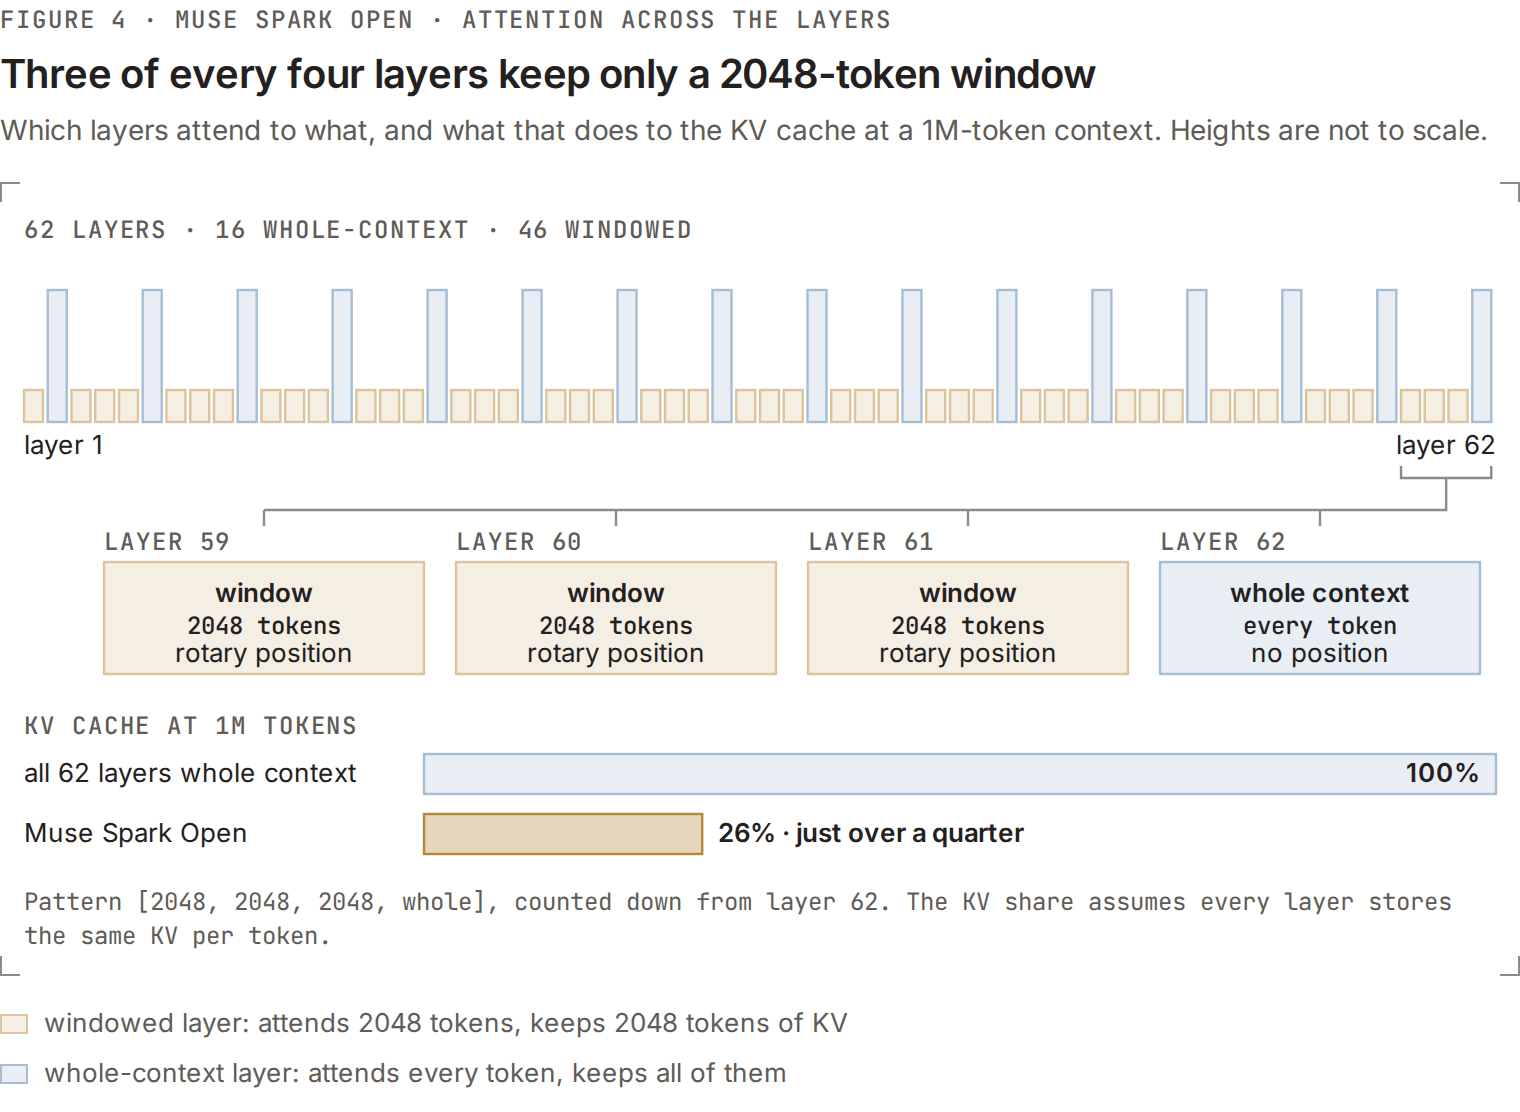
Cơ chế chú ý kết hợp. Các lớp lần lượt sử dụng cơ chế chú ý toàn phần và cơ chế chú ý cửa sổ trượt (SWA) theo chu kỳ bốn lớp. Trong đó, ba lớp chỉ chú ý đến cửa sổ gồm 2048 token, còn lớp thứ tư xem xét toàn bộ ngữ cảnh.
Chu kỳ này được căn chỉnh từ cuối mạng trở lên, bảo đảm lớp cuối cùng luôn sử dụng cơ chế chú ý toàn phần. Với 62 lớp, mô hình có 46 lớp dùng cửa sổ hẹp và 16 lớp dùng cửa sổ rộng. Các lớp cửa sổ hẹp chỉ cần lưu những dữ liệu KV gần đây.
Khi xử lý ngữ cảnh dài 1 triệu token, cách thiết kế này giúp dung lượng bộ nhớ đệm giảm xuống chỉ còn hơn một phần tư so với trường hợp tất cả các lớp đều dùng cơ chế chú ý toàn phần. Đây chính là yếu tố giúp mô hình hỗ trợ ngữ cảnh dài 1 triệu token với chi phí bộ nhớ hợp lý.
Bộ mã hóa thị giác. Muse Spark Open sử dụng cùng Perception Encoder với Muse Glimmer. Đây là một bộ phận gồm 2 tỷ tham số, có thể đọc hình ảnh ở độ phân giải gốc thay vì thu phóng ảnh thành hình vuông.
Video cũng được xử lý bằng bộ mã hóa này. Khi nạp dữ liệu, hệ thống lấy mẫu các khung hình video và đưa chúng vào chuỗi đầu vào, kèm theo dấu thời gian được chuyển thành token trong câu lệnh.
Bộ mã hóa âm thanh. Âm thanh được tiếp nhận dưới dạng sóng âm thô ở tần số lấy mẫu 24 kHz. Cứ mỗi 1920 mẫu, tương ứng 80 mili giây âm thanh, hệ thống tạo ra một token thông qua một chuỗi phép biến đổi. Toàn bộ bộ mã hóa âm thanh chỉ có 118 triệu tham số.
Lưu ý rằng phần âm thanh trong video không được xử lý tự động. Nếu muốn mô hình nhận biết cả hình ảnh lẫn âm thanh của một đoạn video, hãy gửi video và phần âm thanh đã tách riêng thành hai phần nội dung trong cùng một yêu cầu.
DSpark
Để tăng tốc suy luận Muse Spark Open trên vLLM, đội ngũ vLLM đã huấn luyện một mô hình dự đoán sử dụng DSpark – thuật toán giải mã suy đoán dùng khuếch tán theo khối để đề xuất tối đa bảy token dự đoán chỉ trong một lượt xử lý.
Cơ chế lập lịch dựa trên độ tin cậy giúp duy trì mức tăng tốc đáng kể ngay cả khi kích thước lô lớn. Đây vốn là trường hợp mà giải mã suy đoán thường đem lại lợi ích giảm dần, như thể hiện trong các kết quả dưới đây.
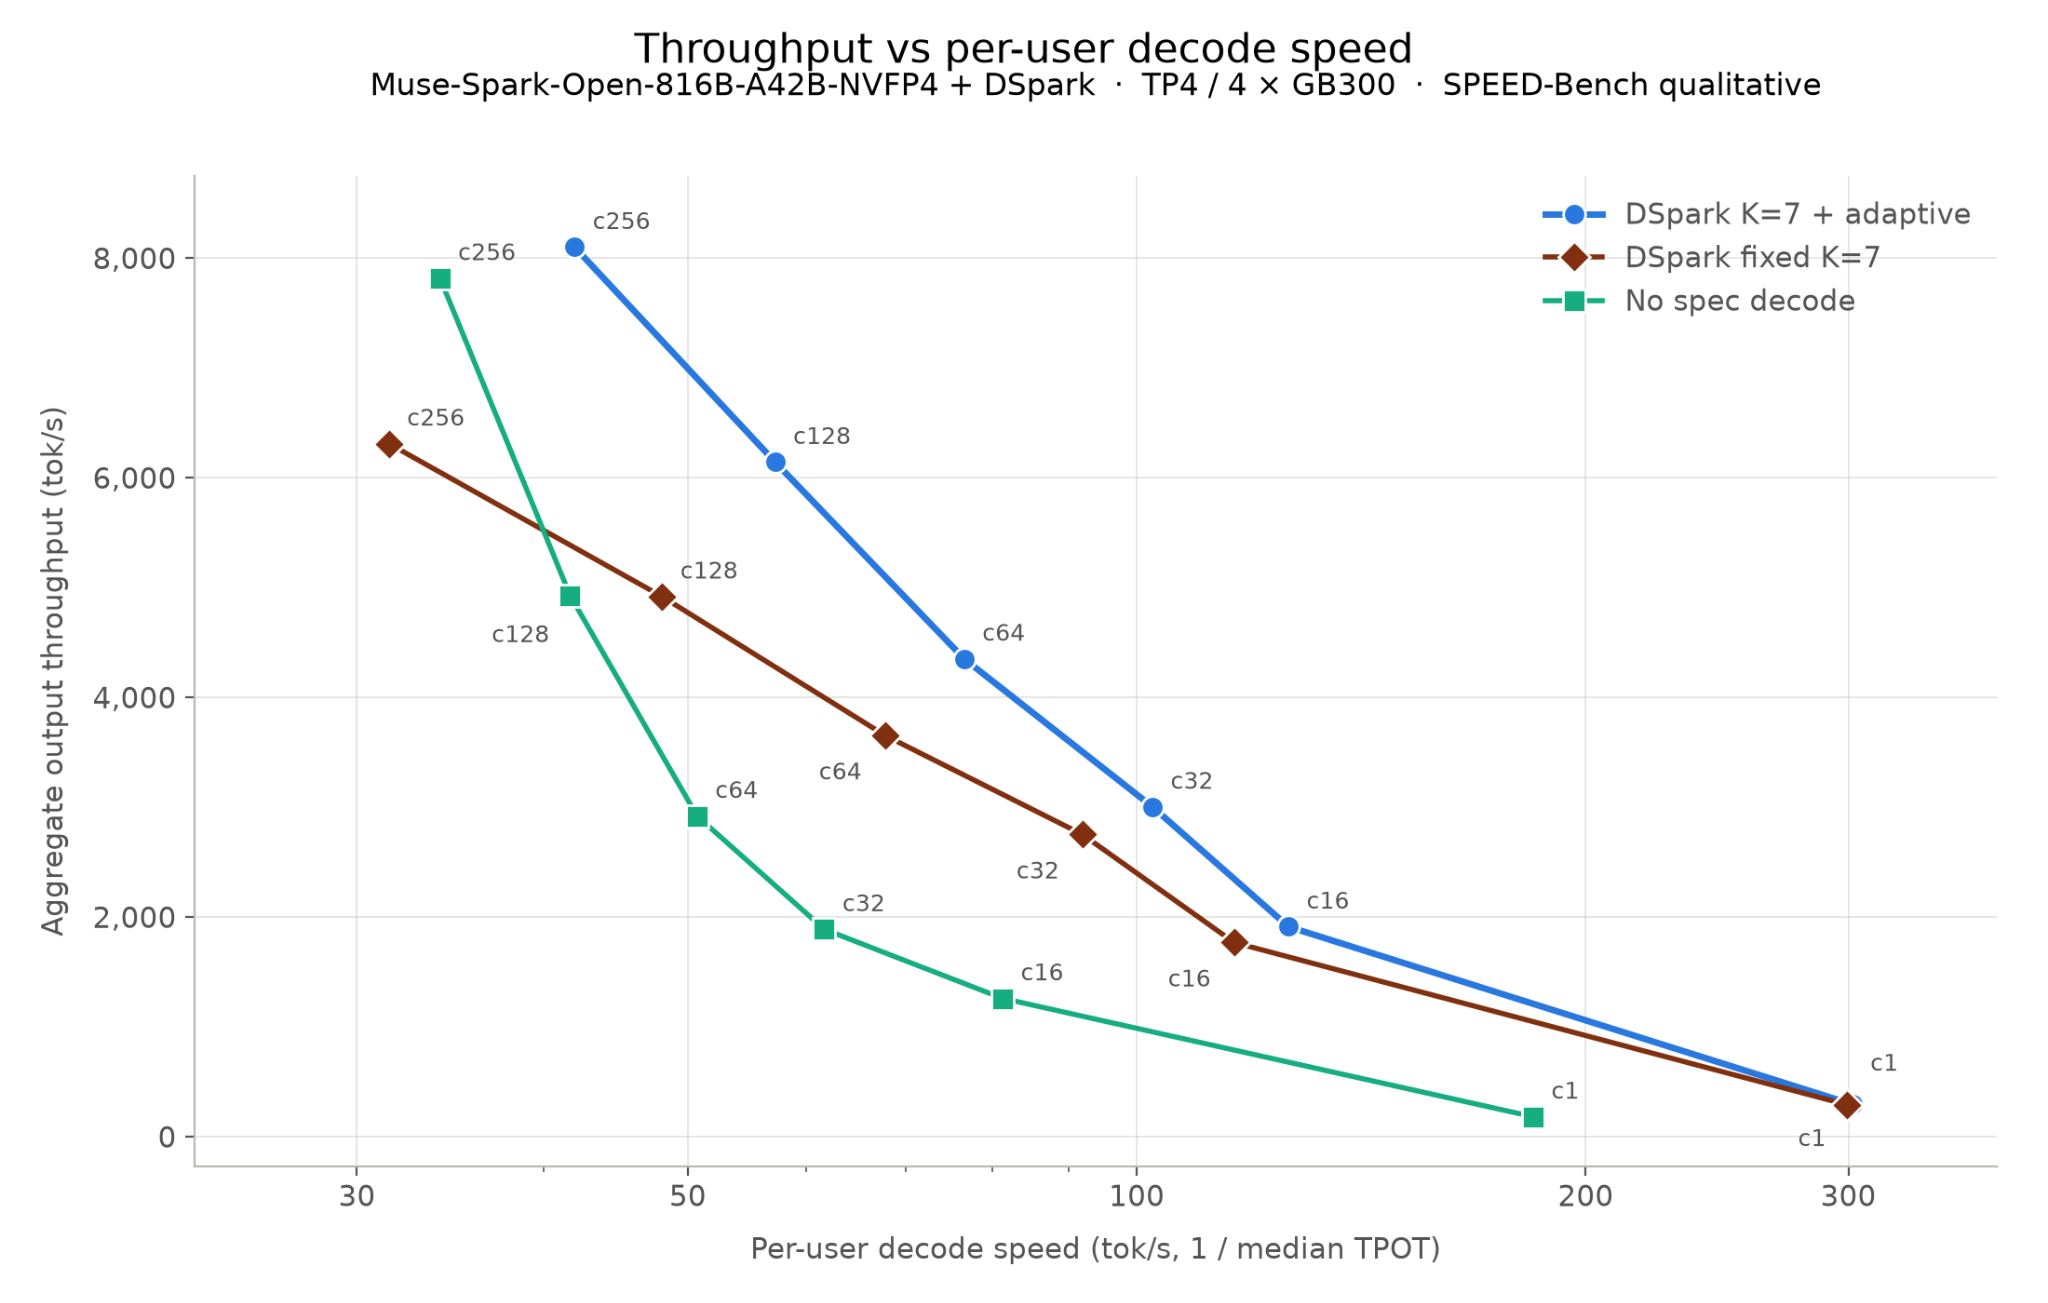
Mô hình dự đoán cũng tận dụng cơ chế chú ý cửa sổ trượt của Muse Spark Open để giảm chi phí dự đoán, ngay cả khi ngữ cảnh dài tới 1 triệu token. Sự kết hợp này giúp mô hình phù hợp với khối lượng công việc thực tế có nhiều kích thước lô và độ dài ngữ cảnh khác nhau.
Để bật tính năng này, hãy thêm tham số sau khi khởi động máy chủ:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'NVIDIA
Đội ngũ NVIDIA đã cải thiện tốc độ suy luận Muse Spark Open trên FlashInfer và vLLM thông qua nhiều thay đổi:
-
-
-
- Hợp nhất các phép tính chuẩn hóa, điều khiển bằng cổng và cộng phần dư vào cùng hạt nhân.
- Hợp nhất bước hoàn tất MoE với thao tác trao đổi dữ liệu giữa các GPU khi xử lý song song tensor và với RMSNorm.
- Xây dựng cách triển khai GEMM BF16 mới có độ trễ thấp, đồng thời giảm chi phí biên dịch.
- Chia nhỏ pooler và unpooler theo TEP, kết hợp với các phép tập hợp MNNVL đã được hợp nhất.
- Sử dụng GEMM TF32 cho bộ định tuyến, với đầu vào là kết quả FP32 từ phép chuẩn hóa.
- Cải thiện việc di chuyển dữ liệu, khả năng hỗ trợ phần cứng và độ tin cậy khi chạy mô hình.
-
-
AMD
Nhờ sự hỗ trợ của đội ngũ AMD, Muse Spark Open hiện cũng chạy được trên GPU AMD Instinct™ MI355X với cả hai định dạng lượng tử hóa FP8 và MXFP4. Những cải tiến này giúp tăng tốc suy luận và nâng cao hiệu quả triển khai.
Lưu ý rằng ROCm hiện hỗ trợ cả song song tensor lẫn song song đường ống.
TPU
Đội ngũ vLLM đã bổ sung khả năng chạy Muse Spark Open trên TPU dựa trên TorchTPU. Vui lòng liên hệ với vLLM hoặc Google để được cấp quyền truy cập mã nguồn.
Đội ngũ vLLM cũng đã xây dựng megakernels dành riêng cho Muse Spark Open. Khi sử dụng giải mã suy đoán DSpark với độ dài chuỗi được chấp nhận bằng 6, hệ thống đạt tốc độ hơn 650 token/giây trên 4 chip TPU v7 và hơn 960 token/giây trên 8 chip.
Ngay cả khi không dùng giải mã suy đoán, tốc độ vẫn vượt 270 token/giây trên 4 chip và 350 token/giây trên 8 chip.
Học tăng cường trên vLLM
Ngay từ ngày đầu, vLLM đã hỗ trợ huấn luyện tăng cường bằng LoRA cho Muse Spark Open. Trong cấu hình này, vLLM đóng vai trò bộ máy tạo mẫu lượt tương tác (rollout engine), còn Verl FSDP2 đảm nhiệm việc huấn luyện.
vLLM phục vụ mô hình từ điểm kiểm tra NVFP4 gốc, đồng thời áp dụng bộ điều chỉnh LoRA lên trên. Bộ phận huấn luyện sử dụng chính bộ trọng số đó sau khi giải lượng tử hóa sang BF16 và chỉ cập nhật bộ điều chỉnh LoRA với hạng 32, hệ số alpha bằng 64.
Bộ điều chỉnh này tác động đến cơ chế chú ý, các phép chiếu ẩn của MoE và toàn bộ chuyên gia được bộ định tuyến lựa chọn. Hệ thống cũng phát lại quá trình định tuyến MoE của lượt tạo mẫu theo cơ chế R3. Sau mỗi bước huấn luyện, chỉ các tham số của bộ điều chỉnh được đồng bộ trở lại vLLM.
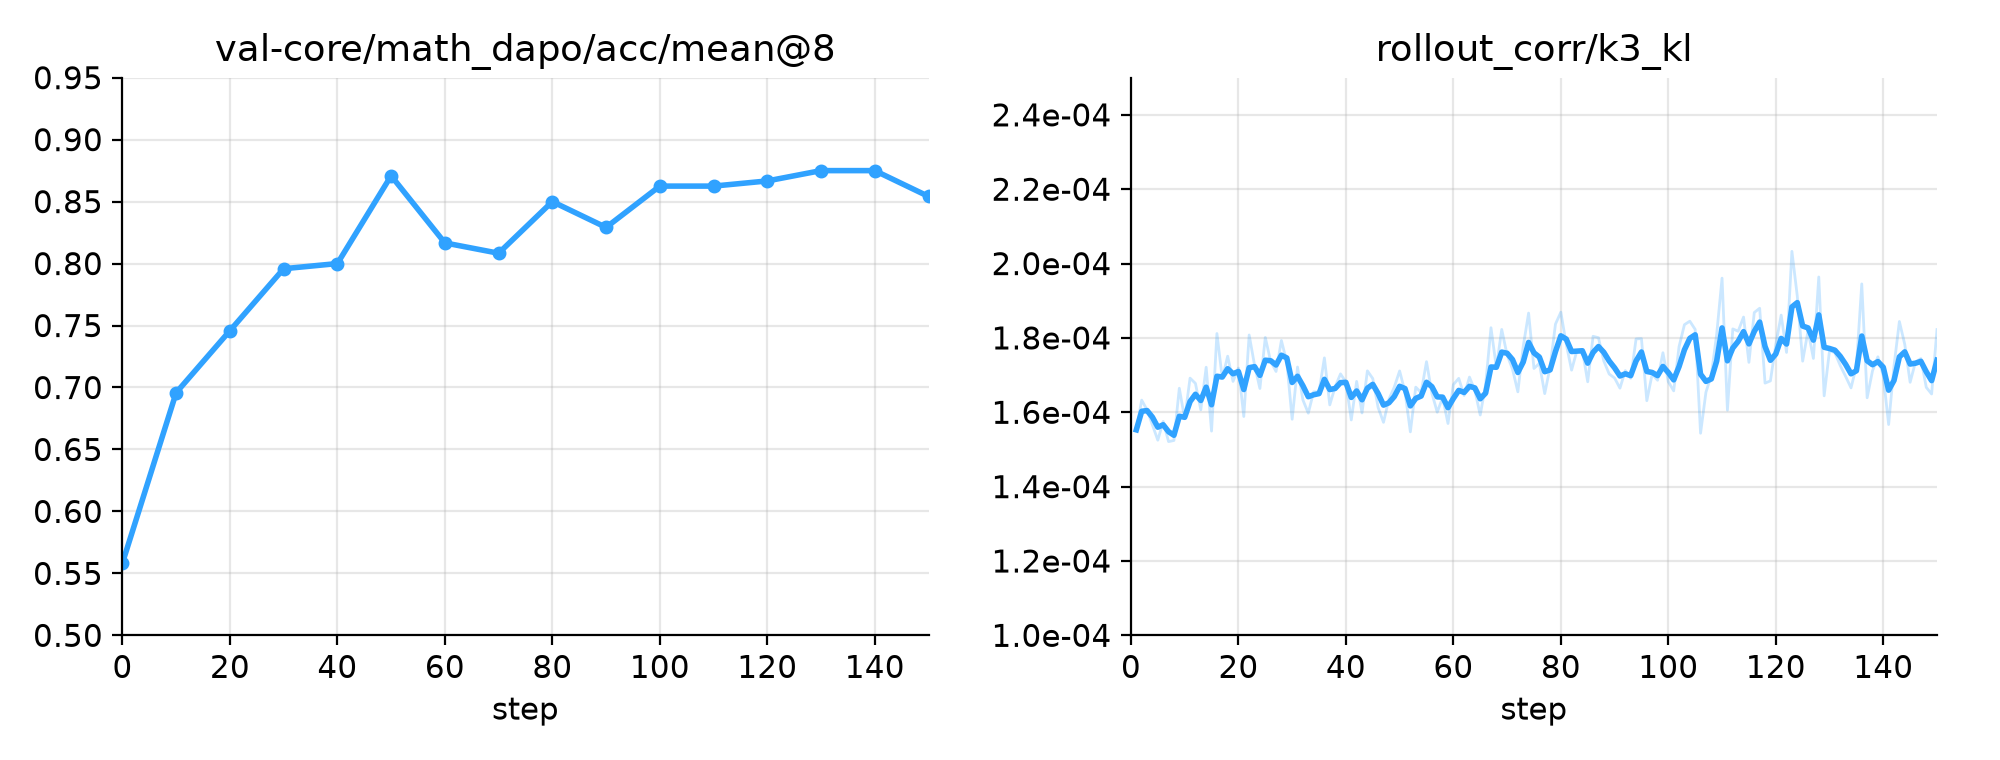
Đội ngũ vLLM huấn luyện bằng GRPO trên tập dữ liệu DAPO-Math-17K trong 150 bước, sử dụng 16 GPU GB300. Ở mỗi bước, hệ thống lấy mẫu 8 câu trả lời cho mỗi câu trong số 32 câu lệnh đầu vào; mỗi câu trả lời có thể dài tối đa 4K token.
Độ chính xác trên AIME-2024, đo bằng mean@8, tăng từ 0,56 trước khi huấn luyện lên 0,85 khi kết thúc. Trong suốt quá trình huấn luyện, độ lệch KL theo công thức k3 giữa log-xác suất của bộ phận huấn luyện và của vLLM được duy trì quanh mức 2×10⁻⁴.
Có thể xem thêm chi tiết tại PR #8257 của Verl.
Trong hệ sinh thái vLLM, Titan RL cũng sử dụng vLLM làm bộ máy tạo mẫu lượt tương tác, qua đó hỗ trợ học tăng cường ngay từ ngày đầu.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI tính phí theo từng phút sử dụng, minh bạch và không có phí ẩn. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.