Tối ưu vLLM trên Arm CPUs
Giới thiệu
Triển khai mô hình ngôn ngữ lớn (LLM) trên CPU là một lựa chọn quan trọng, vì CPU có chi phí triển khai thấp hơn, hạ tầng đơn giản hơn và được cung cấp rộng rãi tại các trung tâm dữ liệu cloud cũng như doanh nghiệp. Khi các máy chủ dựa trên Arm® Neoverse™ ngày càng được sử dụng phổ biến, việc cải thiện khả năng sử dụng, phạm vi tính năng và hiệu năng của các framework serving mã nguồn mở như vLLM trên Arm CPUs ngày càng trở nên quan trọng.
Trong vài tháng qua, Arm team đã phối hợp với cộng đồng vLLM, PyTorch, oneDNN và KleidiAI để thực hiện nhiều cải tiến trực tiếp trong upstream của toàn bộ stack serving trên Arm CPUs. Kết quả là khả năng sử dụng được cải thiện, phạm vi hỗ trợ mô hình và tính năng được mở rộng, đồng thời hiệu năng tăng đáng kể trên mọi máy chủ dựa trên Arm Neoverse chạy vLLM.
Trong bài viết này, trước tiên sẽ trình bày những cải tiến về khả năng sử dụng và phạm vi hỗ trợ, sau đó đi sâu vào các tối ưu hóa hiệu năng chính cũng như kết quả serving từ đầu đến cuối.
Enablement
Bên cạnh các tối ưu hóa hiệu năng, Arm team cũng cải thiện khả năng sử dụng và mức độ hoàn thiện tính năng của vLLM trên CPU của Arm®, giúp việc triển khai vLLM trên các máy chủ Arm® trở nên dễ dàng hơn.
Những cải tiến chính bao gồm:
-
-
-
- Cung cấp sẵn wheel và Docker image.
- Sửa các lỗi liên quan đến crash, độ chính xác, threading và mức sử dụng CPU.
- Hỗ trợ chunked prefill và prefix caching.
- Hỗ trợ suy luận INT8 W8A8 và INT8 W4A8.
- Bổ sung hỗ trợ cho các mô hình GPT-OSS, Whisper và Qwen 3.5 / 3.6.
- Tích hợp tốt hơn với hệ sinh thái PyTorch và UXL.
-
-
Sau khi hoàn thiện các phần hỗ trợ này, Arm team tập trung vào việc xác định và loại bỏ những điểm nghẽn về hiệu năng.
Cải thiện hiệu năng
Khi lần đầu benchmark vLLM trên CPU dựa trên Arm vào tháng 10/2025, hiệu năng thấp hơn nhiều so với kỳ vọng. Khoảng 80% thời gian chạy mô hình nằm ở các dense layer, vốn được thực thi bằng các phép BF16 GEMM đã được tối ưu rất tốt. Các GEMM kernel độc lập phía sau những layer này cũng đã đạt hiệu suất phần cứng gần với mức kỳ vọng, vì vậy việc chỉ tối ưu GEMM kernel khó có thể mang lại mức cải thiện lớn nhất.
Thay vào đó, các kết quả profiling cho thấy vấn đề cần tối ưu nằm trên phạm vi rộng hơn, bao gồm cơ chế cấp phát bộ nhớ, đồng bộ hóa runtime, overhead của framework, attention kernel và quá trình thực thi mô hình lượng tử hóa.
Cấp phát bộ nhớ
Việc serving LLM tạo áp lực đáng kể lên CPU memory allocator. Trong quá trình prefill và decode, vLLM liên tục cấp phát và giải phóng tensor để phục vụ scheduling, quản lý KV cache và lưu trữ kết quả trung gian của các operator. Trong những benchmark ban đầu, cấp phát bộ nhớ đã trở thành một điểm nghẽn. Khả năng tái sử dụng kém đối với các vùng cấp phát lớn khiến số lượng page fault tăng cao.
Nguyên nhân chính đến từ việc PyTorch sử dụng malloc của glibc. Các vùng nhớ lớn không được tái sử dụng hiệu quả qua những bước inference lặp lại, trong khi quá trình cấp phát và giải phóng bộ nhớ trở thành điểm tranh chấp khi số lượng thread tăng. Ban đầu, Arm team khuyến nghị preload một caching allocator để xử lý vấn đề này, nhưng cách làm đó yêu cầu thiết lập thủ công và khiến hiệu năng phụ thuộc vào cấu hình runtime.
Để cải thiện hiệu năng ngay sau khi cài đặt, Arm team đã bật mimalloc làm allocator mặc định trên CPU Arm trong PyTorch. mimalloc là một caching allocator được thiết kế để duy trì khả năng mở rộng khi phải xử lý áp lực cấp phát bộ nhớ từ nhiều thread. Arm team lựa chọn nó vì mimalloc cho hiệu năng tốt trên nhiều workload của TorchBench, đồng thời nó đã được tích hợp như một dependency của PyTorch trên các bản Linux không phải Arm.
Thay đổi này giúp throughput offline của Llama 3.1 8B tăng 2,3 lần ngay sau khi cài đặt, đồng thời mang lại mức cải thiện khoảng 7 lần trong các tình huống serving có concurrency thấp.
Lưu ý: Arm team không đưa phần cải thiện đến từ allocator vào các biểu đồ hiệu năng trong bài viết này, vì mức tăng quá lớn của nó sẽ làm thay đổi tỷ lệ biểu đồ và che khuất tác động của những tối ưu hóa khác. Do đó, các biểu đồ chỉ thể hiện mức cải thiện đến từ những thành phần còn lại của stack.
Đồng bộ hóa khi số lượng core lớn
Sau khi cải thiện khả năng cấp phát bộ nhớ, điểm nghẽn tiếp theo xuất hiện khi mở rộng quá trình inference lên số lượng core cao hơn. Khi vượt qua một ngưỡng nhất định, việc thêm core không còn giúp tăng throughput, thậm chí còn có thể khiến hiệu năng giảm.
Để xác định nguyên nhân khiến khả năng mở rộng bị giới hạn, Arm team profiling từng layer khi số lượng thread ở mức cao. Một profile cho thấy 74% thời gian của paged attention được dành cho dynamic scheduling của OpenMP:
97.94% gomp_thread_start
    90.08% paged_attention_v1_impl
        74.07% gomp_iter_dynamic_next
          7.00% reduceValueBlock::lambda(int)
gomp_iter_dynamic_next
Là một phần trong cơ chế dynamic loop scheduling của libgomp. Trong cơ chế này, runtime sử dụng atomic fetch-add để phân chia các chunk của vòng lặp cho những worker thread. Runtime libgomp được sử dụng trong các wheel của PyTorch triển khai thao tác atomic này bằng một vòng lặp retry sử dụng load-linked / store-conditional:
for (;;) {
     long old = LDXR(p);
     long newv = old + delta;
     int fail = STLXR(p, newv);
     if (fail == 0) {
         DMB_ISH();
         return old;
     }
}
Khi số lượng core tăng cao, nhiều worker thread cùng tranh chấp trên một thao tác atomic, dẫn đến nhiều lần ghi thất bại và phải retry liên tục.
Khi truy vấn sâu hơn xuống mức assembly, Arm team phát hiện một cơ hội tối ưu phần cứng chưa được tận dụng. Hệ thống benchmark sử dụng Neoverse™ V2, vốn hỗ trợ Arm Large System Extensions (LSE). LSE cung cấp các lệnh atomic được xử lý trực tiếp bằng phần cứng, chẳng hạn LDADDAL, giúp thay thế vòng lặp kém hiệu quả ở trên. Tuy nhiên, OpenMP runtime mà PyTorch sử dụng chưa tận dụng các LSE atomic này.
Arm team giải quyết vấn đề bằng cách xây dựng libgomp runtime trong PyTorch để sử dụng LSE atomic trên những CPU có hỗ trợ.
Thay đổi này giúp throughput offline của Llama 3.1 8B tăng 9% và giảm độ trễ Time Per Output Token (TPOT) 15% trong các trường hợp serving có concurrency thấp.
Overhead do layout ở dense layer
Ngay cả sau khi cải thiện bộ cấp phát bộ nhớ và runtime, dense layer vẫn còn dư địa để tối ưu hiệu năng. Các GEMM kernel hiệu năng cao rất nhạy với cách sắp xếp weight. Để chạy hiệu quả, weight cần được đưa về dạng blocked format phù hợp với cách kernel vector hóa và truy cập cache. Nếu không prepack, mỗi lần gọi kernel có thể phải trả thêm chi phí chuyển đổi weight từ layout tensor của framework sang định dạng phù hợp với kernel.
Vấn đề này đặc biệt rõ ở mức concurrency thấp, khi chi phí packing không được phân bổ trên các batch lớn. Arm team giải quyết bằng cách bật một oneDNN path nhanh cho dense layer, được tăng tốc nhờ Compute Library for Arm Architecture. Path này cho phép vLLM pack weight BF16 trong quá trình model warmup theo định dạng mà kernel yêu cầu, sau đó tái sử dụng phần dữ liệu đã được pack trong quá trình inference.
Thay đổi này giúp throughput offline của Llama 3.1 8B tăng 16% và giảm độ trễ TPOT 60% trong các tình huống serving có concurrency thấp.
Paged Attention
CPU paged attention kernel trước đây chưa được tối ưu cho CPU dựa trên Arm. Các phép nhân ma trận QK và PV, cùng với phép tính exponential trong softmax, đều phải sử dụng implementation tham chiếu. Vì vậy, Arm team phải dựa vào Scaled Dot-Product Attention kernel của PyTorch cho prefill, khiến chunked prefill và prefix caching chưa được hỗ trợ trên path CPU Arm.
Arm team tối ưu các path QK và PV bằng GEMM kernel tùy chỉnh, sử dụng các lệnh Arm BFMMLA Advanced SIMD. Đồng thời, phép exponential trong softmax cũng được tối ưu bằng một phép xấp xỉ đa thức bậc ba được vector hóa để tăng tốc.
Những thay đổi này giúp paged attention nhanh hơn tới 4 lần và tăng throughput offline của Llama 3.1 8B thêm 12%. Ngoài ra, Arm team có thể bật paged attention cho prefill trên CPU Arm, qua đó mở khóa hỗ trợ cho chunked prefill và prefix caching.
Cải thiện hiệu năng BF16
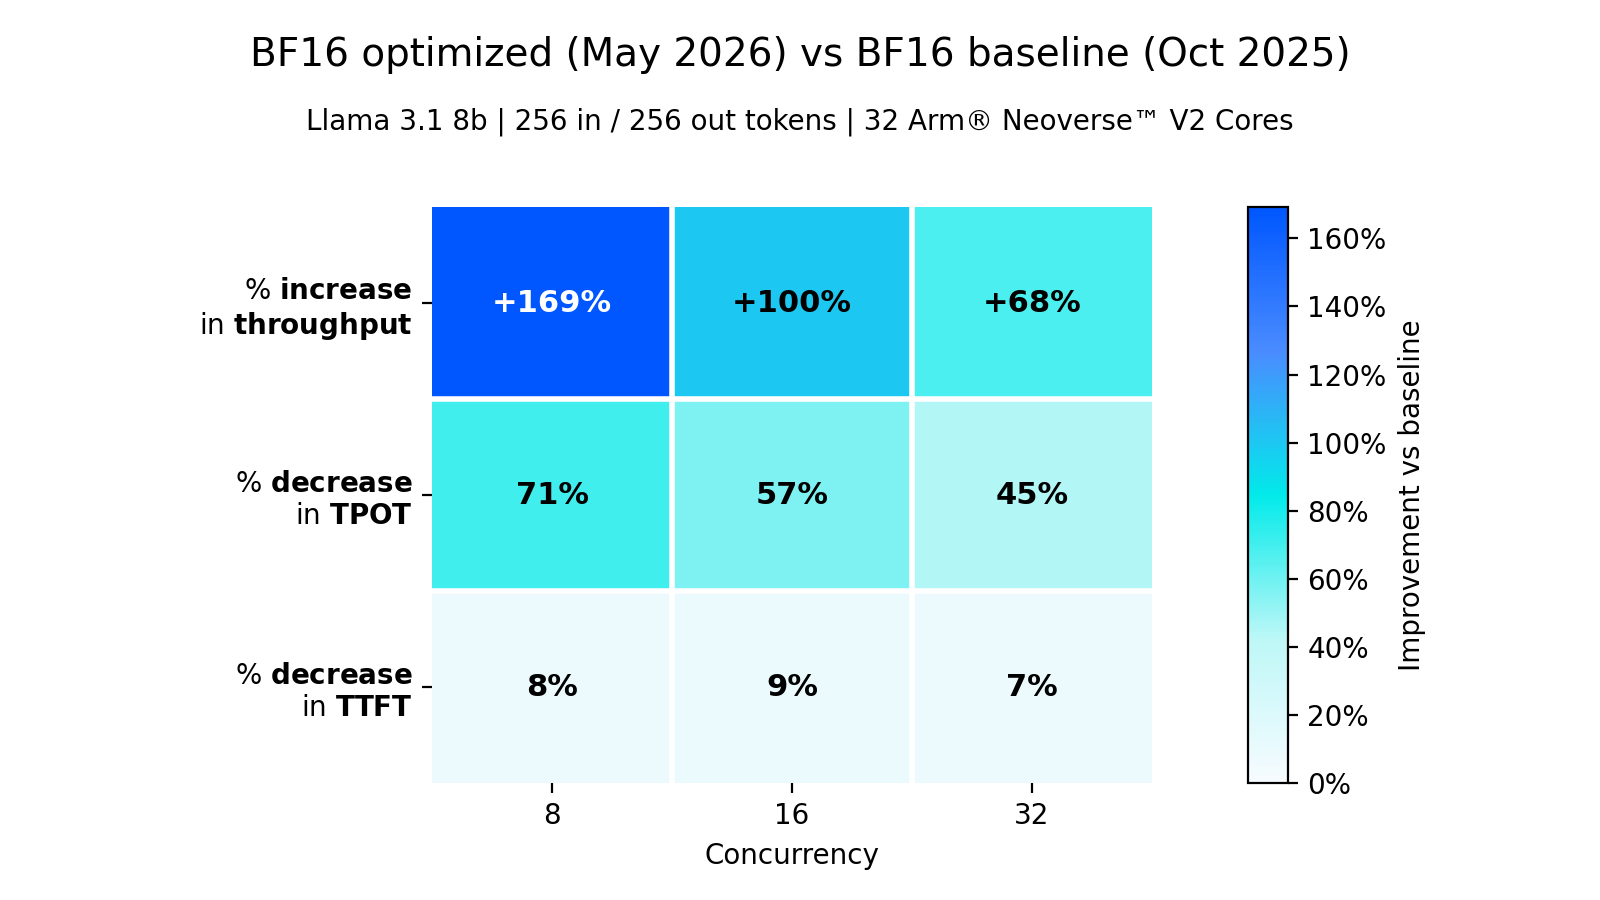
Các tối ưu hóa về synchronization, weight prepacking và paged attention kết hợp với nhau, tạo ra một nền tảng serving BF16 mạnh hơn đáng kể so với phiên bản ban đầu mà Arm team benchmark vào tháng 10/2025.
INT8 W8A8 (trọng số và activation 8-bit)
Trong quá trình suy luận, LLM liên tục đọc các ma trận trọng số có kích thước lớn ở cả giai đoạn prefill và decode. Việc lưu trọng số ở định dạng INT8 thay vì BF16 giúp giảm áp lực lên băng thông bộ nhớ, đồng thời cho phép các mô hình lớn hơn có thể vừa trong cùng một dung lượng bộ nhớ.
Trên CPU nền tảng Arm có I8MM, W8A8 cũng được ánh xạ sang SMMLA, một lệnh nhân và cộng dồn ma trận INT8 có dấu của Arm. Về lý thuyết, lệnh này cung cấp thông lượng nhân ma trận gấp đôi BF16.
Để tận dụng khả năng này, nhóm phát triển đã tăng tốc quy trình lượng tử hóa W8A8 bằng các kernel JIT của oneDNN, sử dụng lệnh SMMLA trên SVE128 và SVE256.
Nhờ đó, nhiều checkpoint INT8 W8A8 trên Hugging Face, bao gồm RedHatAI/Meta-Llama-3.1-8B-quantized.w8a8 và RedHatAI/whisper-large-v3-quantized.w8a8, hiện có thể hoạt động tốt ngay sau khi cài đặt.
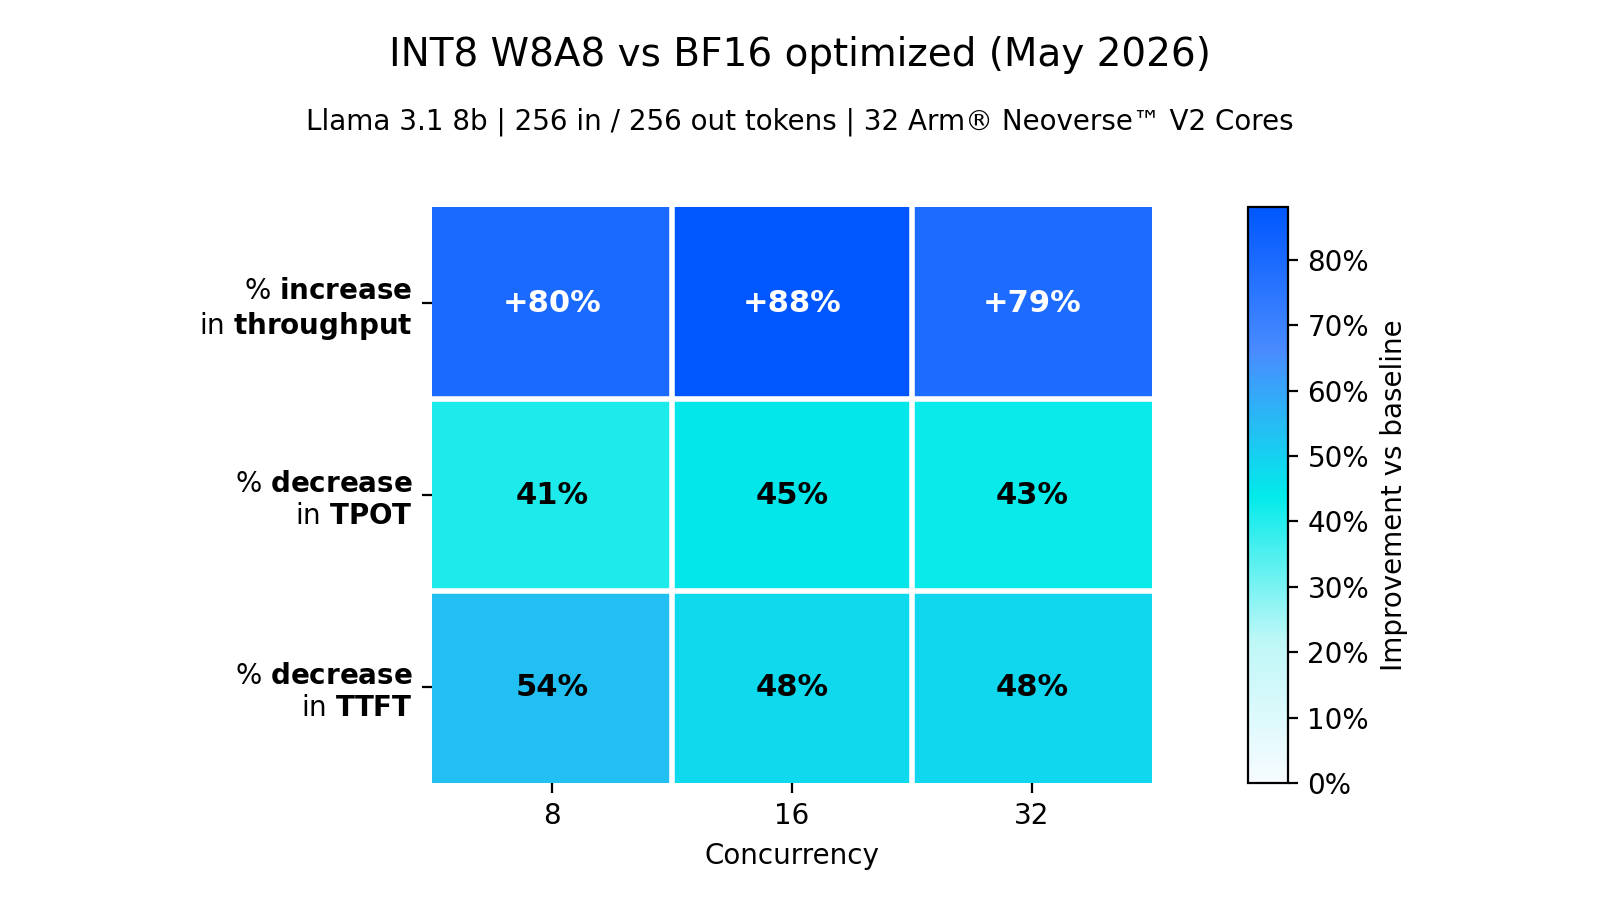
So với mốc BF16 đã được tối ưu ở trên, W8A8 với lượng tử hóa activation theo từng token và lượng tử hóa trọng số theo từng channel có thể đạt thông lượng cao hơn tới 88%, TPOT thấp hơn 45% và TTFT thấp hơn 54%, tùy theo mức độ đồng thời.
Lưu ý: Để tìm hiểu thêm về INT8 W8A8 trên CPU nền tảng Arm, bạn có thể tham khảo Arm Learning Path.
INT8 W4A8 (trọng số 4-bit, activation 8-bit)
W4A8 đẩy phương pháp này đi xa hơn bằng cách lượng tử hóa trọng số xuống INT4, từ đó tiếp tục giảm áp lực lên băng thông bộ nhớ trong quá trình suy luận. Cách này đặc biệt hữu ích khi mức độ đồng thời thấp, vì khi đó khả năng batching hạn chế và chi phí đọc trọng số của mô hình khó được phân bổ trên nhiều request.
Quy trình này được tăng tốc nhờ các micro-kernel INT4 của KleidiAI.
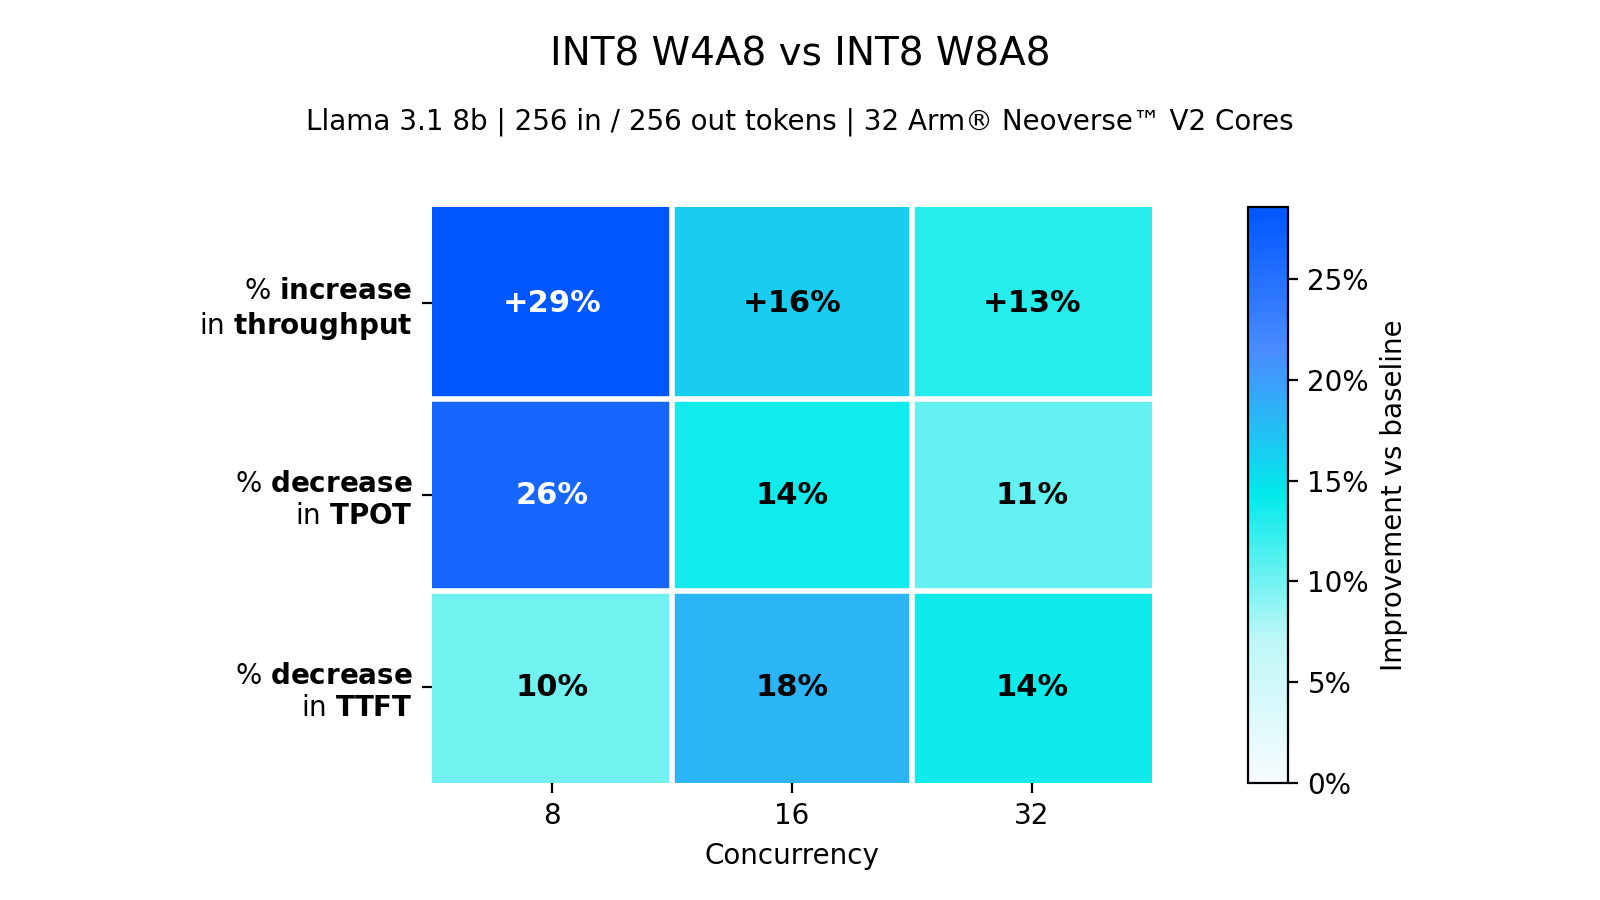
So với mốc W8A8 ở trên, W4A8 với lượng tử hóa activation theo từng token và lượng tử hóa trọng số theo từng channel có thể đạt thông lượng cao hơn tới 29%, TPOT thấp hơn 26% và TTFT thấp hơn 18%, tùy theo mức độ đồng thời.
Như dự kiến, W4A8 mang lại mức tăng tốc lớn nhất khi mức độ đồng thời thấp, bởi lúc này quá trình suy luận chủ yếu bị giới hạn bởi băng thông bộ nhớ.
Lưu ý: Xem tài liệu này để biết cách lượng tử hóa model sang INT8 W4A8 bằng llm-compressor.
Tóm tắt
vLLM trên CPU dựa trên Arm đã có những cải thiện đáng kể về khả năng sử dụng, độ ổn định, phạm vi hỗ trợ model và tính năng, cũng như hiệu năng.
So với mốc BF16 ban đầu vào tháng 10/2025, cấu hình BF16 đã được tối ưu đạt tối đa 2,7 lần throughput khi phục vụ. INT8 W8A8 đạt tối đa 4,8 lần throughput so với mốc ban đầu và tăng tốc TPOT 5,7 lần, trong khi INT8 W4A8 cho kết quả tốt nhất với tối đa 6,2 lần throughput, tăng tốc TPOT 7,8 lần và tăng tốc TTFT 2,6 lần.
Những cải thiện này đến từ việc tối ưu toàn bộ stack suy luận trên CPU, bao gồm cấp phát bộ nhớ, đồng bộ hóa OpenMP, prepacking cho dense layer, paged attention và quantization.
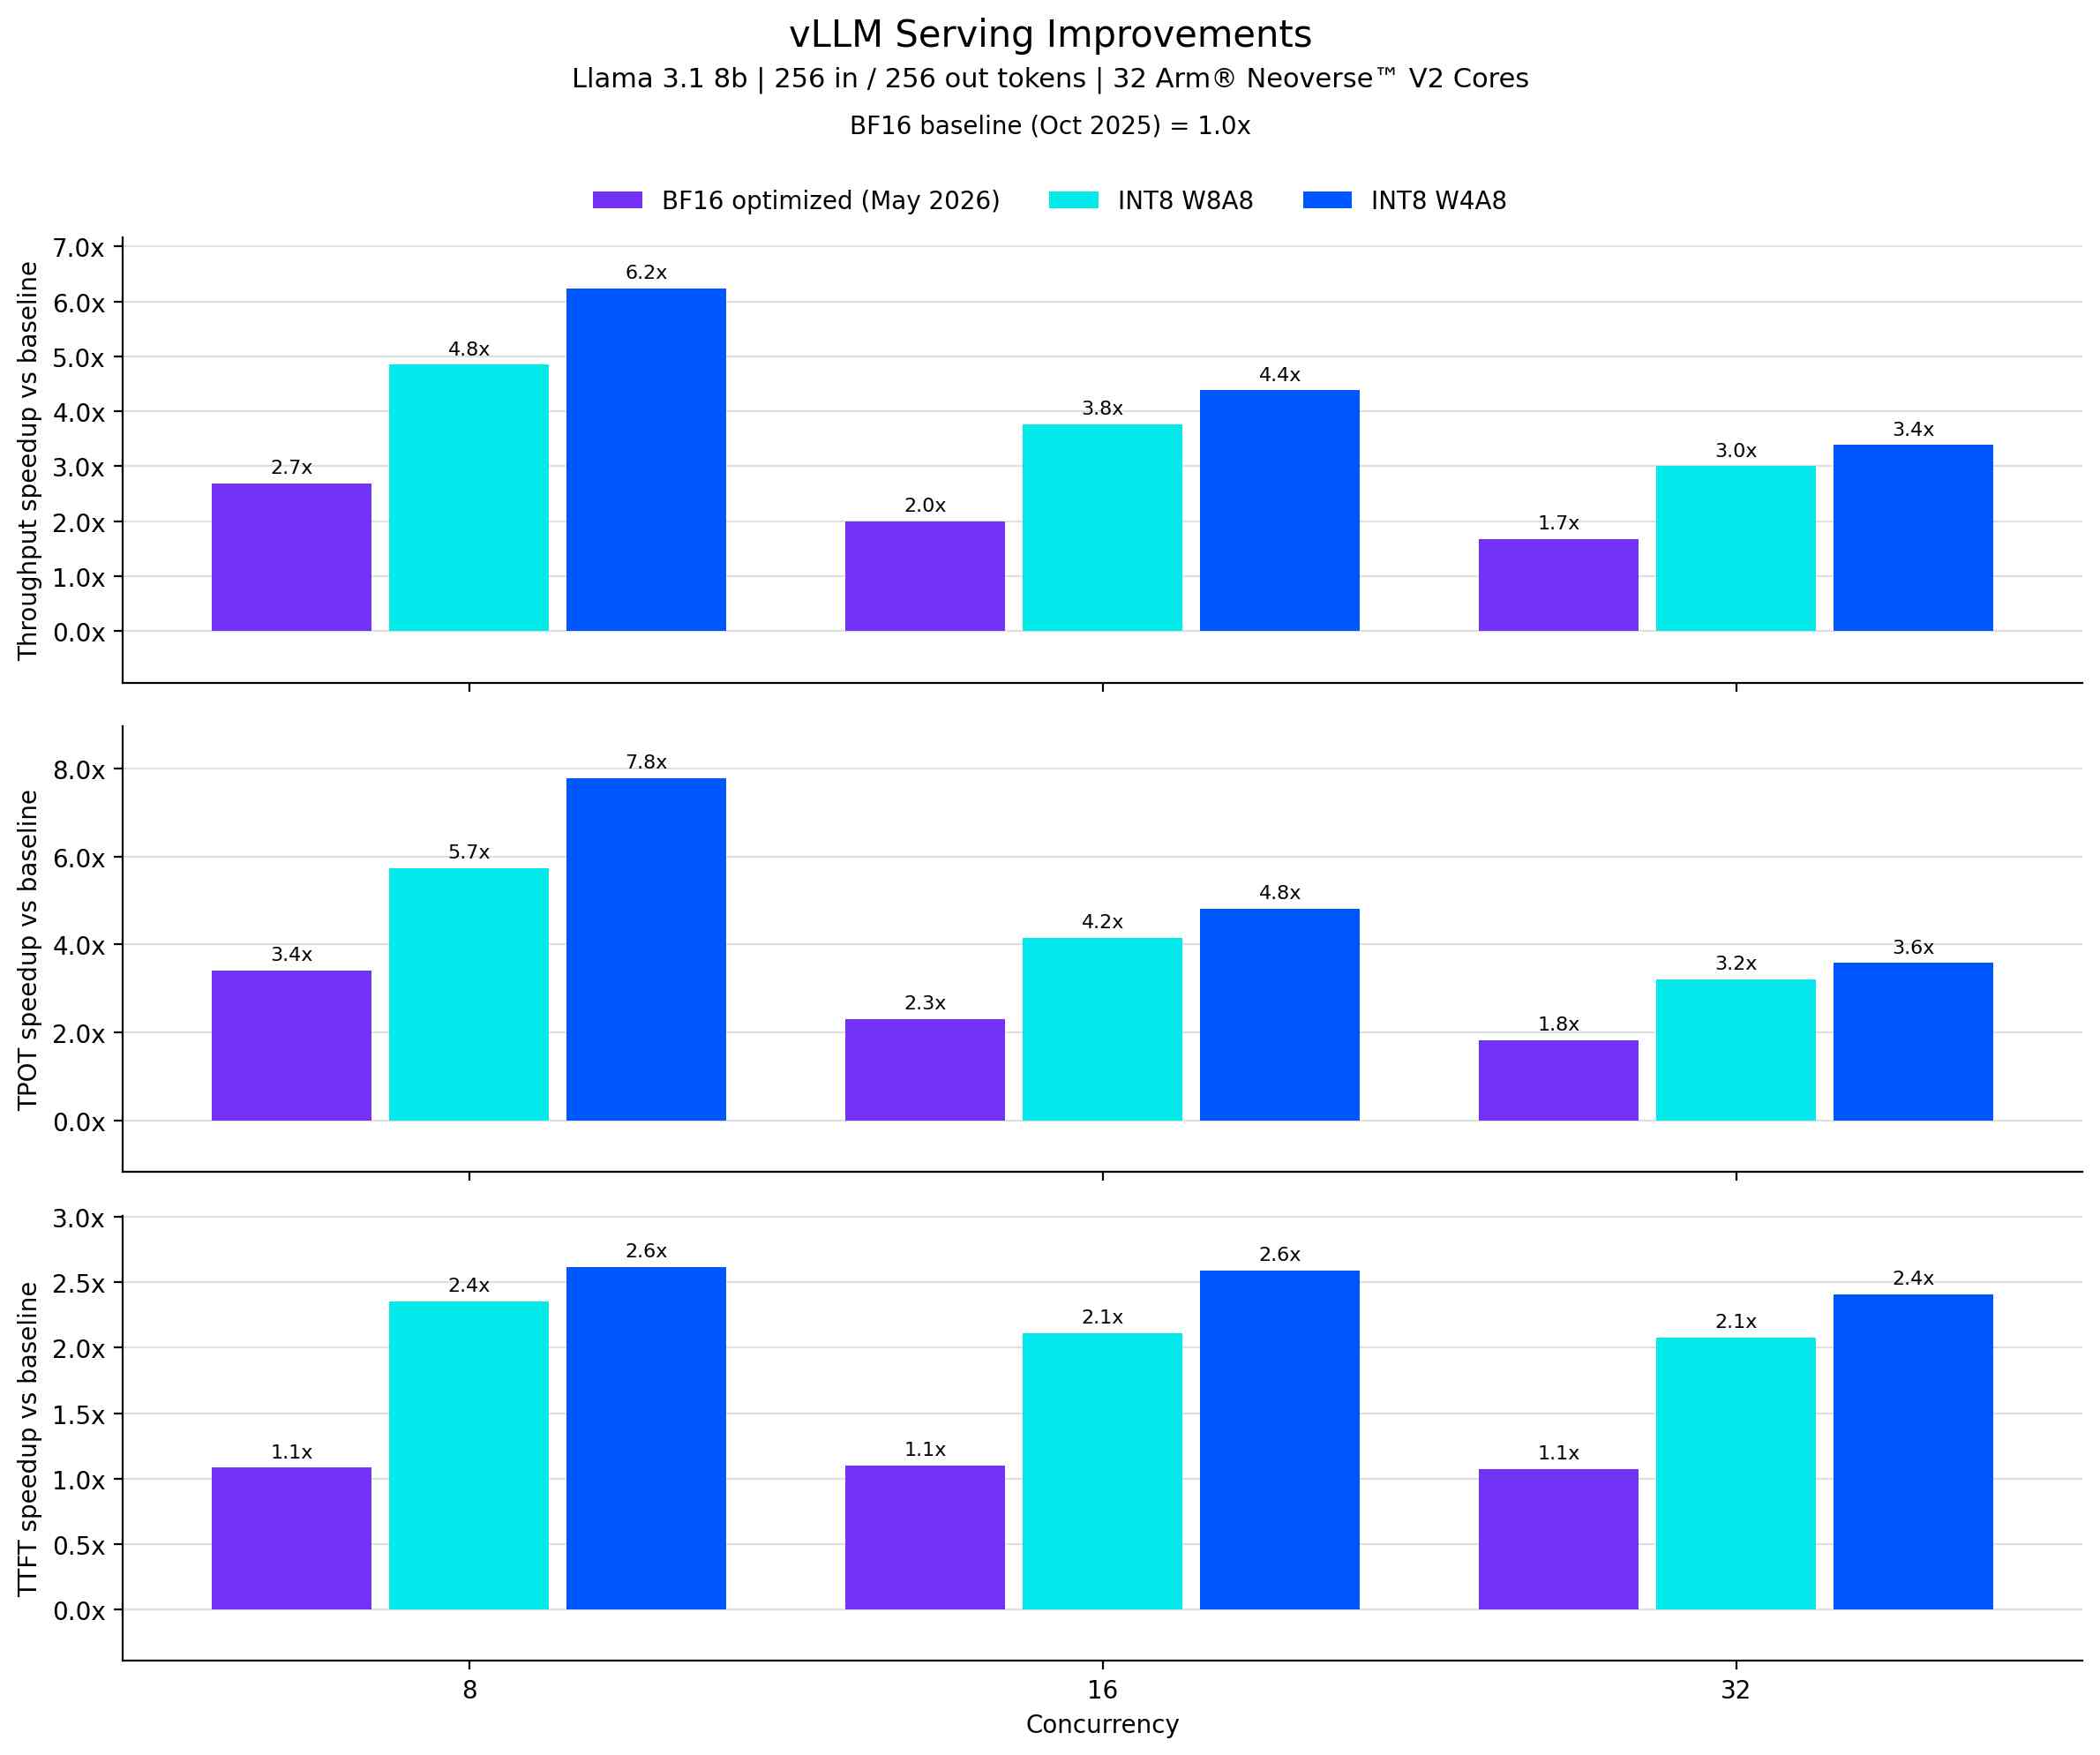
Không chỉ cải thiện hiệu năng đo được, những thay đổi này còn giúp vLLM trở thành một stack suy luận hoàn chỉnh và sẵn sàng hơn cho môi trường production trên các máy chủ sử dụng Arm Neoverse. Điều này đến từ phạm vi hỗ trợ tính năng rộng hơn, khả năng sử dụng tốt hơn ngay sau khi cài đặt, nhiều cải tiến được tích hợp trực tiếp vào upstream, cùng khả năng hỗ trợ thêm nhiều model.
iRender - GPU Cloud cho AI/Học máy với vLLM
Hiện nay có rất nhiều tùy chọn cho AI/Học máy với vLLM trong và ngoài nước. Tuy nhiên, những dịch vụ đó thường khá khó sử dụng đối với những người mới bắt đầu. Việc tính toán giá cả cũng phức tạp với nhiều chi phí ẩn mà bạn cần các khóa học để giúp bạn hiểu nó hoạt động thế nào, làm sao để không bị mất tiền vô nghĩa.
iRender AI áp dụng chính sách giá trọn gói cố định minh bạch theo giờ hoặc theo ngày. Doanh nghiệp hoàn toàn kiểm soát được dòng tiền và ngân sách vận hành dự án AI mà không lo sợ bất kỳ khoản chi phí phát sinh bất ngờ nào.
Tham khảo thêm chi phí và cấu hình của iRender tại đây.
Ngoài ra, iRender còn cung cấp cho bạn nhiều hỗ trợ khác, không chỉ những cấu hình mạnh.
-
-
-
- Hiệu năng thô đạt 100% — Giải quyết triệt để hao hụt tài nguyên do ảo hóa
- Băng thông PCIe độc quyền — Triệt tiêu nghẽn cổ chai (I/O Bottleneck) khi chạy RAG
- Bảo mật Data Isolation tuyệt đối — Nền tảng cho AI Chủ Quyền
- Hạ tầng đặt tại Data Center chuẩn Tier III — Cam kết Uptime 99.98%
- Toàn quyền Root Access — Tự do làm chủ môi trường MLOps và Scale Module linh hoạt bằng cách thêm máy
- Zero Cold Start — Phản hồi tức thì cho Voice AI và AI Agent
- Minh bạch chi phí — Loại bỏ hoàn toàn phí ẩn (Hidden Fee)
-
-
Bạn có thể đăng ký tài khoản qua link này ngay hôm nay để trải nghiệm dịch vụ của iRender. Hoặc liên hệ qua Zalo 0916806116 để được tư vấn và hỗ trợ.
Trân trọng cảm ơn!
Nguồn: vllm.ai
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.