Video AI Pipeline: Từ Camera đến Real-time Inference - GPU Thực Sự Làm Gì?
Khi nói đến Video AI, nhiều người thường hình dung đơn giản: camera gửi video → YOLO nhận diện → trả kết quả. Nhưng trong một hệ thống thực tế, inference chỉ là một mắt xích trong cả pipeline.
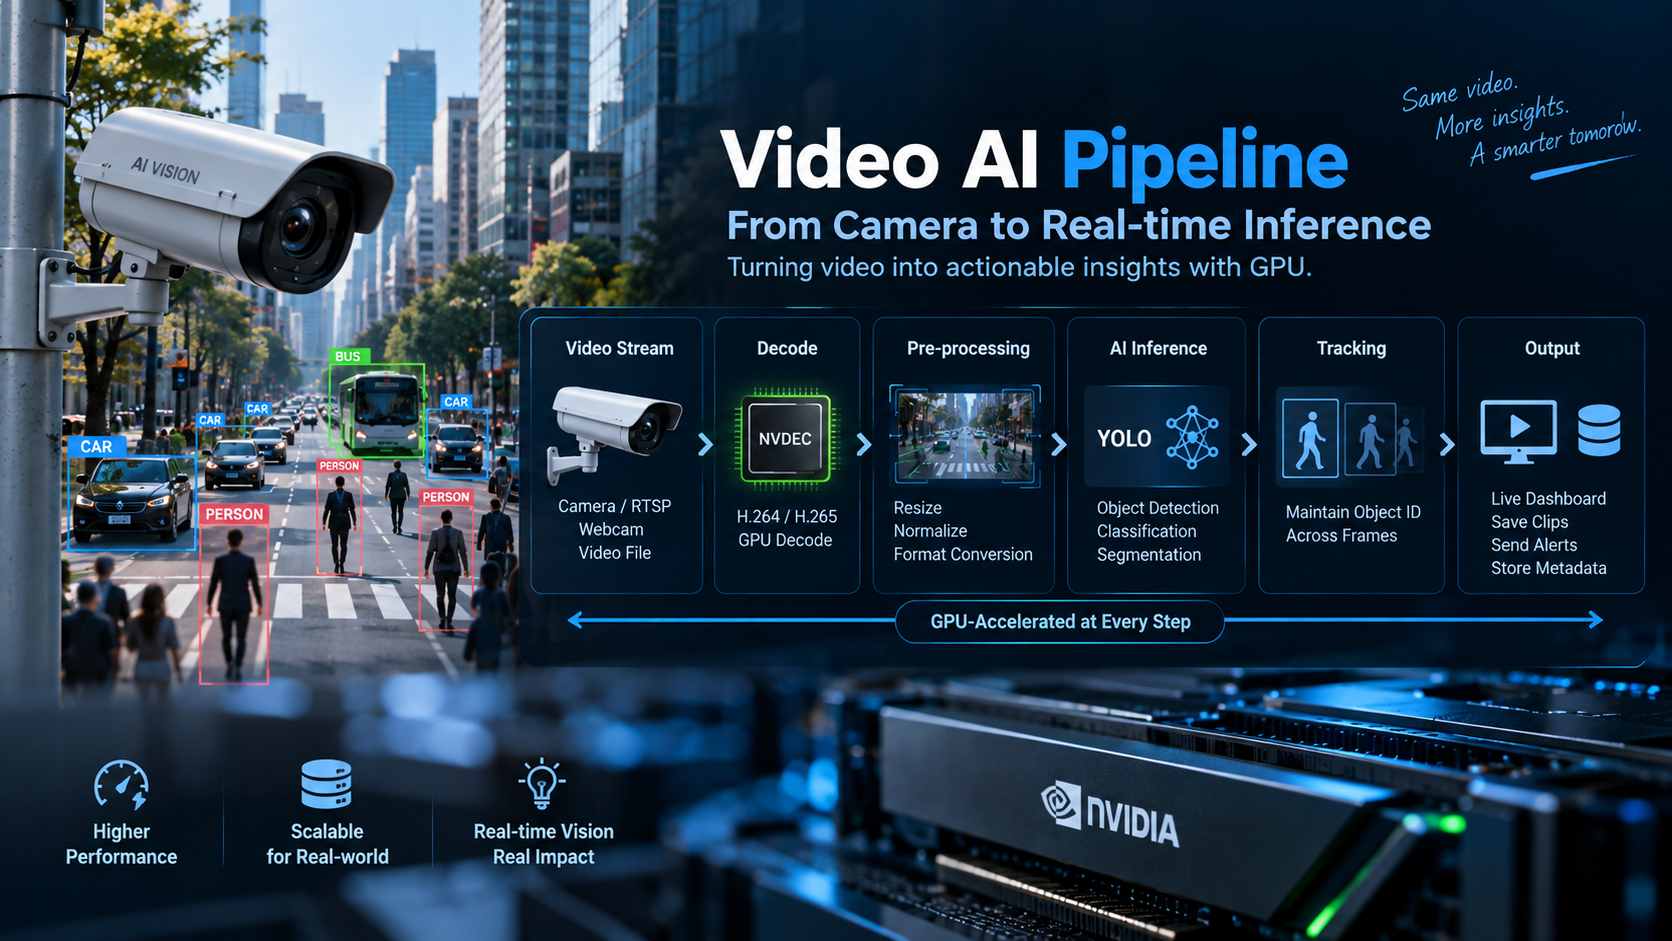
Trước khi một frame được đưa vào model, hệ thống còn phải nhận stream, giải mã video, tiền xử lý hình ảnh, đưa dữ liệu lên GPU, chạy inference, tracking và cuối cùng mới xuất kết quả hoặc lưu trữ.
Vì vậy, khi số lượng camera tăng từ 1 lên 10, 50 hay 100, bài toán không còn đơn giản là “model chạy nhanh bao nhiêu FPS”, mà trở thành bài toán tối ưu toàn bộ pipeline.
1. Video AI Pipeline gồm những gì?
Một pipeline Video AI cơ bản có thể hình dung như sau:
Camera → Video Stream → Decode → Pre-processing → AI Inference → Tracking → Post-processing → Output/Storage
Mỗi bước đảm nhiệm một nhiệm vụ khác nhau và có thể trở thành bottleneck nếu hệ thống không được thiết kế phù hợp.
1.1. Video Stream: Dữ liệu bắt đầu từ đâu?
Nguồn đầu vào có thể là camera IP, webcam, file video hoặc một live stream.
Với camera giám sát, các giao thức như RTSP thường được sử dụng để truyền video qua mạng. Video thường được nén bằng các codec như H.264 hoặc H.265 nhằm giảm bandwidth.
Ví dụ một hệ thống có 20 camera 1080p, mỗi camera truyền 25–30 FPS. Số lượng dữ liệu cần tiếp nhận và xử lý đã rất lớn, ngay cả trước khi AI bắt đầu inference.
Đây là lý do bandwidth, network latency và khả năng xử lý video cũng quan trọng không kém model AI.
1.2. Video Decode: GPU không chỉ để chạy AI
Video từ camera thường ở dạng compressed stream – dữ liệu đã nén. Model AI lại cần những frame hình ảnh có thể xử lý được.
Do đó, hệ thống phải thực hiện bước video decoding.
Nếu decode bằng CPU, khi số lượng stream tăng cao, CPU có thể nhanh chóng trở thành bottleneck. GPU NVIDIA cung cấp phần cứng chuyên dụng cho video decode như NVDEC, giúp chuyển compressed video thành frame mà không cần dùng toàn bộ tài nguyên CPU cho công việc này.
Điều này đặc biệt quan trọng trong hệ thống multi-camera.
Thay vì:
Camera → CPU Decode → GPU Inference
có thể xây dựng pipeline:
Camera → GPU Decode → GPU Processing → GPU Inference
Khi đó dữ liệu có thể được giữ trên GPU lâu hơn, giảm việc copy dữ liệu qua lại giữa CPU và GPU.
1.3. Pre-processing: Một frame chưa thể đưa thẳng vào model
Frame sau khi decode thường chưa có định dạng phù hợp với model. Pipeline có thể cần thực hiện:
- Resize: Thay đổi kích thước
- Crop: Cắt ảnh
- Normalize: Chuẩn hóa
- Color conversion: Chuyển đổi không gian màu
- Padding: Thêm vùng đệm
- Format conversion: Chuyển đổi định dạng
- Batch preparation: Chuẩn bị dữ liệu theo batch
Ví dụ model yêu cầu input 640×640 nhưng camera gửi frame 1920×1080. Hình ảnh phải được resize hoặc letterbox trước khi inference.
Nếu chỉ có một camera, chi phí preprocessing có thể không đáng kể.
Nhưng với hàng chục camera chạy liên tục, preprocessing trở thành một workload đáng kể. Đây cũng là lý do các pipeline Video AI hiện đại thường cố gắng thực hiện càng nhiều thao tác trên GPU càng tốt.
1.4. AI Inference: Đây mới là phần mọi người thường nghĩ đến
Sau khi frame được chuẩn bị, dữ liệu được đưa vào model Computer Vision.
Ví dụ:
YOLO → Object Detection
Model có thể phát hiện:
- Person
- Car
- Motorbike
- Animal
- Product
- Industrial object
Kết quả thường bao gồm bounding box, class và confidence score.
Nhưng inference không nhất thiết phải chạy trên mọi frame.
Ví dụ camera chạy 30 FPS nhưng hệ thống chỉ cần inference 10 FPS. Khi đó có thể sử dụng frame sampling hoặc các kỹ thuật pipeline khác để giảm tải GPU.
Đây là một trong những cách quan trọng để cân bằng giữa accuracy, latency và throughput.
1.5. Tracking: Khi AI cần biết “đó vẫn là người đó”
Detection cho biết trong frame hiện tại có những đối tượng nào.
Nhưng với video, chúng ta thường cần nhiều hơn thế.
Ví dụ:
Frame 1: Person A
Frame 2: Person A
Frame 3: Person A
Hệ thống cần xác định rằng đây vẫn là cùng một đối tượng thay vì tạo một object mới ở mỗi frame.
Đó là nhiệm vụ của Object Tracking.
Các thuật toán tracking có thể sử dụng thông tin từ bounding box, chuyển động và đặc trưng hình ảnh để duy trì ID của đối tượng qua nhiều frame.
Pipeline lúc này trở thành:
Detection → Tracking → Object ID
Điều này mở ra nhiều ứng dụng như đếm người, phân tích giao thông, theo dõi phương tiện hoặc phát hiện hành vi.
1.6. Post-processing: Biến prediction thành thông tin hữu ích
Output từ model thường chưa phải kết quả cuối cùng.
Hệ thống có thể cần:
- lọc confidence
- loại bỏ detection trùng
- tracking
- counting
- zone detection
- line crossing
- event detection
- gửi cảnh báo
Ví dụ:
Person detected + đi vào restricted zone → Security Alert
Lúc này AI không chỉ “nhìn thấy một người”, mà đã chuyển prediction thành một sự kiện có ý nghĩa.
1.7. Output & Storage: Kết quả đi đâu?
Sau inference, hệ thống có thể:
- hiển thị video đã annotate
- gửi metadata tới server
- lưu frame
- lưu clip
- ghi database
- gửi cảnh báo
- stream kết quả tới dashboard
Không phải lúc nào cũng cần lưu toàn bộ video.
Một hệ thống thông minh có thể chỉ lưu video khi một event xảy ra. Ví dụ camera chạy liên tục nhưng chỉ lưu clip khi phát hiện người đi vào khu vực cấm.
Cách này giúp giảm đáng kể storage và bandwidth.
2. Vậy GPU thực sự làm những gì?v
Điểm thú vị của Video AI Pipeline là GPU có thể tham gia vào nhiều bước chứ không chỉ inference.
Một pipeline được tối ưu tốt có thể tận dụng GPU cho:
Video Decode → Pre-processing → Inference → Post-processing → Encode
Trong đó:
- NVDEC hỗ trợ video decoding
- GPU xử lý các thao tác hình ảnh
- Tensor Cores/GPU compute chạy AI inference
- NVENC có thể hỗ trợ video encoding
Mục tiêu là giảm việc di chuyển dữ liệu giữa CPU và GPU.
Nếu mỗi frame liên tục phải:
GPU → CPU → GPU → CPU
thì phần copy dữ liệu và synchronization có thể trở thành bottleneck.
Một pipeline tốt sẽ cố gắng giữ dữ liệu trên GPU càng lâu càng tốt.
3. Từ một camera đến hàng trăm camera: bài toán thay đổi như thế nào?
Với một camera, pipeline có thể chạy rất đơn giản:
1 Stream → 1 Decode → 1 Inference
Nhưng với 50 camera:
50 Streams → 50 Decode Workloads → Pre-processing → Inference → Tracking → Output
Lúc này cần quan tâm đến nhiều yếu tố hơn:
GPU Compute
Model cần bao nhiêu GPU resources để xử lý số lượng frame đó?
VRAM
Mỗi stream có thể cần buffer, tensor và intermediate data. Khi số lượng stream tăng, VRAM cũng trở thành một yếu tố quan trọng.
Video Decode Capacity
GPU có thể decode bao nhiêu stream đồng thời ở độ phân giải và codec nhất định?
Network
50 camera đồng nghĩa với lượng dữ liệu truyền vào rất lớn. Network có thể trở thành bottleneck trước cả GPU.
Storage
Nếu lưu toàn bộ video, storage sẽ tăng cực nhanh.
Latency
Với camera real-time, throughput cao nhưng latency quá lớn cũng không có nhiều ý nghĩa.
4. Throughput và Latency: Hai con số cần nhìn cùng nhau
Trong Video AI, hai chỉ số thường được quan tâm là:
Throughput: hệ thống xử lý được bao nhiêu frame mỗi giây.
Latency: mất bao lâu để một frame đi từ input đến output.
Ví dụ một pipeline đạt 500 FPS nghe có vẻ rất nhanh.
Nhưng nếu frame phải chờ trong queue vài giây trước khi inference thì hệ thống đó không phù hợp cho cảnh báo real-time.
Ngược lại, latency thấp nhưng throughput quá thấp cũng khiến pipeline không thể xử lý đủ số lượng camera.
Do đó, mục tiêu không phải đơn giản là “FPS càng cao càng tốt”, mà là tìm được sự cân bằng phù hợp với workload.
5. Một pipeline Video AI tối ưu trông như thế nào?
Một kiến trúc phổ biến có thể được hình dung:
Camera / RTSP
↓
Video Decode
↓
GPU Memory
↓
Pre-processing
↓
AI Inference
↓
Object Tracking
↓
Event Detection
↓
Encode / Metadata / Storage
Điểm quan trọng là giảm tối đa các bước copy dữ liệu không cần thiết.
Đặc biệt với workload nhiều camera, việc tối ưu data movement đôi khi mang lại hiệu quả lớn không kém việc thay đổi model.
6. Khi nào cần GPU mạnh hơn?
Không phải mọi Video AI workload đều cần GPU cao cấp.
Một camera 720p với model nhẹ có thể không tạo ra workload quá lớn.
Nhưng khi bắt đầu tăng:
- số lượng camera
- resolution
- FPS
- model size
- số model chạy song song
- tracking workload
- preprocessing
- video encoding
thì nhu cầu GPU sẽ tăng nhanh.
Ví dụ một hệ thống có thể chạy:
10 camera × 30 FPS = 300 input frames/second
Nhưng nếu mỗi frame đều phải chạy detection, tracking và thêm một model classification nữa, workload thực tế sẽ lớn hơn rất nhiều so với con số 300 FPS ban đầu.
Đó là lúc GPU Cloud trở nên hữu ích: thay vì đầu tư một hệ thống GPU cố định chỉ để phục vụ peak workload, doanh nghiệp có thể scale tài nguyên theo nhu cầu.
7. iRender - GPU Cloud cho Video AI

Để Video AI chạy real-time ổn định, GPU không chỉ cần mạnh để chạy model mà toàn bộ pipeline từ decode, preprocessing, inference đến encode cũng phải được tối ưu. Vì vậy, hạ tầng GPU, băng thông PCIe và khả năng mở rộng đều đóng vai trò quan trọng.
iRender AI cung cấp GPU Cloud bare-metal với hiệu năng cao, băng thông PCIe mạnh, Root Access và khả năng scale linh hoạt, phù hợp cho các workload như Computer Vision, Video Analytics và Real-time Inference. Chi phí được tính minh bạch theo thời gian sử dụng, giúp doanh nghiệp dễ kiểm soát ngân sách.
Tham khảo cấu hình và chi phí iRender tại đây.
Đăng ký tài khoản để trải nghiệm iRender AI hoặc liên hệ đội ngũ chăm sóc khách hàng của chúng tôi để được tư vấn cấu hình phù hợp.
FAQs
- Video AI Pipeline là gì?
Là quy trình xử lý video từ camera hoặc video stream qua các bước decode, pre-processing, AI inference, tracking và xuất kết quả. - GPU đóng vai trò gì trong Video AI?
GPU có thể xử lý video decoding, preprocessing, AI inference và encoding, giúp giảm tải CPU và tăng hiệu suất pipeline. - Video AI có nhất thiết phải dùng GPU không?
Không. Workload nhỏ có thể chạy trên CPU, nhưng GPU phù hợp hơn khi xử lý video độ phân giải cao, nhiều FPS hoặc nhiều camera cùng lúc. - NVDEC và NVENC là gì?
NVDEC hỗ trợ giải mã video trên GPU, còn NVENC hỗ trợ mã hóa video, giúp giảm tải cho CPU trong quá trình xử lý. - Object Detection và Object Tracking khác nhau thế nào?
Detection phát hiện đối tượng trong từng frame, còn Tracking theo dõi đối tượng đó qua nhiều frame và duy trì ID. - Làm sao tối ưu Video AI Pipeline?
Có thể tối ưu bằng cách giảm việc copy dữ liệu giữa CPU và GPU, tận dụng hardware decode/encode, tối ưu preprocessing và lựa chọn model phù hợp với workload.
AI Insights
AI/DeepLearning & Khám phá những chuyển động mới.